Tecnología · GUÍA PRÁCTICA
¿systemd status=219/CGROUP? Lee la operación cgroup fallida antes de cambiar la delegación
El código nombra una etapa, no una solución. Conserva verbo, errno y ruta del journal; mapea gestor y jerarquía; corrige un límite de propiedad y demuestra un arranque limpio.
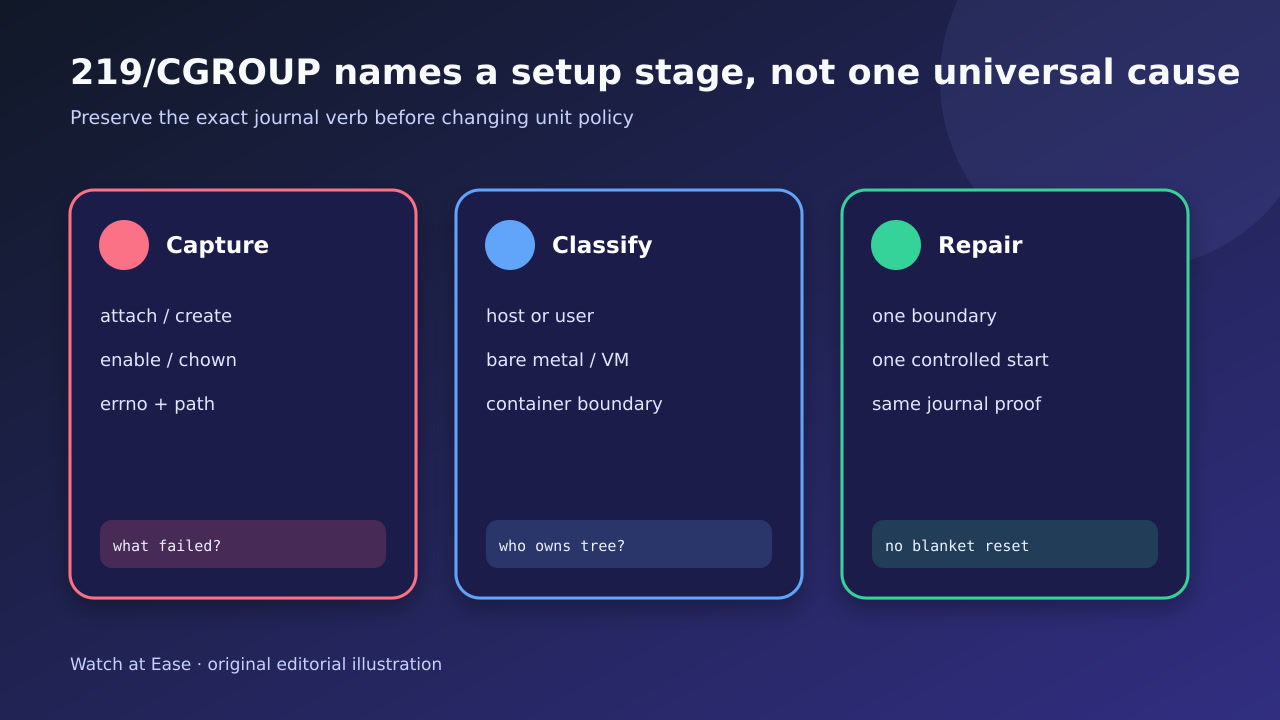
El código nombra una etapa, no una solución. Conserva verbo, errno y ruta del journal; mapea gestor y jerarquía; corrige un límite de propiedad y demuestra un arranque limpio.
El estado 219 significa que systemd falló al preparar el grupo de control del servicio; no identifica una causa única.
1. Congela la primera línea CGROUP
Guarda systemctl status y el journal completo alrededor del primer fallo antes de reset-failed, reiniciar, reboot o cambiar permisos. Crear, adjuntar, habilitar, migrar y cambiar propietario son ramas diferentes.
Registra errno y la ruta cgroup completa. La línea final status=219/CGROUP solo nombra la etapa; el mensaje previo del gestor aporta objeto y operación que la reparación debe explicar.
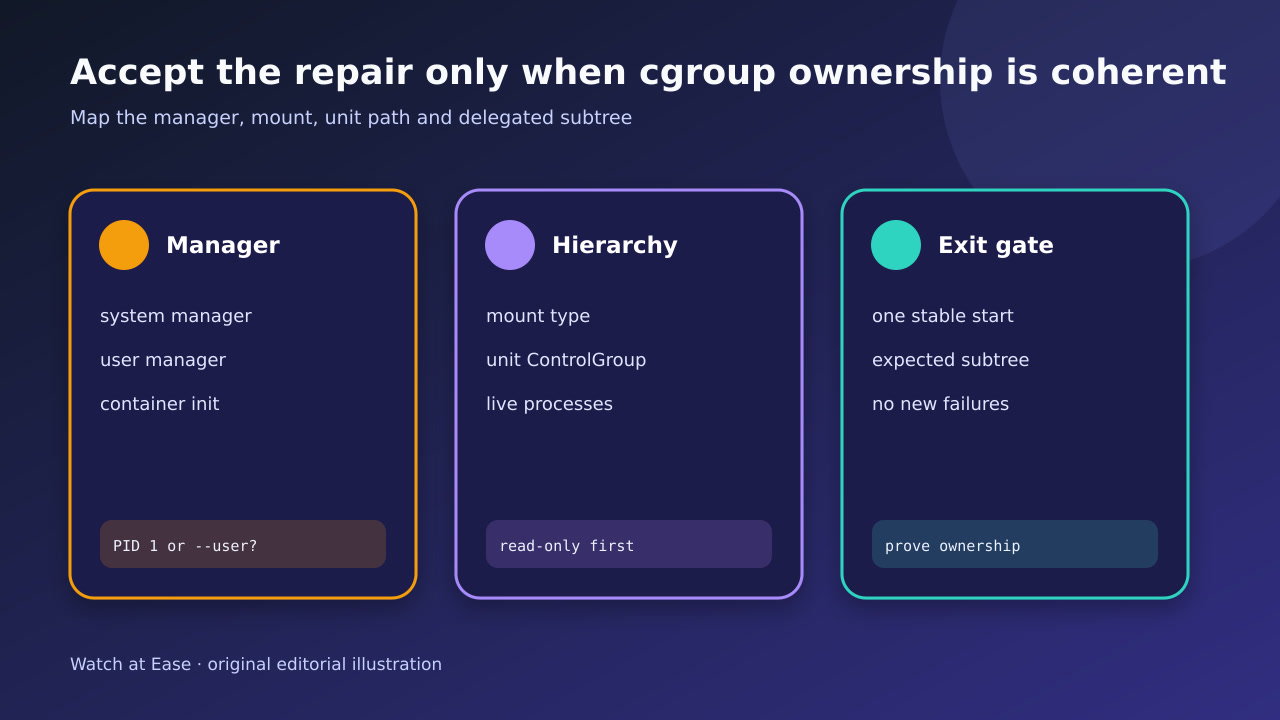
2. Identifica el gestor responsable
Determina si la unidad pertenece a PID 1, systemctl --user, init de contenedor o un gestor anidado. Registra versión, kernel, virtualización y si el mismo UID o unidad funciona fuera de ese límite.
No supongas que el proceso de servicio causó el error: quizá no se ejecutó. Relaciona la propiedad ControlGroup con el gestor que intentó crearla o adjuntarla.
3. Mapea la jerarquía en solo lectura
Lee mountinfo o findmnt para /sys/fs/cgroup, tipo, controladores, propiedades de systemctl show y systemd-cgls. Enumera procesos vivos bajo la unidad o padre sin moverlos ni terminarlos.
Crea un registro de propiedad: el gestor host posee el árbol sobre una unidad delegada; el delegado solo su subárbol. En cgroup v2, procesos restantes o cambios manuales pueden bloquear el siguiente inicio.
4. Clasifica la rama de reparación
Separa por evidencia. ENOENT puede ser jerarquía o montaje ausente; EROFS un límite de solo lectura; EACCES/EPERM propiedad o delegación; EBUSY procesos vivos o estado incompatible. Verifica restricciones de proveedor y contenedor antes de editar.
Cambia un solo límite. Evita chmod/chown recursivo, Delegate=yes general, desactivar controles o borrar directorios cgroup. Si la unidad posee subgrupos, detén y contabiliza procesos antes de tocar controladores o reinicio.
5. Demuestra un arranque controlado
Inicia una vez bajo observación y vuelve a leer status, journal, ControlGroup y systemd-cgls. Verifica ruta, propiedad, controladores, salud y ausencia de un nuevo 219.
Si la reparación exige reboot, cambio del host o actualización del proveedor, dilo y conserva evidencia antes/después. No llames permanente a un reintento temporal sin explicar la operación original.