テクノロジー · ニュース解説
Reflection、Beamのプレビューを開始 モデルの重みは10月中に公開予定
コーディングとエージェント型の作業を想定したモデルだ。利用の可否と効率に関する主張では、確認に必要な根拠が異なる。
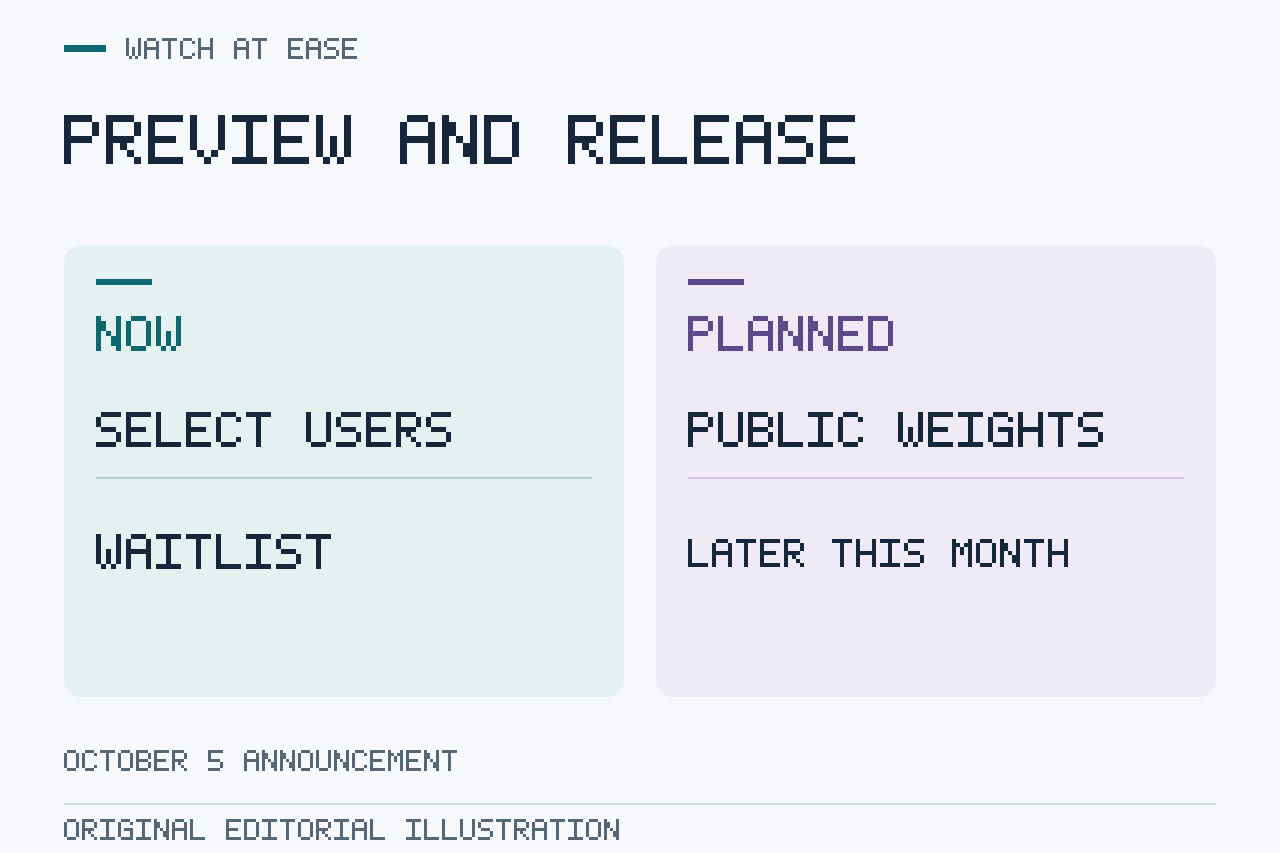
Reflectionは10月5日、同社初のAIモデル「Beam」を発表した。利用するモデルをより自在に管理したい企業向けに打ち出している。
プレビューは現在提供、重みの公開は後日
初期版は選ばれたユーザーに提供されており、利用待機リストへの登録も受け付けている。Reflectionは今月中にモデルの重みと関連資料を公開する計画で、モデルの重みはApache 2.0ライセンスで提供する予定だ。
待機リストへの登録は、利用を申し込むことを意味する。ダウンロードが完了したわけではなく、ライセンスの提供が予告されていても、ファイルがすでに入手できることにはならない。
二つの数値が示すもの
Reflectionが示す総パラメーター数は5,010億で、1トークン当たりのアクティブパラメーター数は230億だ。
パラメーター数はモデルを説明する数値であり、メモリーの仕様ではない。小さいほうの数値を必要なハードウェアの条件とみなすと、システム全体を運用するために何が必要かを確認するという、欠かせない手順を飛ばしてしまう。
推定値と実際の費用の違い
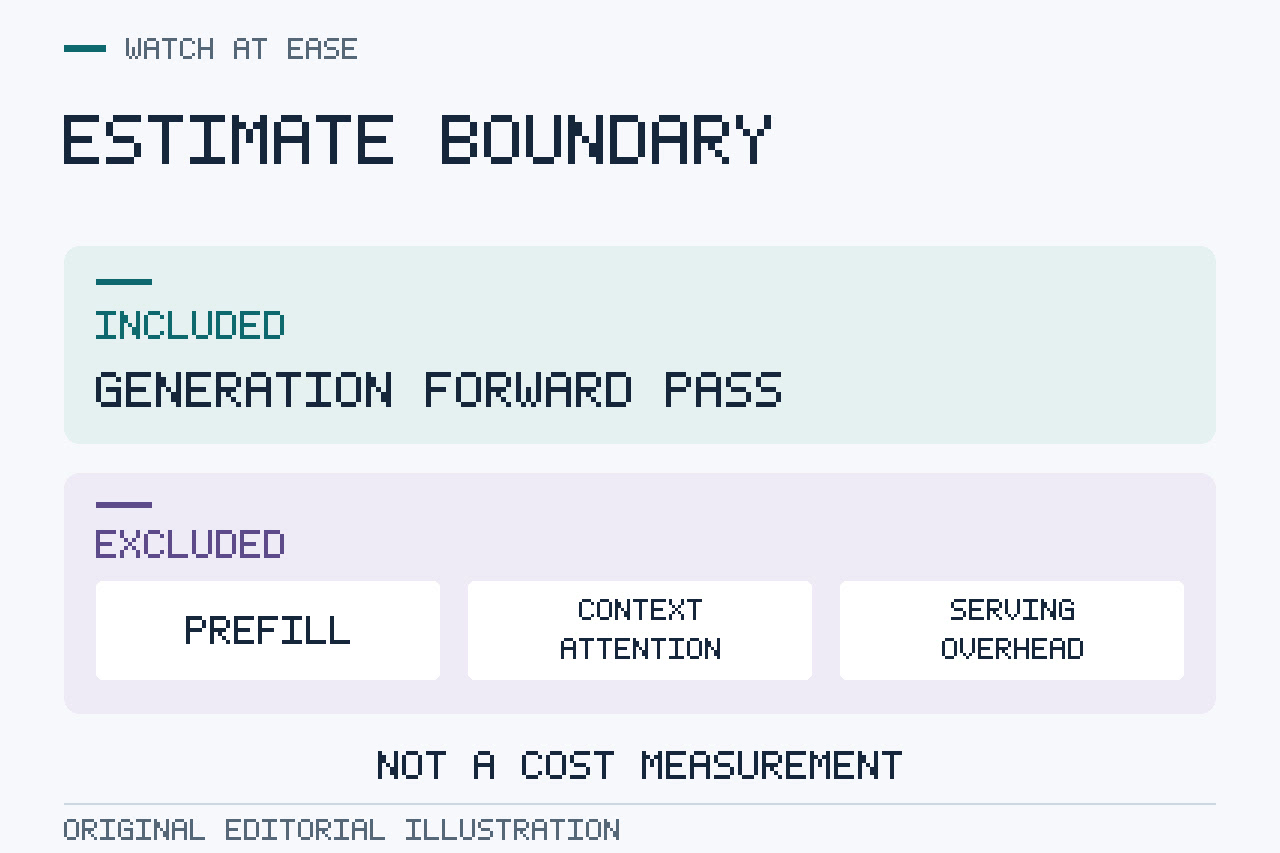
同社の比較では、アクティブパラメーター数と生成トークン数を基に、生成時の順伝播に必要な計算量を推定している。プリフィル、コンテキストに応じて変わるアテンション演算、推論サービスを提供する際のオーバーヘッドは含まれていない。
コストを比較するうえで役立つ問いは、一連の処理全体を実行するのにいくらかかるかだ。対象を絞った推定値では、含まれていない運用情報がなければ、その問いに答えられない。
なお確認が必要なこと
Semaforによると、ReflectionはBeamを、コーディングとエージェント型のタスクを担う主力モデルとして位置付けている。これは開発元の売り込みであり、独立したテストの結果ではない。
評価するには、まず利用できることが前提となり、能力と運用費にはそれぞれ別の根拠が必要だ。モデルの発表は想定用途を説明できるが、それだけで成果を実証するものではない。