科技 · 实用指南
pandas CSV 编号设为字符串仍变化?逐步追踪导入前后的值
四行对照实验区分数值推断、缺失值规则和已写入 CSV 的损失;事后转字符串无法全部修复。
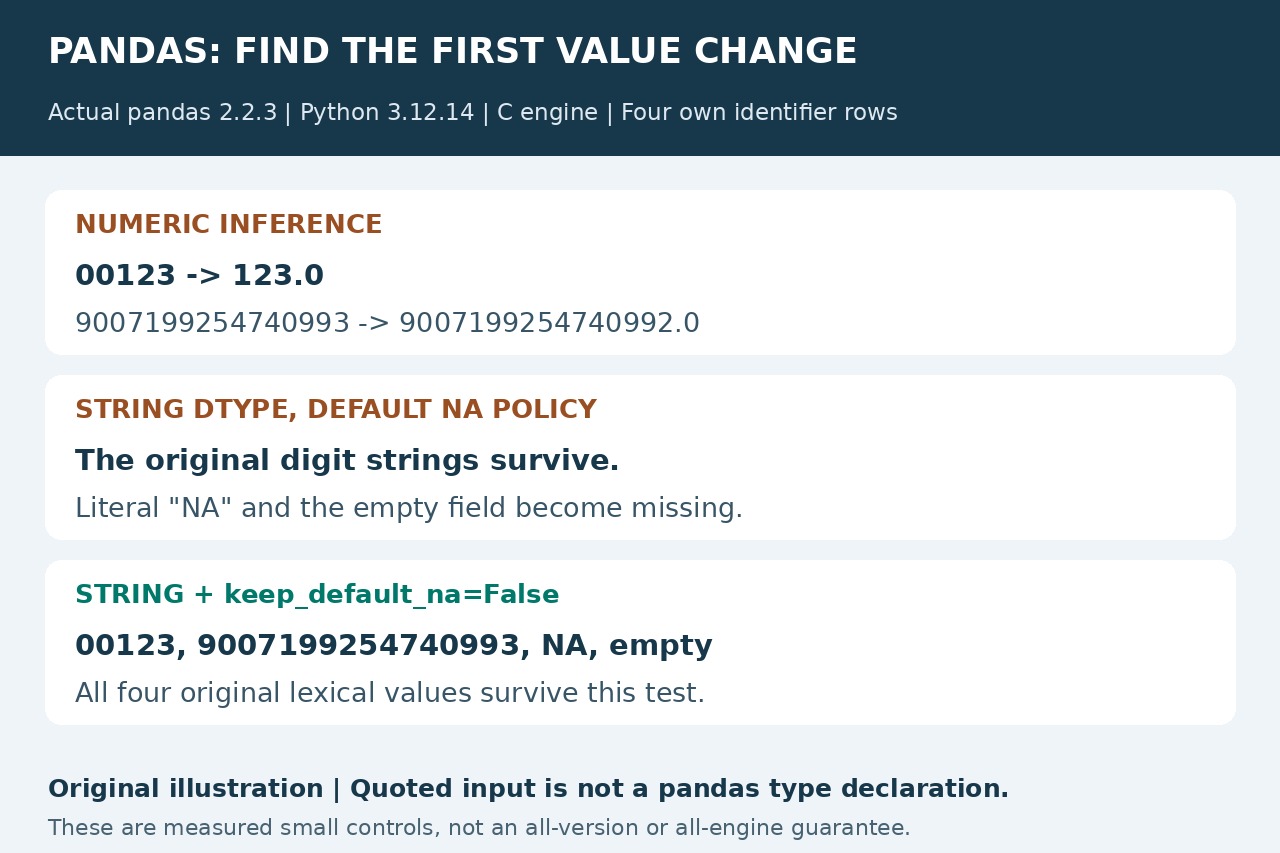
CSV 编号发生变化时,应先比较原始字段与各处理阶段的值,再考虑追加类型转换。字符串类型并不会自动关闭缺失值识别,按字符串读取已损坏的导出文件,也无法重建此前数值转换丢掉的数字。
我们用 Python 3.12.14、pandas 2.2.3 和 C 解析器测试四个已声明的编号值:00123、9007199254740993、字面文本 NA,以及空字段,13项检查通过。它们是小型受控样本,其中 NA 明确定义为文本;应用自身的缺失值规则仍须另行决定。
从原始字段和已知模式开始
保留原始CSV,记录编码、分隔符、引号规则、表头和编号列,按实际方言解析工作副本。Python的csv.reader通常返回字段字符串,不自动转为数值;建立文本基准时不要使用QUOTE_NONNUMERIC。在把字段映射为字典之前,先核对表头位置。
记录精确样本值,而不只看格式化显示。CSV引号负责划分字段,并不是pandas的类型声明。所链接的Excel指南解释表格导入中的相同原始文件边界,表头指南另行处理重复名称。文件哈希记录字节身份,但单独计算一个本地哈希,不能确定业务值是否正确。
分别设置文本类型和缺失值策略
先import pandas as pd,测试中使用pd.read_csv('input.csv', engine='c', dtype={'id': 'string'}, keep_default_na=False)。在已知UTF-8样本里,它保留了00123、精确的大编号、字面NA与空字符串;仅设置string时,数字虽保留,后两项仍变成缺失值。
keep_default_na=False影响本次读取的缺失标记识别,不只影响id列。它在这里用于检查原始文本,不代表所有列的空白都有效。应依据提供方的模式,逐列规定缺失标记与类型,再验证这些规则。不要为了消除报错,随意将缺失值变成零或字面文本'nan'。
确认损失是否早于当前读取器
我们的63字节输入给所有字段都加了引号。默认数值读取将编号列推断为float64,之后转成string得到123.0和9007199254740992.0。将这组推断值另存CSV时,改变后的数字被写入文件,原来的字面NA和空字段也都写成空字段。
再次用明确的字符串设置读取这个受损CSV,只会保留其中已经受损的文本;当前读取器不再是首次丢失点。该文件与正确保留值的导出文件恰好都是43字节,行列数量也一致。因此在这些样本中,大小和形状相同并不证明值相等。
另存后与原始值逐项比较
写入新目标,并用相同的已声明模式重新解析。将有序编号字符串及缺失值区别与原始文件比较,核对记录数,并调查编号碰撞或值变化。正确保留的往返测试留下全部四个值;由于引号形式改变,字节表示由63变成43字节,原始字节完全相等并不是合适的语义验收标准。
如果目前最早的CSV已包含舍入或缩短的编号,应向权威提供方获取新导出,或回到更早保留的源文件。补零或对显示出来的浮点数取整,无法确认丢失的原编号。本文测量仅覆盖pandas 2.2.3的C引擎和四行合成数据,应用到其他环境前应复核实际部署版本与解析器。