科技 · 实用指南
pandas 给 CSV 列名加了 .1?删列前先保留位置映射
带后缀的名字既可能是 pandas 的重名处理,也可能本来就在源文件中。先读原始表头并保留位置,再重命名、筛选或删除。
不要因为 pandas 给某些列加了后缀,就删除所有以 .1 结尾的列。源文件可能本来就有合法列名 a.1。DataFrame 列名唯一,不代表原始表头也唯一。
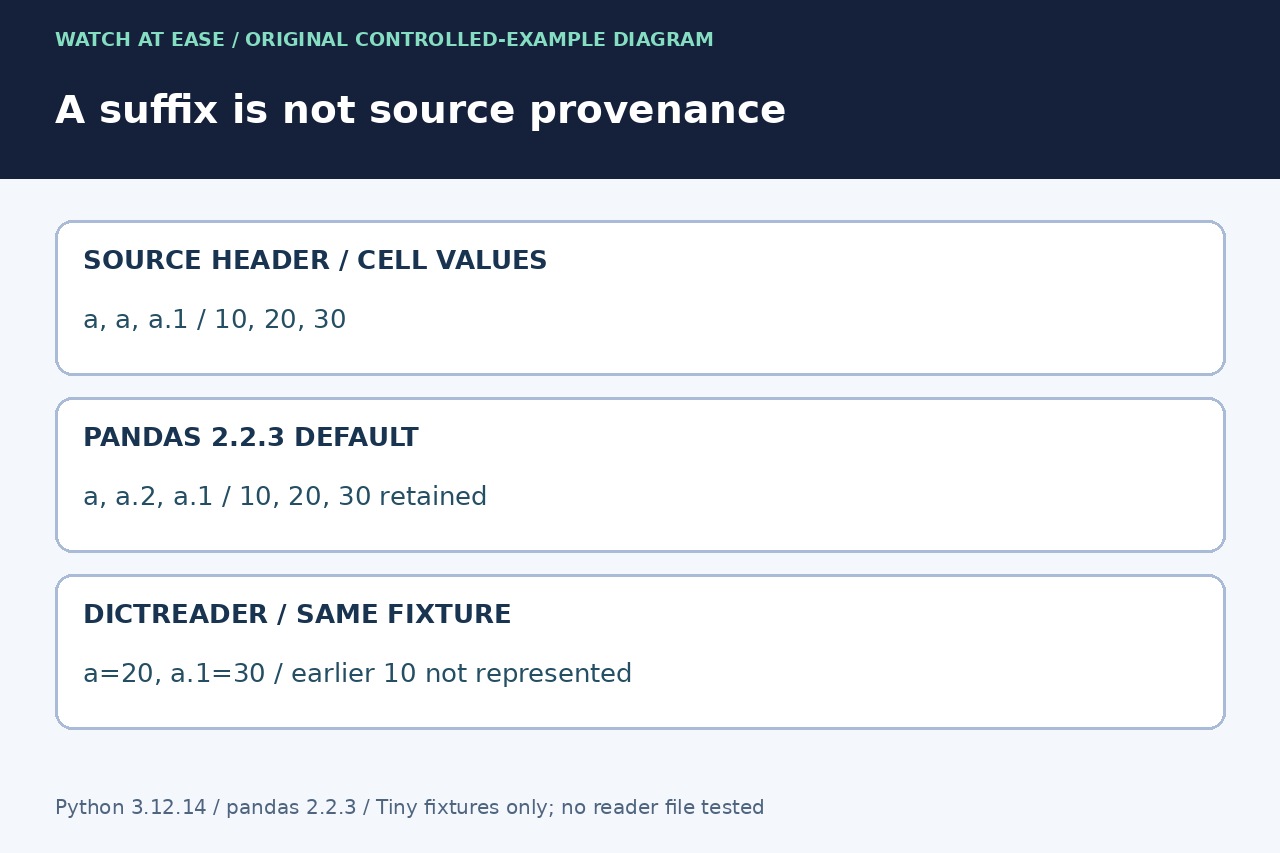
我们用 Python 3.12.14 与 pandas 2.2.3 做的小样例中,a,a,a.1 变成 a,a.2,a.1,默认导入保留了三个值;若先经过 csv.DictReader,同名 a 只保留后一个值。这是两种不同的转换。
把原始表头读成有顺序的列表
先使用 import pandas as pd。保留原 CSV 字节。本文的逗号分隔、单行表头样例可导入 csv、io,再用 header = next(csv.reader(io.StringIO(text)))。结果是保留重名的有序列表。不要只检查 pd.read_csv(..., nrows=0).columns,因为它已改过名字。
实际文件要匹配分隔符、引号、编码和表头位置。被引号包住的 "last,name" 是一个字段,不能直接按逗号拆首个物理行。有前言、注释或多行表头时,应先调整表头读取方法。
重名不等于数据重复
我们的 a,a,a.1 表头下一行是 10,20,30。默认列名变成 a,a.2,a.1:源文件第三个字段本来叫 a.1,第二个 a 才得到 a.2。去掉后缀或按点加数字删列,会破坏这个区别。
重复名字不能证明值相同。该样例的 csv.DictReader 得到 a='20'、a.1='30',字典中已没有前面的 10。如果上游字典转换丢了字段,应回到原 CSV,不能指望修改 pandas 列名恢复值。
给每个位置分配唯一内部名
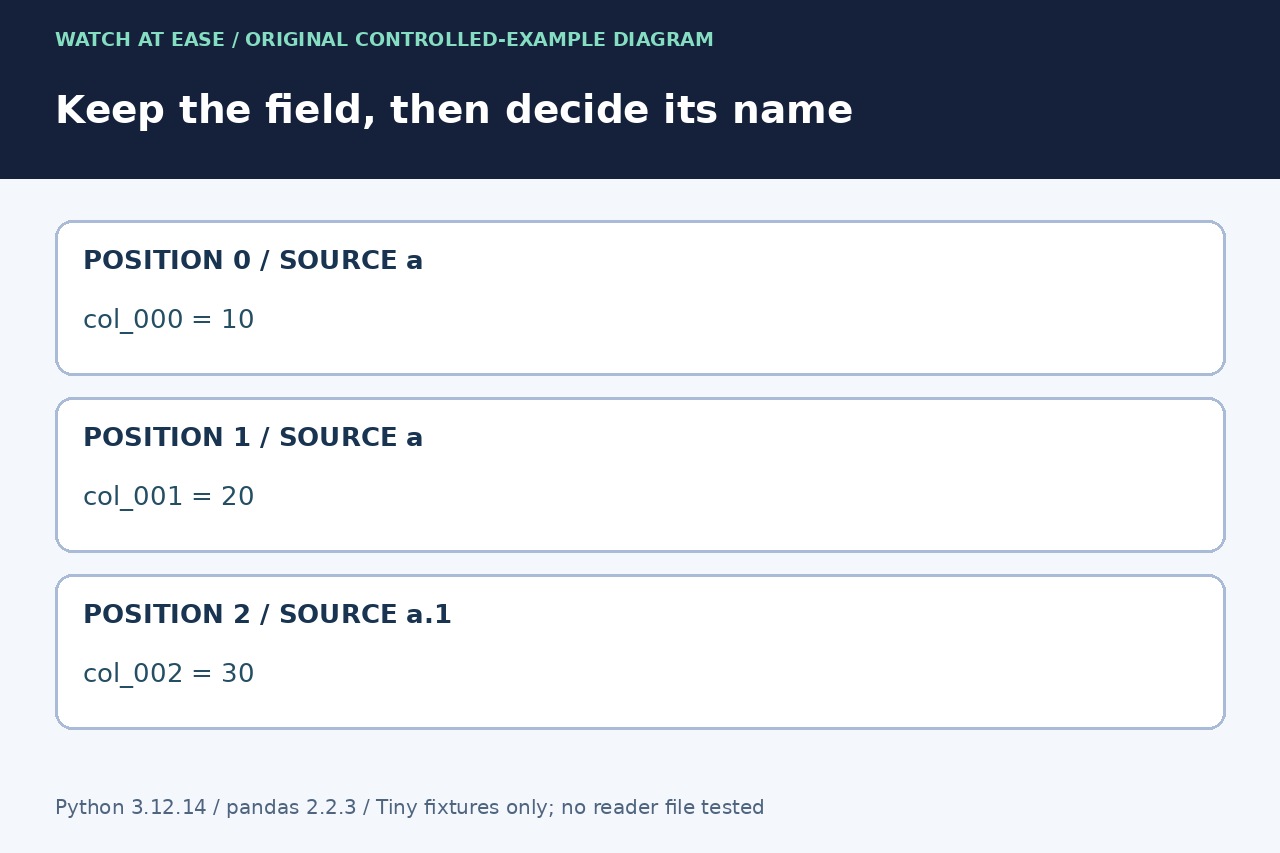
对本文这种单行表头的受控 CSV,可建立 internal = [f'col_{i:03d}' for i in range(len(header))],并随源文件保存 list(enumerate(zip(header, internal)))。然后读 df = pd.read_csv(io.StringIO(text), header=0, names=internal, dtype=str, keep_default_na=False)。这些标识按位置生成,无需让 pandas 接受重名。
实测 col_000、col_001、col_002 保留了 '10'、'20'、'30'。另一个首字段表头含引号逗号的样例也保留四列。字符串和缺失值设置只适合本次文本样例,应用的类型策略应另行确定;未约定时不要悄悄清理空格或 Unicode。
明确拒绝还是映射,然后核验
若接收系统要求源列名唯一,当 len(header) 与 len(set(header)) 不同就拒绝,并报告重复位置。若重名是有意设计,让数据负责人明确每个位置的含义;不要因为 pandas 的后缀方便就自行选赢家。
使用 usecols、重命名或导出前,核对字段数、映射和有差异的代表值。已安装 pandas 把 mangle_dupe_cols=False 判为未知参数,当前 API 也没有它。这里只测试小型内存样例,没有测试你的文件或 pandas 3.x;请在部署版本复核,并保留原件及映射。