科技 · 实用指南
pandas设置skip仍留下坏CSV记录?先验证记录再用usecols
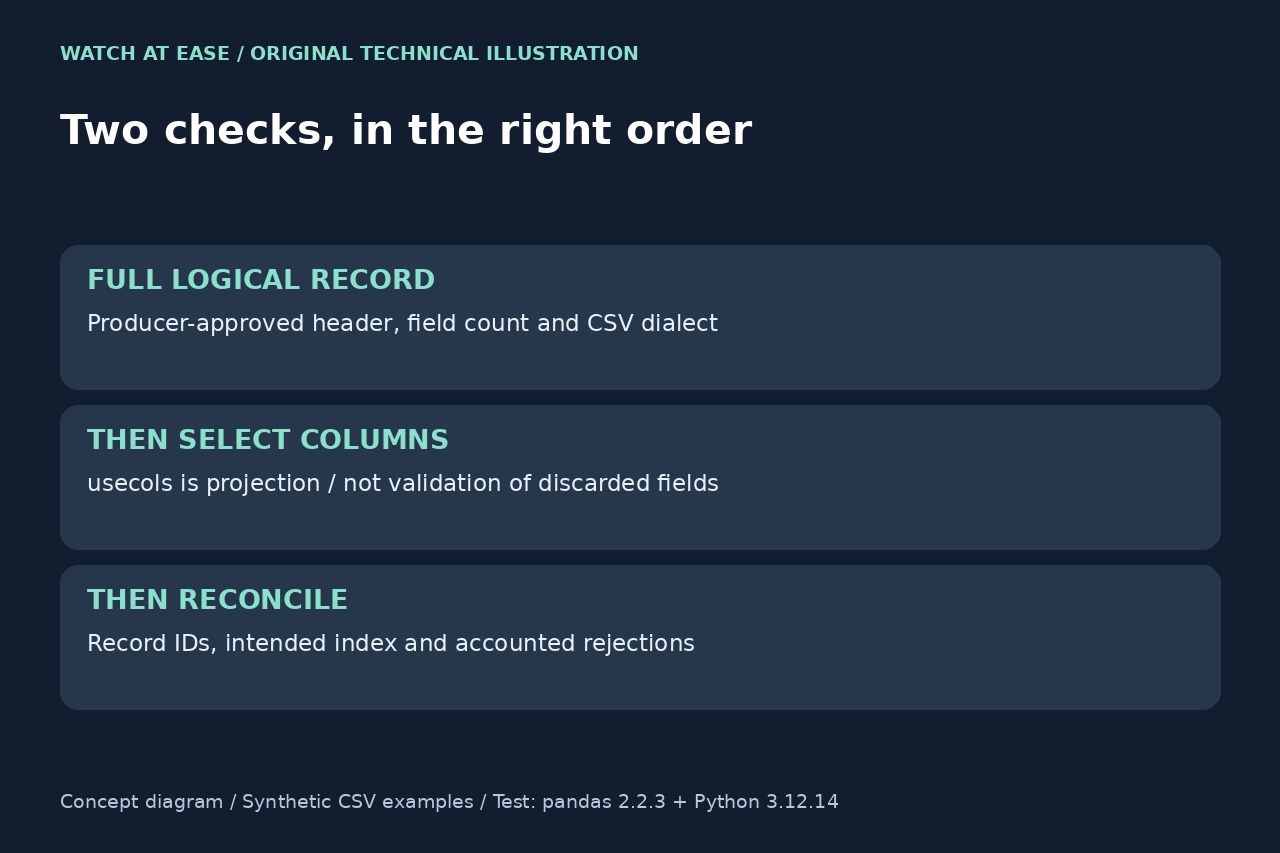
on_bad_lines是解析策略,不是完整结构验证。先在筛列前核对逻辑字段,再在读取后核对记录去向。
CSV读取不报错,仍可能留下字段不足的记录、被丢弃的额外字段或意外索引。当前read_csv文档把on_bad_lines处理的坏行定义为字段过多的行,并未保证所有不符合业务规则的记录都会消失。
分清跳过与验证
先确认导出方的分隔符、引号规则、编码与预期结构。记录pandas版本、解析引擎、header、names、index_col、usecols、空行和注释处理及坏行策略。扩展名是.csv,不能证明这些选择正确。
当前API说明warn也会跳过该行,skip则不发出对应警告。两者都不是无损修复开关。保留原文件,只有能交代被排除记录去向时,才执行明确的拒收规则。
筛列之前审计逻辑记录
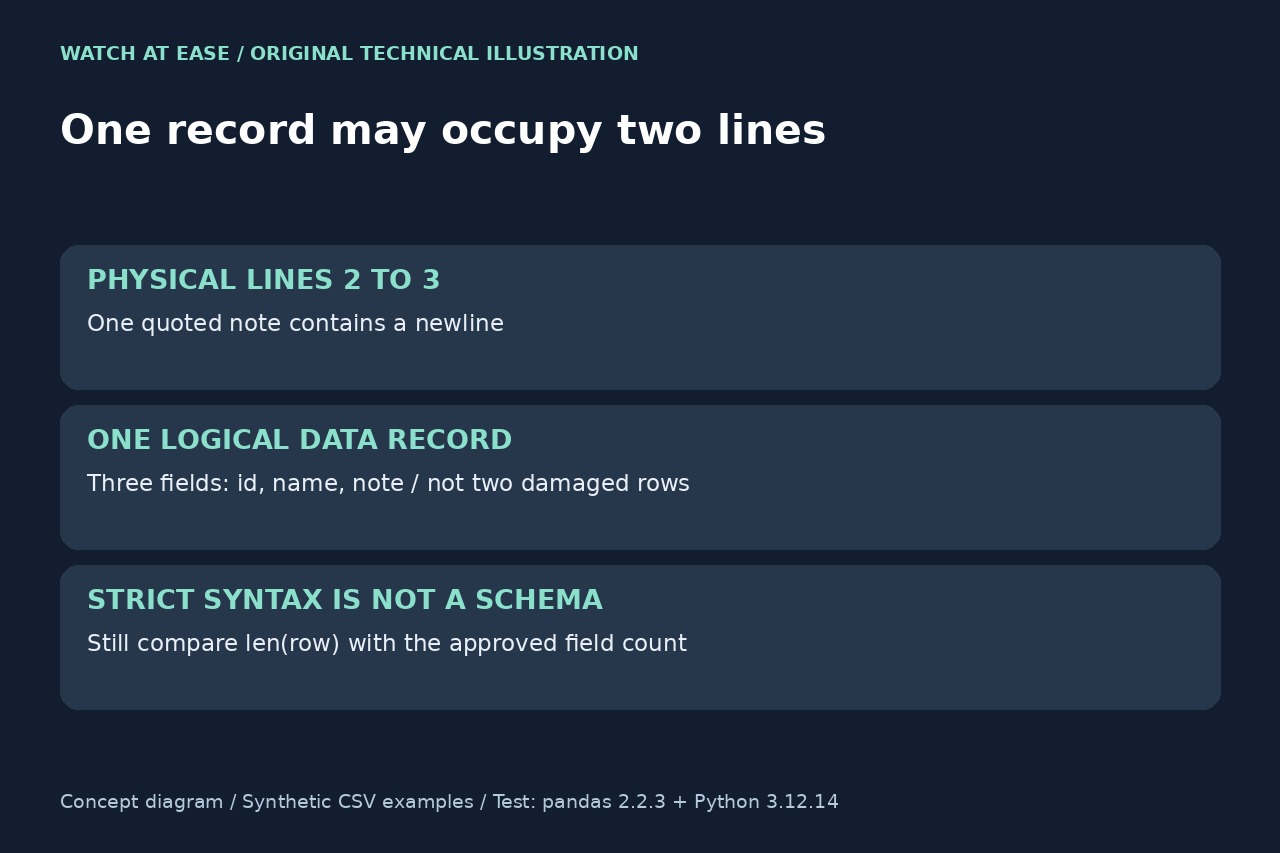
按已确认的编码和格式,以newline=''打开工作副本,使用csv.reader(..., strict=True)逐条读取。先把表头与批准的字段名比较,再对每条逻辑数据记录检查len(row)是否等于规定宽度。将不匹配记录及其源位置单独保留,不能按原始文本的逗号数判断。
strict=True检查CSV语法,并不检查业务结构。记录每条记录前后的reader.line_num来定位物理行范围;引号内换行可能使一条记录跨多行。比较数量前先统一空行、注释规则;解析失败时应停止,不能猜测记录边界。
四组受控样例说明陷阱
我们在pandas 2.2.3、Python 3.12.14中测试合成的三列CSV。后续出现四字段记录时默认报ParserError,skip将其删除;加入usecols后却保留该记录并丢弃额外字段。两字段记录则留下缺失值。这仅是所装环境的结果,并非对当前pandas 3.0.6的运行测试。
首条数据记录有四字段时,默认读取推断索引并移位;index_col=False返回三列,但发出数据丢失警告,并没有修好记录。另一份带引号的多行字段样例中,一条有效三字段记录跨两个物理行。没有一个开关能为全部四种情况背书。
只做能核验的修复
若格式或表头选择错了,在副本上改正读取设置。记录确实损坏时,应取得正确导出,或按明确规则隔离。不要盲删最后一个字段:意外分隔符可能在中间拆开了有意义的值。
读取后检查目标列顺序、索引、必需标识、重复项及业务约束。按相同过滤规则,把接受与拒收的逻辑记录数对回源审计。字段数相同只是结构证据,不能证明值含义正确,也不能证明筛列后的DataFrame保留了全部源信息。