Tecnología · GUÍA PRÁCTICA
¿Cambian los ID del CSV en pandas pese al tipo string? Sigue el valor antes y después de leer
Cuatro filas separan inferencia numérica, reglas de valores ausentes y daños ya escritos en el CSV. Convertir después a texto no lo recupera todo.
Cuando cambien identificadores de un CSV, compara los campos intactos con cada etapa antes de añadir otra conversión. Un tipo string no desactiva automáticamente la detección de ausencias, y leer como texto una exportación dañada no reconstruye los dígitos descartados antes por una conversión numérica.
Probamos cuatro identificadores declarados—00123, 9007199254740993, el texto literal NA y un campo vacío—con Python 3.12.14, pandas 2.2.3 y el analizador C. Pasaron 13 comprobaciones. Son controles pequeños con NA definido como texto; la política de ausencias de tu aplicación necesita una decisión aparte.
Empieza por los campos intactos y un esquema conocido
Conserva el CSV original y registra codificación, delimitador, comillas, cabecera y columnas identificadoras. Analiza una copia con el dialecto real. csv.reader de Python normalmente devuelve cadenas sin conversión numérica automática; evita QUOTE_NONNUMERIC al crear la referencia textual. Comprueba las posiciones de cabecera antes de asociar campos a diccionarios.
Registra valores exactos, no solo una visualización formateada. Las comillas CSV delimitan campos; no declaran un tipo para pandas. La guía de Excel enlazada explica esa misma frontera del original en hojas de cálculo, y la guía de cabeceras trata las etiquetas repetidas por separado. Un hash registra identidad de bytes, pero un hash local por sí solo no establece los valores correctos del negocio.
Configura por separado el tipo de texto y las ausencias
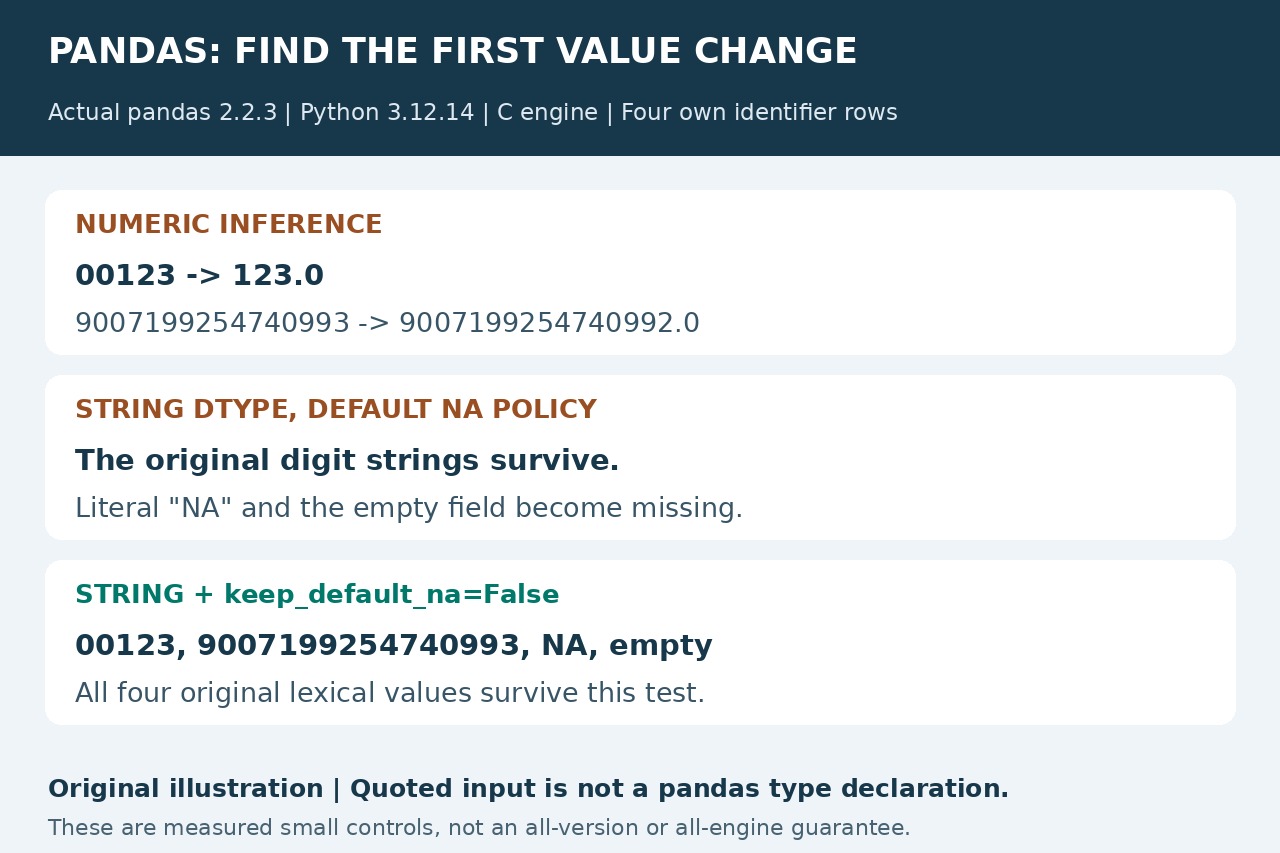
Después de import pandas as pd, la lectura probada fue pd.read_csv('input.csv', engine='c', dtype={'id': 'string'}, keep_default_na=False). En el control UTF-8 conocido conservó 00123, el identificador grande exacto, NA literal y la cadena vacía. Solo string mantuvo los dígitos, pero convirtió los otros dos valores en ausencias.
keep_default_na=False afecta a la interpretación de ausencias en toda la lectura, no solo en id. Aquí sirve para inspeccionar el texto original, no para declarar válidos todos los blancos de todas las columnas. Define tokens ausentes y tipos por columna con el esquema del productor y valídalos. No conviertas ausencias en cero o en el texto 'nan' solo para evitar un error.
Busca si la pérdida precede al lector actual
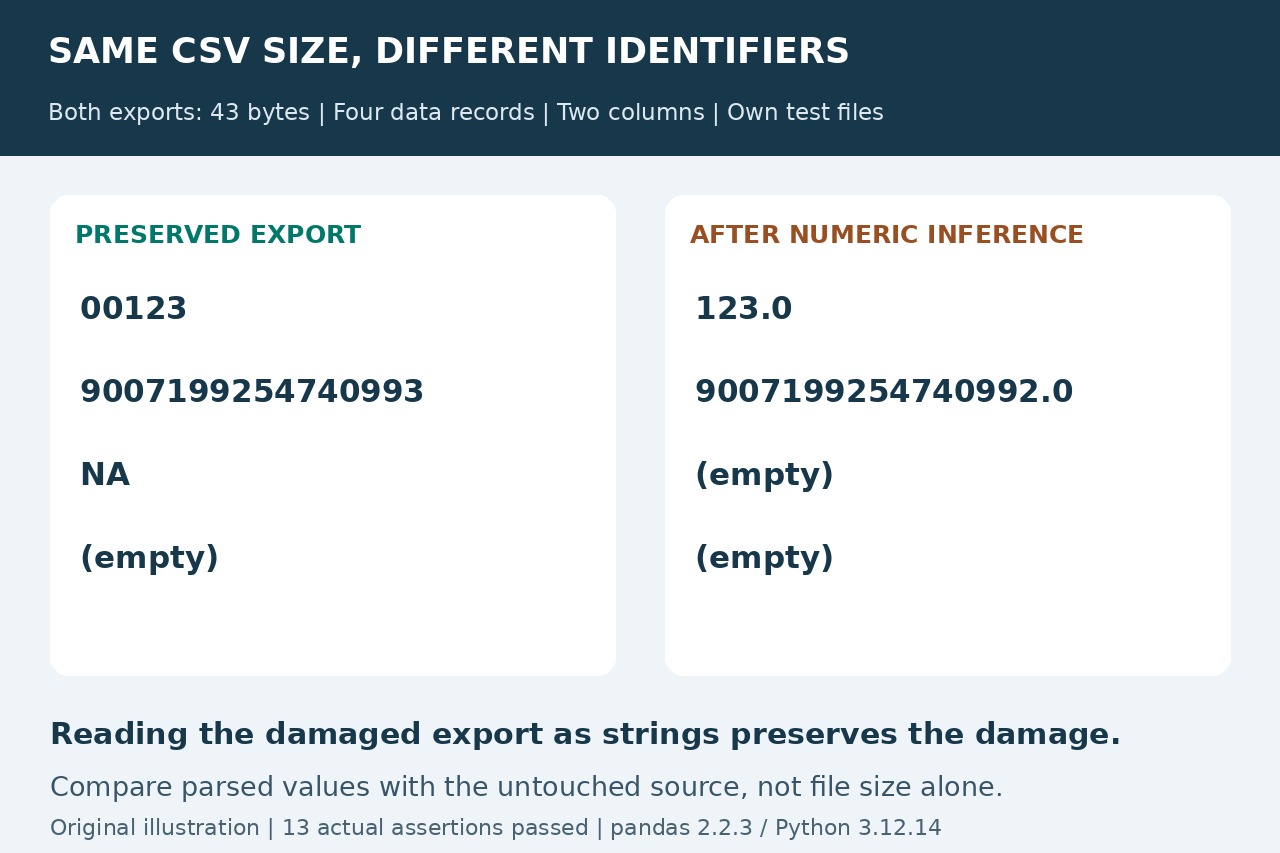
El archivo de entrada de 63 bytes llevaba todos los campos entre comillas. La lectura numérica predeterminada produjo identificadores float64; convertirlos después a string dio 123.0 y 9007199254740992.0. Exportarlos escribió esos dígitos modificados en otro CSV y convirtió tanto NA literal como el vacío original en campos vacíos.
Volver a leer ese CSV con la configuración explícita de texto conservó el texto ya dañado: el lector actual no era el primer punto de pérdida. Esa exportación y la correctamente conservada tenían por casualidad 43 bytes y el mismo número de filas y columnas. En estos controles, igual tamaño y forma no demostraron igualdad de valores.
Verifica una copia de ida y vuelta contra los valores originales
Escribe en un destino nuevo y vuelve a analizar con el mismo esquema declarado. Compara los identificadores ordenados y las distinciones de ausencias con el original; concilia registros e investiga colisiones o cambios. La ruta conservada mantuvo los cuatro valores. Su representación pasó de 63 a 43 bytes al cambiar las comillas, por lo que exigir igualdad de bytes no era la prueba semántica adecuada.
Si el CSV más antiguo disponible ya contiene identificadores redondeados o acortados, vuelve a una exportación fiable del productor o a una fuente anterior conservada. Rellenar ceros o redondear un flotante mostrado no identifica el original perdido. Estas mediciones cubren el motor C de pandas 2.2.3 con cuatro filas sintéticas; verifica la versión y el analizador desplegados antes de trasladarlas a otro entorno.