Tecnología · GUÍA PRÁCTICA
¿pandas añadió .1 a las cabeceras CSV? Conserva posiciones antes de borrar columnas
Un sufijo puede ser una corrección de pandas o un nombre original. Lee la cabecera y guarda su posición antes de renombrar, seleccionar o eliminar campos.
No borres todas las columnas terminadas en .1 porque pandas añadió sufijos en algún lugar. El archivo puede contener un nombre legítimo como a.1. Que el DataFrame tenga etiquetas únicas no demuestra que la cabecera original fuera única.
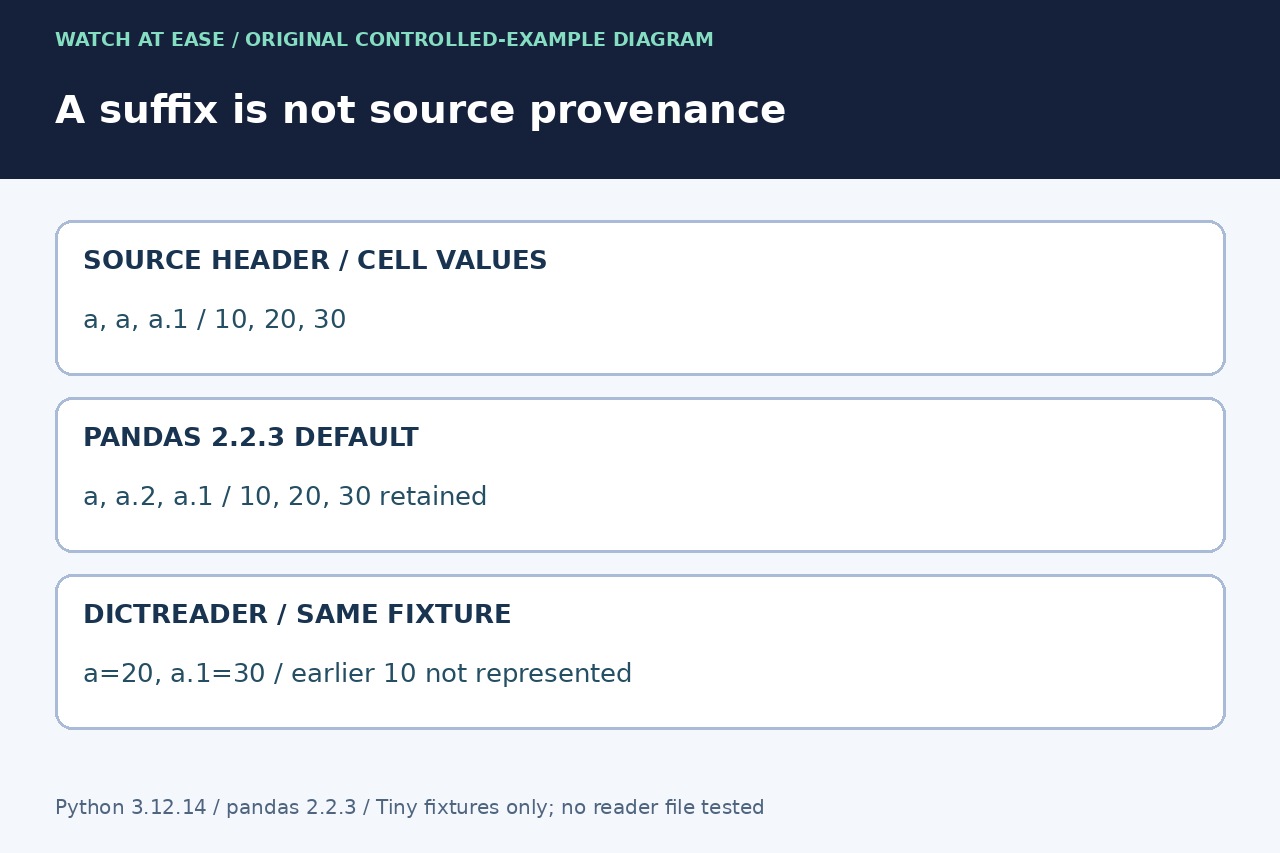
En nuestra prueba pequeña con Python 3.12.14 y pandas 2.2.3, a,a,a.1 pasó a ser a,a.2,a.1 y conservó los tres valores. Al pasar primero por csv.DictReader solo quedó el valor posterior para la clave a repetida. Son transformaciones distintas.
Lee la cabecera original como una secuencia
Importa pandas con import pandas as pd. Conserva los bytes del CSV. Para nuestros ejemplos separados por comas y con una sola cabecera, importa csv e io y usa header = next(csv.reader(io.StringIO(text))). Obtendrás una lista ordenada que conserva nombres repetidos. pd.read_csv(..., nrows=0).columns ya muestra nombres modificados.
Adapta delimitador, comillas, codificación y posición de cabecera al archivo real. El campo entrecomillado "last,name" es un solo nombre: dividir la primera línea física por comas no es analizar CSV. Los preámbulos, comentarios y cabeceras múltiples necesitan su propio procedimiento.
Separa nombres duplicados de datos duplicados
Nuestro ejemplo contenía a,a,a.1 y después 10,20,30. En a,a.2,a.1, el tercer campo ya se llamaba a.1 y el segundo a recibió a.2. Quitar sufijos o borrar por un patrón de punto y número destruye esa distinción.
Un nombre repetido no demuestra valores iguales. DictReader devolvió a='20' y a.1='30', sin representar el 10 anterior. Si una conversión previa a diccionario perdió el campo, vuelve al CSV original: renombrar columnas de pandas no puede reconstruir ese valor.
Asigna un nombre interno único a cada posición
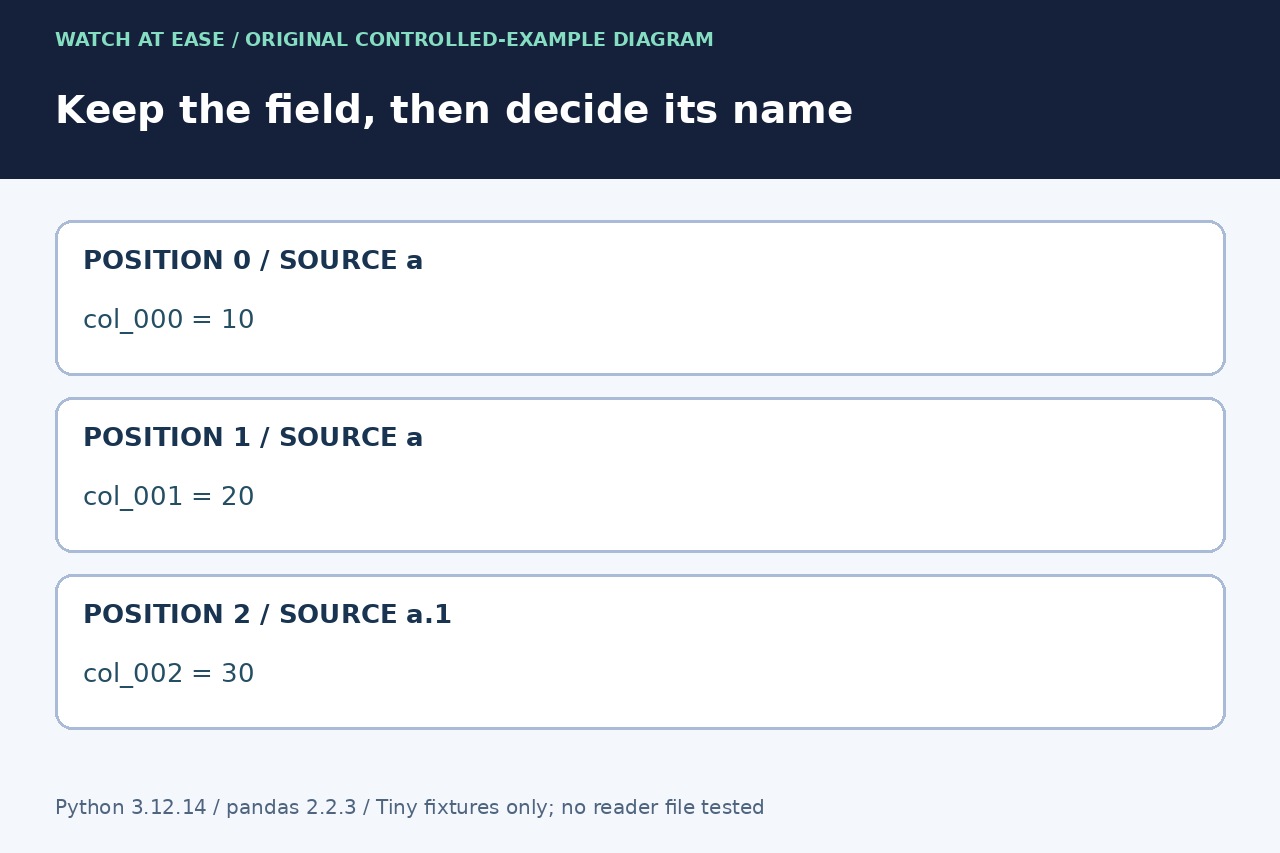
Para este CSV controlado de una cabecera, crea internal = [f'col_{i:03d}' for i in range(len(header))] y conserva list(enumerate(zip(header, internal))). Después lee df = pd.read_csv(io.StringIO(text), header=0, names=internal, dtype=str, keep_default_na=False). Así cada posición tiene un identificador único.
En la prueba, col_000, col_001 y col_002 conservaron '10', '20' y '30'. Otro ejemplo con una coma entrecomillada en la cabecera preservó cuatro campos. Las opciones de texto y valores ausentes son para esos ejemplos; acuerda por separado los tipos reales. No normalices espacios o Unicode sin una regla de esquema.
Elige rechazo o un mapa explícito y verifica
Si el receptor exige nombres originales únicos, rechaza la entrada cuando len(header) difiera de len(set(header)) e informa de las posiciones repetidas. Si la repetición es deliberada, el responsable de los datos debe aprobar el significado de cada posición; los sufijos no deciden qué valor conservar.
Antes de usecols, renombrado o exportación, verifica número de campos, mapa y valores representativos distintos. La versión instalada rechazó mangle_dupe_cols=False y la API actual tampoco lo incluye. Solo probamos ejemplos en memoria, no tu archivo ni pandas 3.x. Comprueba tu versión de producción y conserva original y mapa.