科技 · 實用指南
Python UnicodeDecodeError:invalid start byte?先保留原始位元組,再選編碼
例外只說明目前解碼器失敗,不會告訴你該猜哪種編碼。先保存輸入、區分文字與二進位、核實產生端約定,再嚴格解碼。
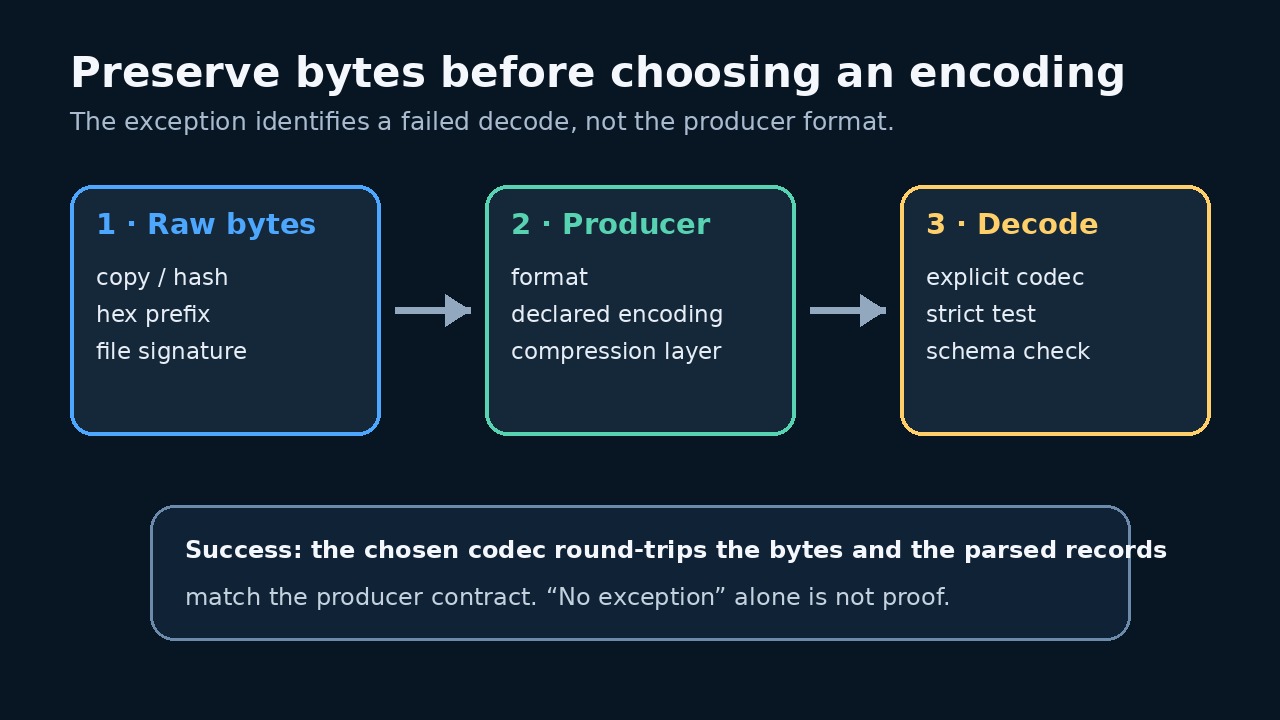
invalid start byte 是一次解碼失敗,不是改用 latin-1 或忽略錯誤的指令。先保存原始位元組,並查明產生端、容器與通訊協定。
凍結原始位元組與失敗脈絡
在編輯器開啟之前,先複製原檔或記錄雜湊。用二進位模式讀取小樣本,並記錄來源命令、檔案大小、開頭位元組、失敗偏移、Python版本與確切編碼名。編輯器、試算表匯入器或管線可能已改變換行或替換位元組,因此要診斷最早的未修改副本。
UnicodeDecodeError 只表示所選解碼器拒絕某段位元組。它不是編碼偵測器。同一位元組可能對UTF-8無效、在另一種有文件依據的編碼中有效、屬於ZIP或影像標頭,也可能代表傳輸遭截斷。
先判斷負載是否為文字
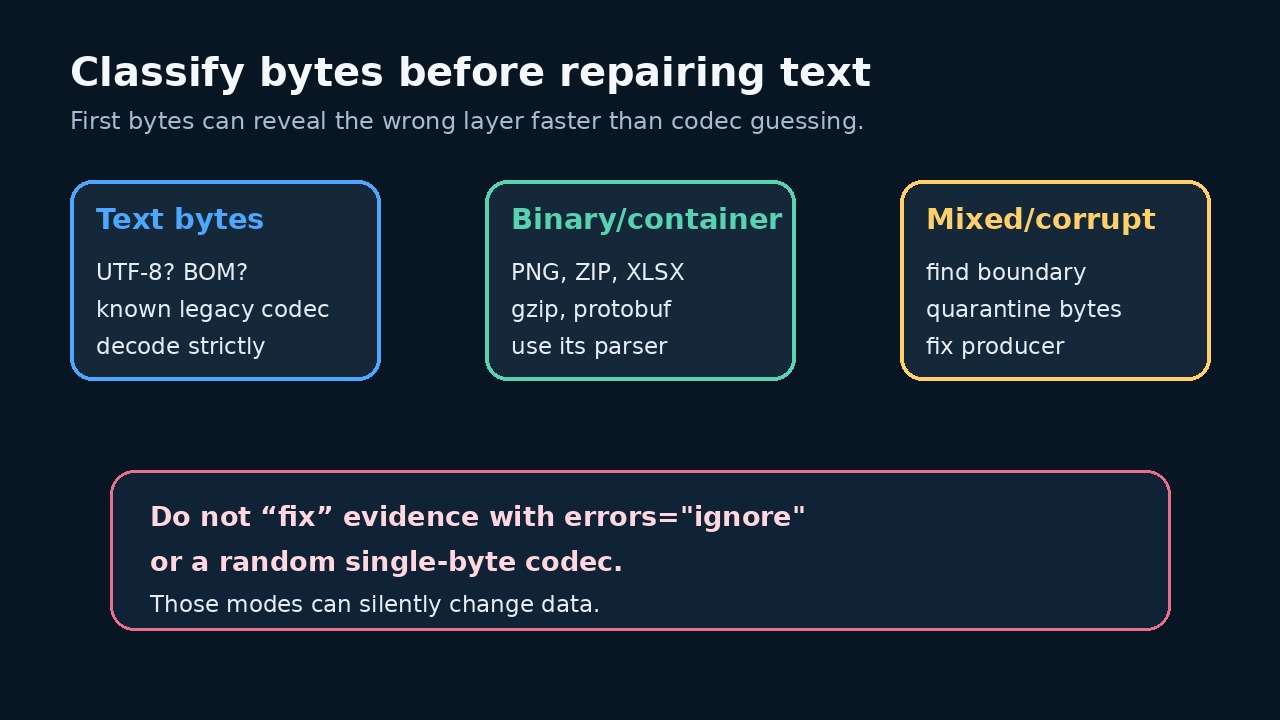
嘗試編碼前先核對產生端與容器。魔術位元組、已知封裝、壓縮輸出、XLSX套件、影像或二進位協定都應先交給對應解析器。改副檔名或把容器位元組當文字解碼,無法揭露內部記錄。
若產生端承諾文字輸出,應從協定、匯出選項、HTTP標頭、資料庫驅動程式或命令文件取得明確編碼。BOM可支援某些Unicode編碼判斷,但缺少BOM不能識別編碼;出現BOM時也要使用合適的編解碼器。
只嚴格測試有證據支持的一種編碼
以產生端約定支持的唯一編碼,先解碼保存的樣本,再解碼完整資料流。確認正確性時維持errors=strict。成功解碼只是必要條件;還要驗證分隔符、記錄數、必填欄位與業務規則,因為寬鬆的單位元組編碼能映射每個值,卻不證明文字正確。
若嚴格解碼失敗,將偏移與原始位元組及上游邊界比對。檔案若在多位元組序列中結束、混入其他編碼、包含二進位片段或拼接不同產生端,應重新取得或匯出。不要反覆換編碼直到不再拋錯。
錯誤處理器僅限明確目的
errors=ignore會捨棄無法解碼的資料,errors=replace會插入替代字元,兩者都會改變內容。只有明確接受損失時才可用來產生可讀預覽;這不代表來源已修好。保存原位元組、計算所有受影響區段,並分開保留有損輸出。
backslashreplace可在診斷中顯示壞位元組。surrogateescape適合受限的往返流程:無法解碼的位元組可暫存於Python字串,再以同一處理器編碼還原。兩者都不能確定原字符;必須記錄邊界,且不可送入要求有效Unicode的系統。
以可驗證轉換收尾
合格修復要明確指出產生端、容器、編碼與解析器,完整嚴格解碼輸入、驗證記錄,並寫入新檔而非覆蓋證據。保存雜湊、記錄數與隔離的位元組區段,讓另一位審閱者可重現判斷。
當來源約定未知、同檔混用編碼、二進位邊界無法重建,或替換會改變識別碼、金額、量測值與稽核欄位時,應停止並升級處理。保留不確定性,比發布看似合理卻憑空猜出的字符安全。