科技 · 實用指南
Python出現JSONDecodeError: Extra data?先確認記錄邊界再解析
第一個JSON值可能有效,但後面仍有內容。先保留原始位元組,分清單一文件、JSON Lines或連續值,再驗證完整輸入。
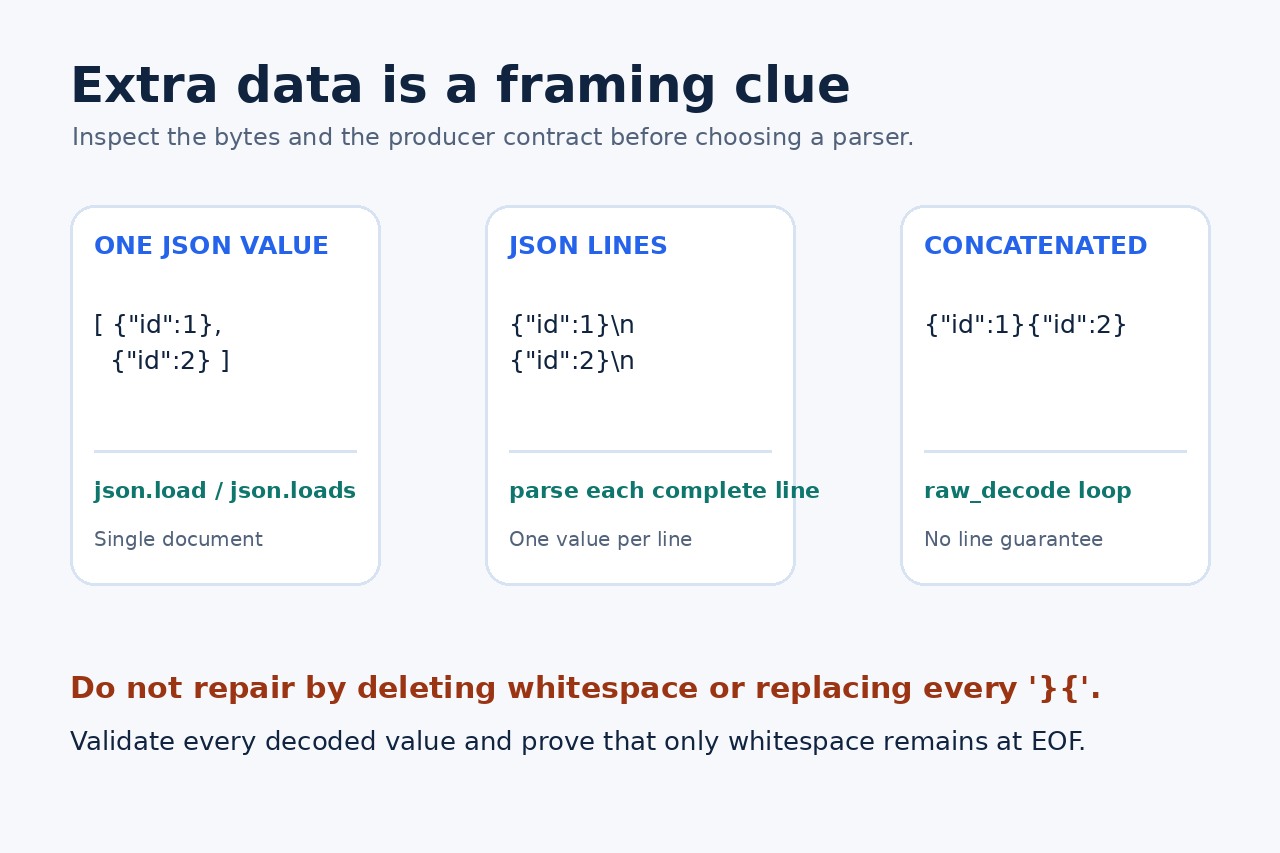
Extra data表示Python已經解出一個完整JSON值,隨後又遇到非空白內容。它本身不能證明檔案就是JSON Lines,也不能證明第二行一定是安全記錄。選擇解析器或改寫檔案前,先保存原始位元組並確認產生端的記錄邊界。
保留證據並判斷尾部形態
試驗前複製或雜湊原檔。記錄輸入編碼、是否有BOM、例外訊息、pos、lineno、colno,以及失敗位置附近的跳脫預覽。不要刪除空白、全域替換}{或直接替原文加方括號,這些做法可能改變字串、掩蓋損壞或製造分隔符。
對解碼文字使用JSONDecoder.raw_decode,找出第一個值結束的位置,再只檢查剩餘內容。若只剩空白,就是單一文件;若另一個值開始,應確認產生端承諾的是每行一個完整值、無分隔連續值,還是誤附加了無關位元組。解析器由協定決定,不由報錯行號決定。
按記錄協定選擇解析器
單一JSON文件應使用json.load或json.loads嚴格檢查;頂層物件、陣列、字串、數字、布林值或null都算一個值,無法解釋的尾部內容應繼續報錯。若你控制一個集合,單一頂層陣列是相容性最高的JSON表示。
只有每個實體行都恰好是一個完整JSON值時,才按UTF-8逐行解析JSON Lines。物件、陣列和純量都可以是記錄,但空行不可以。跨多行的格式化物件不是一條JSON Lines記錄,逐行解析會失敗。
不要猜分隔符,逐個消費連續值
當產生端確實輸出沒有固定換行邊界的連續JSON值時,可用略過空白的raw_decode循環,取得每個值及其結束字元索引。每筆記錄都要檢查預期類型或綱要,失敗時保留記錄號與起始索引,最後還要確認略過空白後精確到EOF。
raw_decode接收的是以JSON文件開頭的字串,不會自動成為有界串流讀取器。大檔案需要經過設計的緩衝方案或審閱過的串流解析器。不要全域把}{替換為},{,這些字元可能出現在字串裡,真正損壞的邊界也應明確拒絕。
把字元位置映射回位元組,並在轉換前驗收
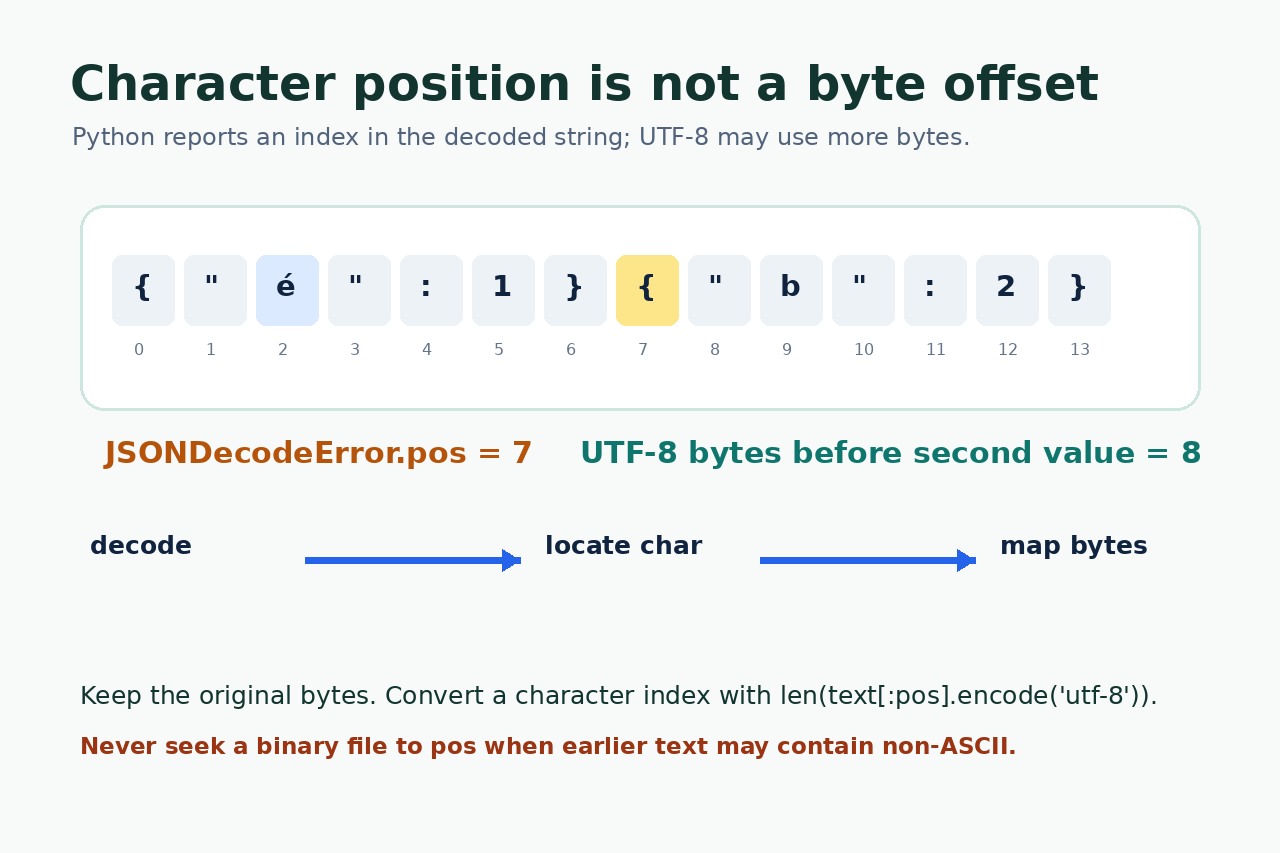
Python文件把JSONDecodeError.pos定義為doc中的起始索引,lineno和colno從解碼後的字串計算。我們的Python 3.12.14樣例中,{"é":1}{"b":2}在pos 7失敗,但第二個值之前有8個UTF-8位元組。可用len(text[:pos].encode("utf-8"))換算;前文含非ASCII時,絕不能直接把pos當二進位seek偏移。
同一測試中,真正JSON Lines在第2行第1欄報錯,緊密連續值在第1行第8欄報錯,兩個格式化物件則在第4行第1欄報錯。raw_decode能消費三種序列,而逐行方式只適用於JSON Lines。只有每個值都通過語法與業務檢查、尾部完整消費、記錄數一致後,才能把已解析物件寫到新的臨時陣列或JSON Lines檔案,並保留原檔以便回復。