科技 · 实用指南
Python UnicodeDecodeError:invalid start byte?先保留原字节,再选择编码
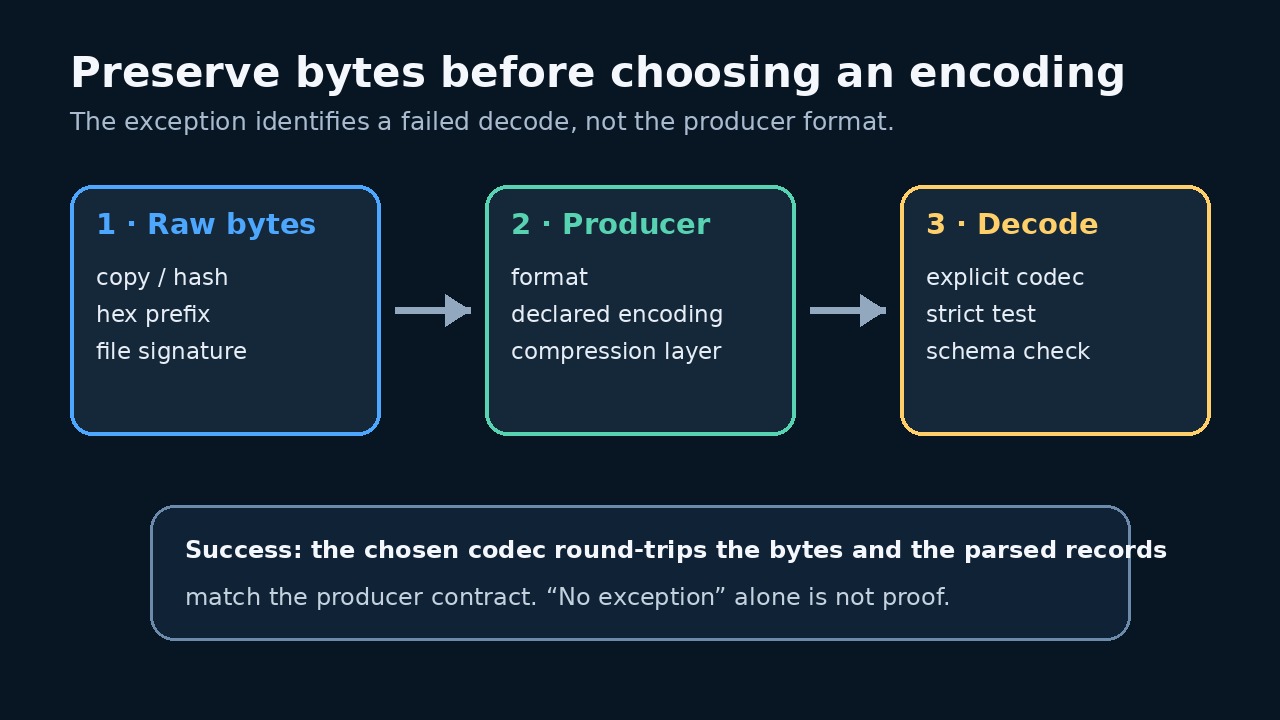
异常只说明当前解码器失败,并不会告诉你该猜哪种编码。先保留输入,区分文本与二进制,核实生产端约定,再严格解码。
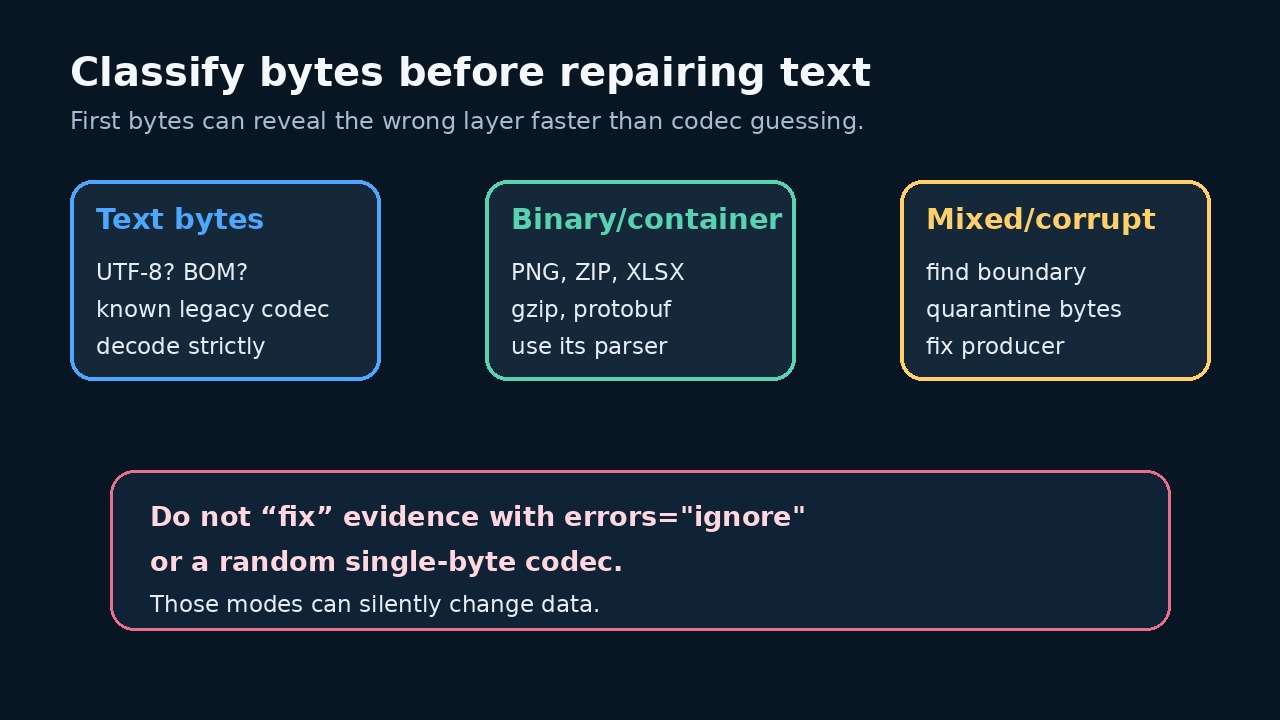
invalid start byte 是一次解码失败,不是让你改用 latin-1 或忽略错误的指令。先保留原始字节,并查明它们来自什么生产端、容器与协议。
冻结原始字节与失败上下文
在编辑器打开之前,先复制原文件或记录哈希。用二进制模式读取小样本,并记录来源命令、文件大小、开头字节、失败偏移、Python版本和准确的编码名。编辑器、表格导入器或管道可能已经改变换行或替换字节,所以应诊断最早的未改副本。
UnicodeDecodeError 只表示所选解码器拒绝了某段字节。它不是编码检测器。同一个字节可能对UTF-8无效、在另一种有文档依据的编码中有效、属于ZIP或图片头,也可能说明传输被截断。
先判断负载是不是文本
尝试编码之前,先核对生产端与容器。魔数字节、已知归档、压缩输出、XLSX包、图片或二进制协议都应先交给对应解析器。改扩展名或直接把容器字节当文本解码,并不能读出内部记录。
如果生产端承诺输出文本,应从协议、导出选项、HTTP头、数据库驱动或命令文档取得明确编码。BOM可作为某些Unicode编码的辅助证据,但没有BOM并不能识别编码;存在BOM时也应交给合适的编解码器。
只严格测试有证据支持的一种编码
使用生产端约定支持的唯一编码,先解码保留的字节样本,再解码完整数据流。确认正确性时保持errors=strict。解码成功只是必要条件:还要校验分隔符、记录数、必填字段和业务约束,因为宽松的单字节编码能映射所有字节,却不代表文字正确。
若严格解码失败,将偏移与原始字节和上游边界对照。如果文件在多字节序列中结束、混入其他编码、包含二进制片段或拼接自不同生产端,应重新获取或导出。不要不停更换编码,直到某一种不报错。
错误处理器只能用于明确目的
errors=ignore会丢弃无法解码的数据,errors=replace会插入替换字符,两者都会改变内容。只有在明确允许损失时,它们才适合生成可读预览;这不是源文件已修复的证据。保留原字节、统计每个受影响区间,并把有损输出单独保存。
backslashreplace可在诊断中显示坏字节。surrogateescape适用于受限的往返场景:无法解码的字节可临时表示为Python字符串,再用同一处理器编码还原。二者都不能确定原本字符;必须记录边界,也不要把代理数据送入要求有效Unicode的系统。
以可验证转换收尾
一次合格的修复应明确生产端、容器、编码和解析器,严格解码完整输入,校验所得记录,并写入新文件而非覆盖证据。保存哈希、记录数和被隔离的字节区间,使另一位审阅者能够复现判断。
当源约定未知、同一文件混用编码、二进制边界无法重建,或替换会改变标识符、金额、测量值与审计字段时,应停止并升级处理。保留不确定性,比发布看似合理但凭空猜出的字符更安全。