科技 · 实用指南
Python出现JSONDecodeError: Extra data?先确认记录边界再解析
第一个JSON值可能有效,但后面仍有内容。先保留原始字节,分清单文档、JSON Lines或连续值,再验证完整输入。
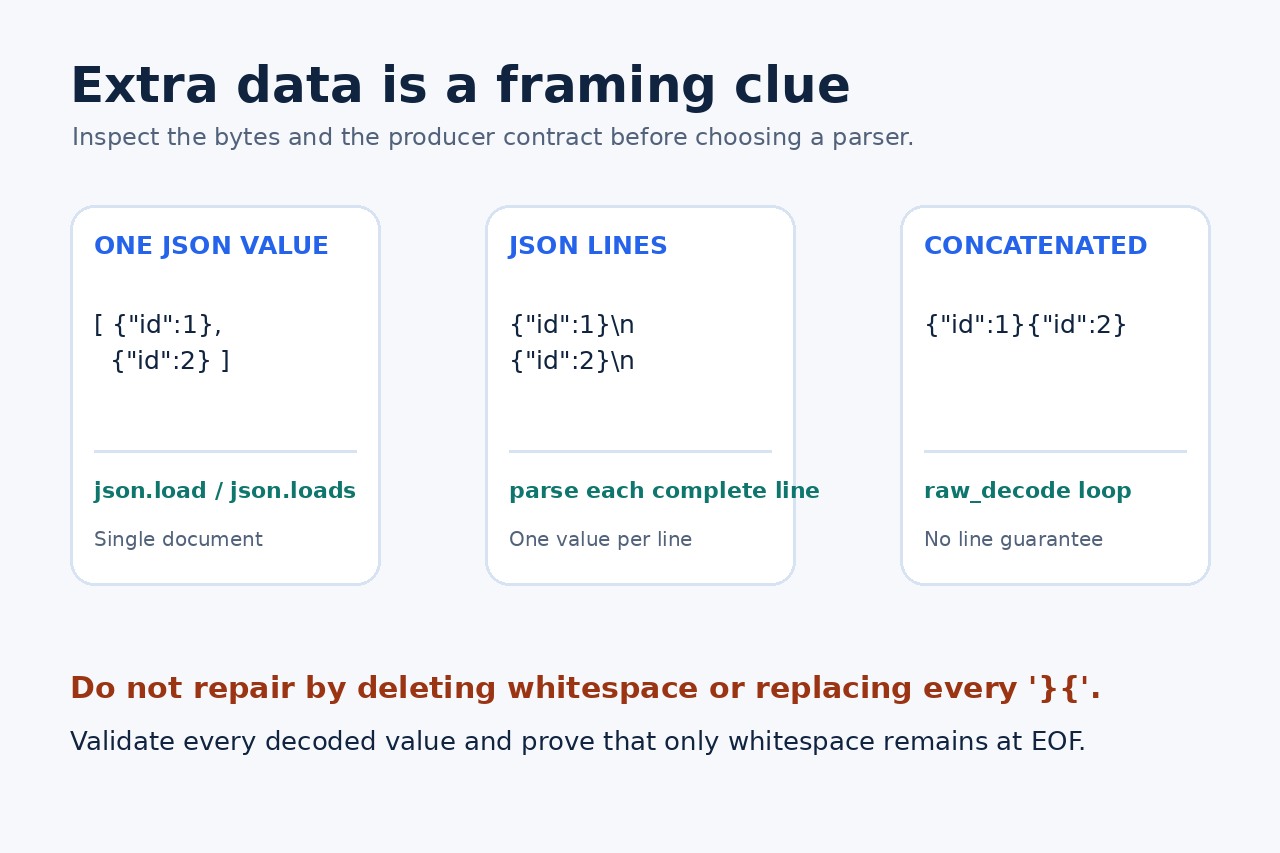
Extra data表示Python已经解出一个完整JSON值,随后又遇到非空白内容。它本身不能证明文件就是JSON Lines,也不能证明第二行一定是安全记录。选择解析器或改写文件前,先保存原始字节并确认生产端的记录边界。
保留证据并判断尾部形态
试验前复制或哈希原文件。记录输入编码、是否有BOM、异常消息、pos、lineno、colno,以及失败位置附近的转义预览。不要删除空白、全局替换}{或直接给原文套方括号,这些做法可能改变字符串、掩盖损坏或制造分隔符。
对解码文本使用JSONDecoder.raw_decode,找出第一个值结束的位置,再只检查剩余内容。若只剩空白,就是单文档;若另一个值开始,应确认生产端承诺的是每行一个完整值、无分隔连续值,还是误附加了无关字节。解析器由协议决定,不由报错行号决定。
按记录协议选择解析器
单个JSON文档应使用json.load或json.loads严格检查;顶层对象、数组、字符串、数字、布尔值或null都算一个值,无法解释的尾部内容应继续报错。若你控制一个集合,单个顶层数组是兼容性最高的JSON表示。
只有每个物理行都恰好是一个完整JSON值时,才按UTF-8逐行解析JSON Lines。对象、数组和标量都可以是记录,但空行不可以。跨多行的美化对象不是一条JSON Lines记录,逐行解析会失败。
不要猜分隔符,逐个消费连续值
当生产端确实输出无固定换行边界的连续JSON值时,可用跳过空白的raw_decode循环,取得每个值及其结束字符索引。每条记录都要检查预期类型或模式,失败时保留记录号与起始索引,最后还要确认跳过空白后精确到EOF。
raw_decode接收的是以JSON文档开头的字符串,并不会自动成为有界流式读取器。大文件需要经过设计的缓冲方案或审阅过的流式解析器。不要全局把}{替换为},{,这些字符可能出现在字符串里,真正损坏的边界也应明确拒绝。
把字符位置映射回字节,并在转换前验收
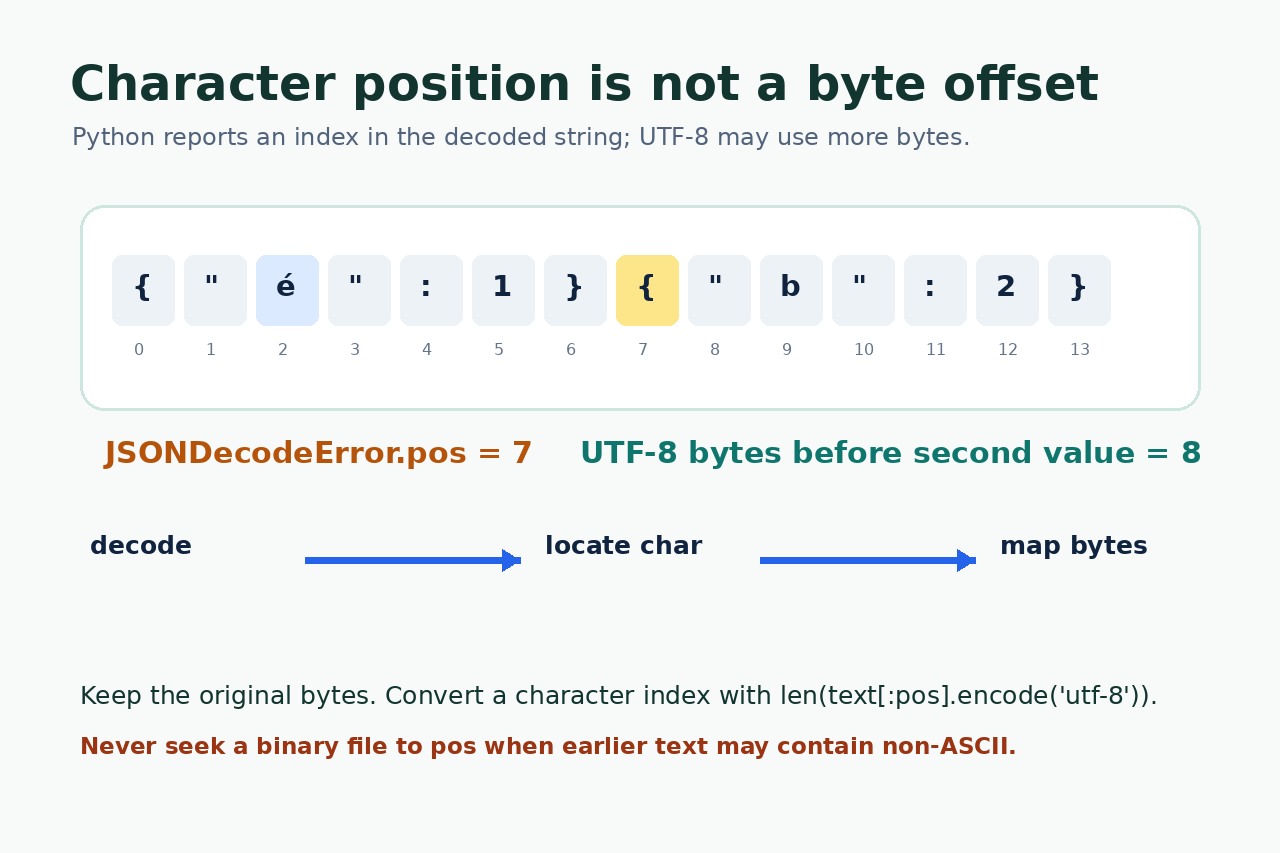
Python文档把JSONDecodeError.pos定义为doc中的起始索引,lineno和colno从解码后的字符串计算。我们的Python 3.12.14非ASCII样例在pos 7失败,但第二个值之前有8个UTF-8字节。可用len(text[:pos].encode("utf-8"))换算;前文含非ASCII时,绝不能直接把pos当二进制seek偏移。
同一测试中,真正JSON Lines在第2行第1列报错,紧密连续值在第1行第8列报错,两个美化对象则在第4行第1列报错。raw_decode能消费三种序列,而逐行方式只适用于JSON Lines。只有每个值都通过语法与业务检查、尾部完整消费、记录数一致后,才能把已解析对象写到新的临时数组或JSON Lines文件,并保留原文件以便回滚。