テクノロジー · 実用ガイド
Python UnicodeDecodeError: invalid start byte――エンコーディングを選ぶ前にバイトを保存する
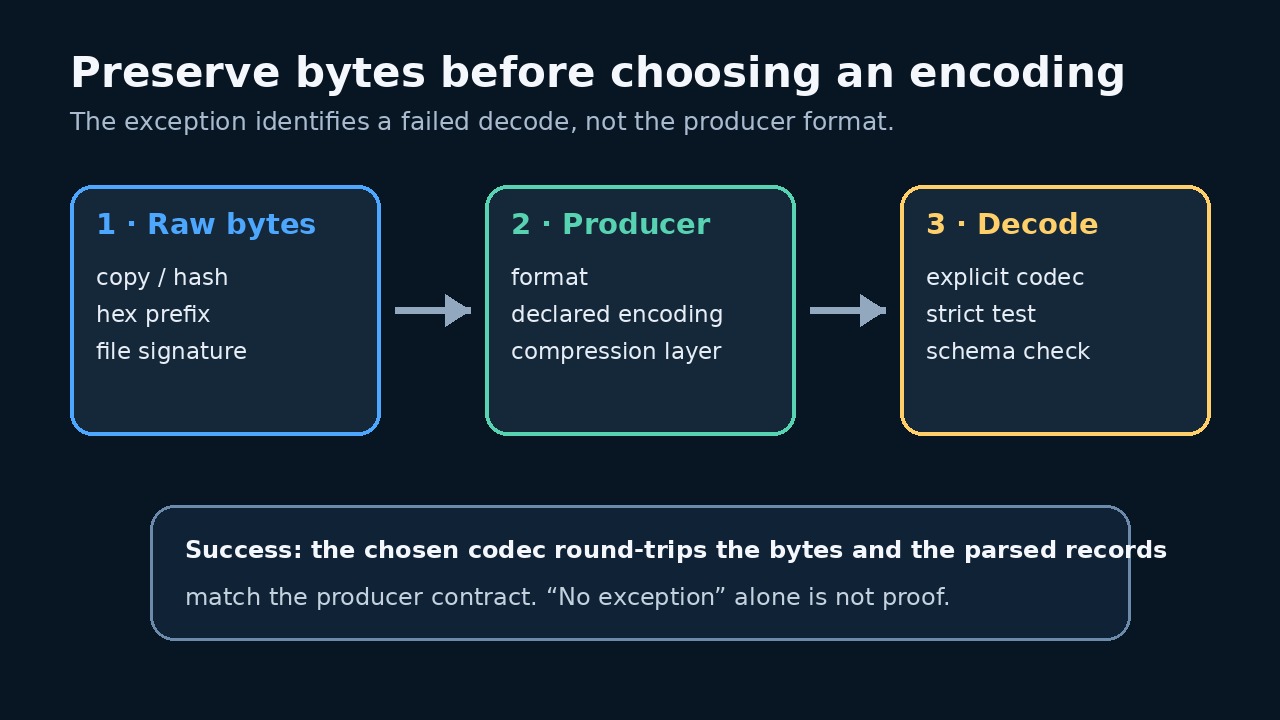
例外は選んだデコーダーの失敗を示すだけです。入力バイトを保存し、文字かバイナリか、生成元の契約を確認してから厳密にデコードします。
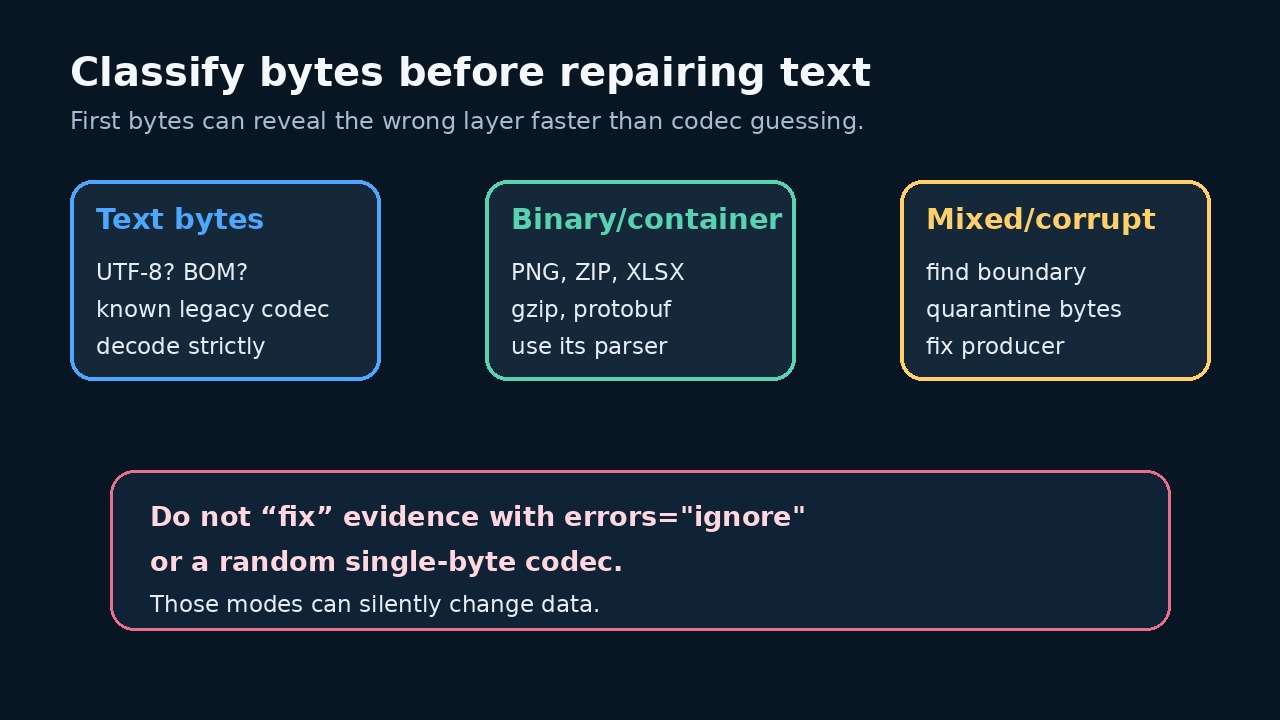
invalid start byte はデコード失敗であり、latin-1 や ignore を試す指示ではありません。元のバイトを保存し、生成元・コンテナ・プロトコルを特定します。
正確なバイトと失敗状況を保存する
エディターで開く前に元ファイルをコピーするかハッシュを記録します。バイナリモードで小さなサンプルを読み、生成コマンド、サイズ、先頭バイト、失敗オフセット、Python版、正確なコーデック名を残します。エディターや表計算ソフト、シェルパイプが改行やバイトを変換済みの場合があるため、最も早い未変更コピーを調べます。
UnicodeDecodeError は選択したデコーダーがバイト列を拒否したことを示すだけで、文字コード検出器ではありません。同じバイトでもUTF-8では不正、別の文書化された文字コードでは正当、ZIPや画像のヘッダー、あるいは転送切断の痕跡である可能性があります。
入力が本当に文字か判定する
コーデックを試す前に生成元とコンテナを確認します。マジックバイト、既知のアーカイブ、圧縮出力、XLSX、画像、バイナリプロトコルは先に対応するパーサーへ渡します。拡張子変更やコンテナ全体の文字デコードでは内部レコードは判定できません。
生成元がテキストを保証するなら、プロトコル、出力設定、HTTPヘッダー、DBドライバー、コマンド文書から文字コードを取得します。BOMは一部Unicode符号化の補助証拠ですが、無いことは文字コードを特定せず、有る場合も対応するコーデックで扱います。
根拠のある1つのコーデックを厳密に試す
生成元の契約が支持する1つのコーデックで保存済みサンプルと全ストリームをデコードします。正当性の確立中はerrors=strictを維持します。成功だけでは不十分で、区切り、件数、必須項目、業務上の不変条件も検証します。単一バイトコーデックは全バイトを写せても正しい文字列とは限りません。
厳密デコードに失敗したら、失敗位置を生バイトと上流境界に照合します。多バイト列の途中で終わる、複数文字コードが混在する、バイナリ片を含む、異なる生成元が連結された場合は再取得・再出力します。例外が消えるまでコーデックを回し続けてはいけません。
エラーハンドラを目的限定で使う
errors=ignoreはデータを捨て、errors=replaceは置換文字を挿入するため、どちらも内容を変更します。損失が明示的に許容されるプレビューには使えますが、修復の証拠ではありません。元バイトを保存し、影響範囲を数え、有損出力を別に保持します。
backslashreplaceは診断で問題バイトを可視化できます。surrogateescapeは限定された往復処理で、未デコードバイトをPython文字列に保持し同じハンドラで戻せます。どちらも意図された文字を特定しないため、境界を記録し、有効Unicodeを要求する系へ渡しません。
検証可能な変換で完了する
完了した修復は生成元、コンテナ、文字コード、パーサーを明示し、入力全体を厳密にデコードし、レコードを検証して、証拠を上書きせず新規出力します。ハッシュ、件数、隔離したバイト範囲を残し、別の査読者が再現できるようにします。
元の契約が不明、同一ファイルで文字コードが混在、バイナリ境界を復元不能、または置換が識別子・金額・測定値・監査項目を変える場合は停止してエスカレーションします。もっともらしい架空文字を公開するより不確実性を保存する方が安全です。