テクノロジー · 実用ガイド
PythonのJSONDecodeError: Extra data?解析前にレコード境界を確認
最初のJSON値は正しくても、その後に別の内容が続くことがあります。元のバイト列を保持し、単一文書・JSON Lines・連結値を見分けてから全体を検証します。
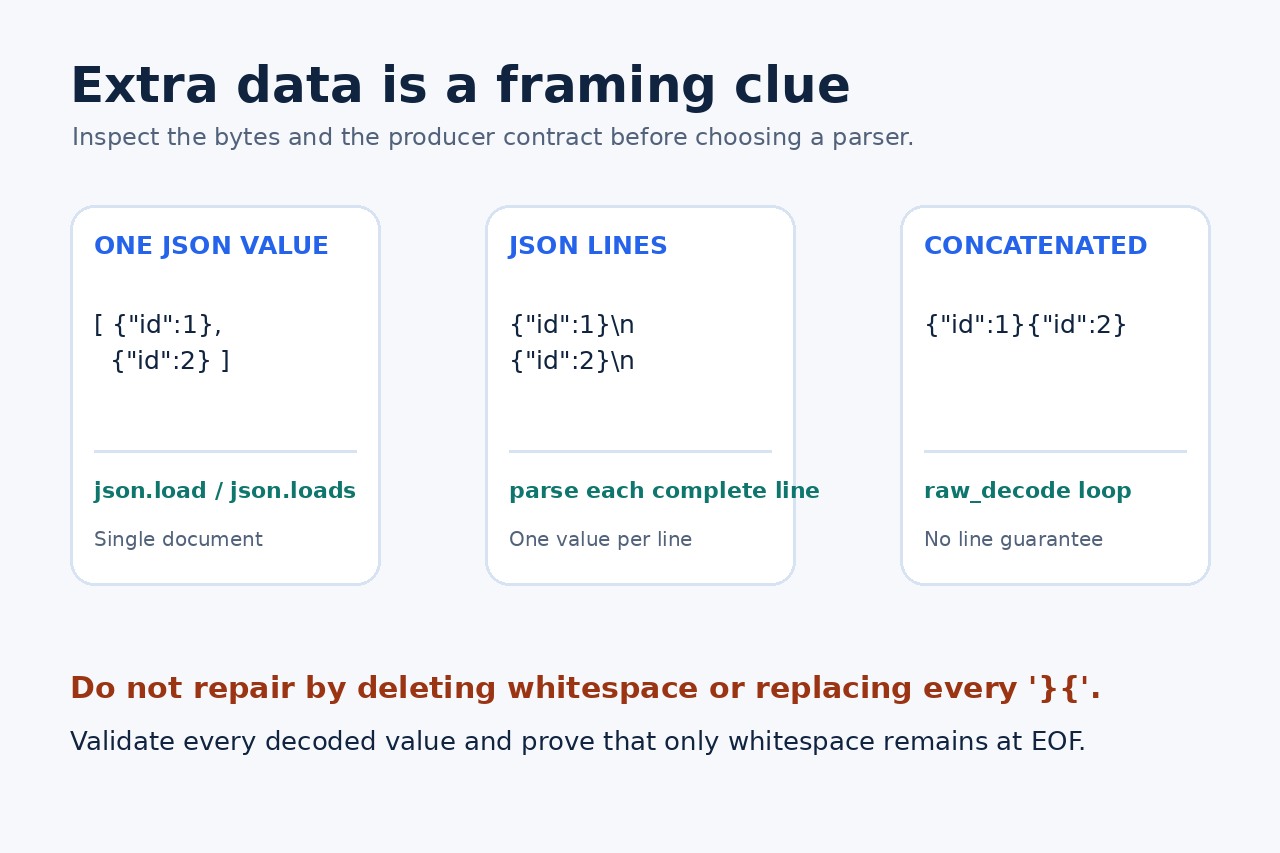
Extra dataは、Pythonが1つの完全なJSON値を読み終えた後に空白以外を見つけたという意味です。それだけでJSON Linesだと断定したり、2行目を安全なレコードと見なしたりはできません。パーサー選択や書き換えの前に、元のバイト列と生成側のフレーミング契約を確認します。
証拠を保持し、後続部分を分類する
試す前に元ファイルをコピーまたはハッシュ化します。入力エンコーディング、BOM、例外メッセージ、pos、lineno、colno、失敗位置周辺のエスケープ表示を記録します。空白削除、すべての}{置換、生テキストへの角括弧追加は、文字列を変えたり破損を隠したりするため避けます。
復号した文字列にJSONDecoder.raw_decodeを使い、最初の値の終端と残りを調べます。残りが空白だけなら単一文書です。別の値が始まるなら、1行1値、区切りなしの連結、誤った付加データのどれを生成側が約束するか確認します。エラー行だけで方式を決めません。
レコード契約に合わせてパーサーを選ぶ
単一JSON文書にはjson.loadまたはjson.loadsを使い、説明できない後続データはエラーのままにします。トップレベルはオブジェクトや配列だけでなく文字列、数値、真偽値、nullも1つの値です。集合を制御できるなら、単一のトップレベル配列が最も移植しやすい形式です。
JSON Linesは、各物理行が完全なJSON値である場合だけUTF-8で行ごとに読みます。オブジェクト、配列、スカラーはいずれも値ですが、空行は不可です。複数行に整形されたオブジェクトは1レコードではなく、行単位の解析に失敗します。
区切りを推測せず連結値を消費する
生成側が改行保証なしにJSON値を連結する契約なら、空白を飛ばすraw_decodeループで値と終了文字索引を得られます。各レコードの型やスキーマを検証し、失敗時には番号と開始索引を残し、最後は空白後に正確なEOFを要求します。
raw_decodeはJSON文書で始まる文字列を受け取り、自動的な制限付きストリームリーダーではありません。大容量ファイルには設計済みのバッファ処理か検証済みのストリームパーサーが必要です。}{の一括置換は文字列内部まで変え得るため使いません。
文字位置をバイトへ対応させ、変換前に全件検証する
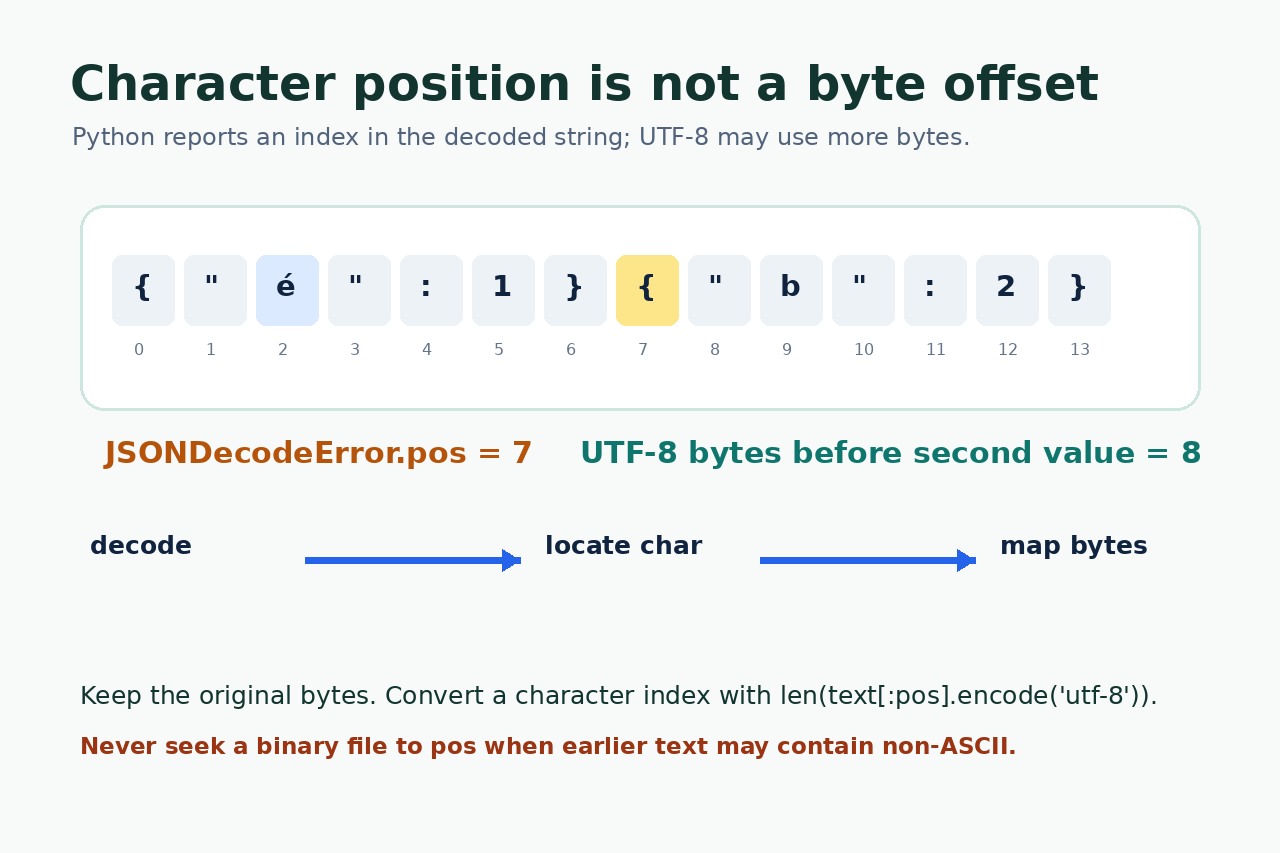
PythonではJSONDecodeError.posはdoc内の開始索引で、linenoとcolnoは復号後文字列から求めます。Python 3.12.14の試験では、{"é":1}{"b":2}はpos 7でしたが、2つ目の値までにUTF-8では8バイトありました。len(text[:pos].encode("utf-8"))で換算し、非ASCIIが前にある場合にposをそのままバイナリseekへ使いません。
同じ試験で、JSON Linesは2行1列、密着した値は1行8列、整形した2値は4行1列でExtra dataになりました。raw_decodeは3形式を最後まで読めましたが、行単位方式はJSON Linesだけ成功しました。全値の構文と業務検証、末尾消費、件数一致を確認してから、新しい一時配列またはJSON Linesへ再シリアライズし、元ファイルを保持します。