科技 · 實用指南
dataclasses.asdict 出現 RecursionError?先選匯出欄位,再遞迴走訪
欄位篩選器可能來不及執行。先區分遞迴型別、真正的物件循環與共用子物件,再選擇 JSON 表示方式。
資料類別列印時看似正常,asdict() 沿子物件回到父物件時卻可能失敗。如果轉換根本無法完成字典,事後刪除 parent 欄位便無法解決問題。應在遞迴開始前,決定匯出資料需要保留哪些關係。
我們在 Linux 的 CPython 3.12.14 上執行了 10 組小型對照,區分三種物件結構,驗證篩選器完全未被呼叫的情況,並在不改變原父子連結的前提下完成扁平 ID 匯出。這是範圍明確的診斷流程,不是通用圖序列化器。
1. 確認物件結構與失敗步驟
記錄直譯器版本和完整例外堆疊,辨識錯誤來自 asdict、自訂轉換函式或 json.dumps。在可拋棄的範例中檢查物件身分,避免遞迴列印整張圖:child.parent is root 可證明這條反向參照,值相等本身不能證明身分相同。
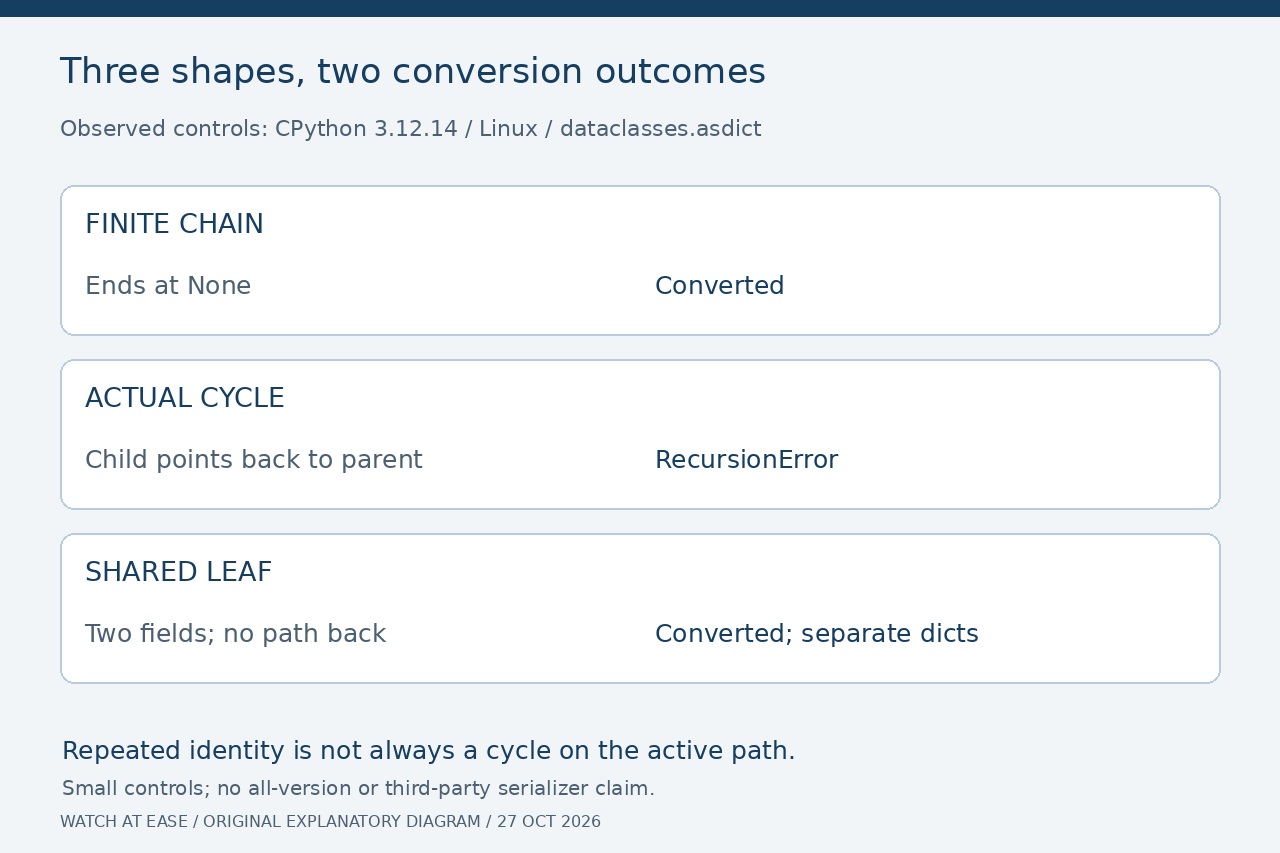
測試中的有限 Node 鏈以 None 結束,可以正常轉換。root 的 children 包含 child,而 child 又指回 root 時,asdict 引發 RecursionError。Pair 的 left 與 right 指向同一葉節點時並沒有環,輸出得到值相等但身分不同的字典。重複身分不一定是循環;關鍵是是否重返目前走訪路徑。
2. 在向下走訪前排除欄位
核對過的 CPython 實作先遞迴轉換欄位值,才把鍵值對交給自訂 dict_factory。我們的工廠函式會增加計數並移除 parent 鍵,但兩節點循環已觸發 RecursionError,計數仍是零。先產生結果再刪欄位,也有同樣的時序問題。
另一組對照將 parent 設為 repr=False、compare=False,並加上 metadata={"serialize": False},asdict 仍沿該欄位遞迴。文件中的前兩個選項控制自動產生的文字表示與比較;metadata 則需要能理解它的使用者。標準 asdict 不會自行採用自訂序列化旗標,因此這些宣告不能證明匯出已修復。
3. 區分複製與序列化政策
文件建議的淺提取寫法 {f.name: getattr(obj, f.name) for f in fields(obj)} 能避開 asdict 遞迴,但 child 範例中的 parent 仍是原 root 物件。把該字典交給帶 default=vars 的 json.dumps 後,測試引發循環參照 ValueError。淺層字典可供檢查,卻不會自動成為 JSON 樹。
deepcopy(root) 建立了新物件,但新 child 仍指向複製後的 root。這是正確的圖複製;以相同診斷 default 編碼 JSON 時,循環仍被拒絕。原作者文章 Deterministic hashing of Python data objects 早已示範在 JSON 遞迴前選擇性淺提取欄位。既有方法之外,應明確決定這次匯出省略哪些關係,以及如何表達其餘關係。
4. 以穩定參照定義小型交換結構
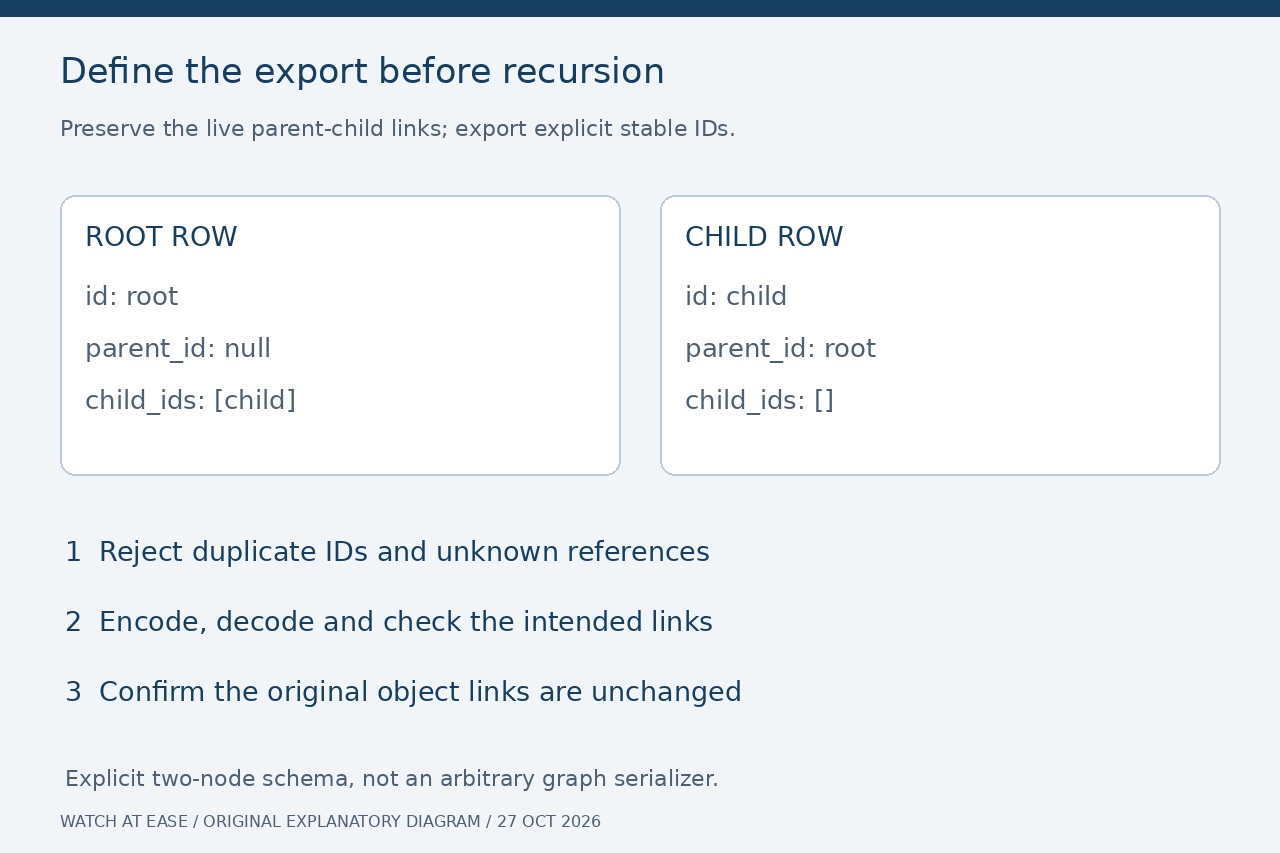
兩節點範例讓每個節點在 nodes 陣列中只出現一次,只輸出 id、parent_id 與 child_ids。根列是 {"id":"root","parent_id":null,"child_ids":["child"]},子列是 {"id":"child","parent_id":"root","child_ids":[]}。字串保留關係,不必再次嵌入父物件。持久交換格式應使用穩定業務 ID,而非只適用目前行程的 id(obj)。
由明確提供的節點清單直接建立各列,不要先對循環模型呼叫 asdict。編碼前拒絕重複 ID,以及未包含在宣告節點集合中的父或子 ID;兩種反例在測試中都遭拒絕。此結構刻意保持簡單:不連通節點、雙向關係不一致、額外欄位和資料可見範圍,仍須另訂業務政策;編碼成功無法代替這些決策。
5. 驗證匯出結果並保留原模型
有效投影經 json.dumps、json.loads 往返後,仍有兩列和預期的 ID 關係;child.parent is root 及 root.children[0] is child 也仍成立。在自己的範例中重做這些檢查,再驗證接收端結構與參照解析。保留重複 ID、缺失參照兩個失敗案例,避免重構時悄悄丟失關係。
不要藉由提高遞迴上限或停用循環檢查,嘗試讓真正的物件環可序列化。已審讀的 Dataclass Wizard 範例把有限巢狀字典載入遞迴型別模型,不能單憑這些範例證明可匯出執行中的身分循環。本次沒有執行第三方序列化器;結果限於指定版本和 10 組小型對照,不涵蓋所有版本或任意物件圖。