テクノロジー · 実用ガイド
Python の「field larger than field limit」?上限変更前に CSV record を診断する
raw bytes を保存し、Sniffer と reader を分離して、正当な幅、quote 崩壊、検出だけの失敗を判定してから field_size_limit を変更します。
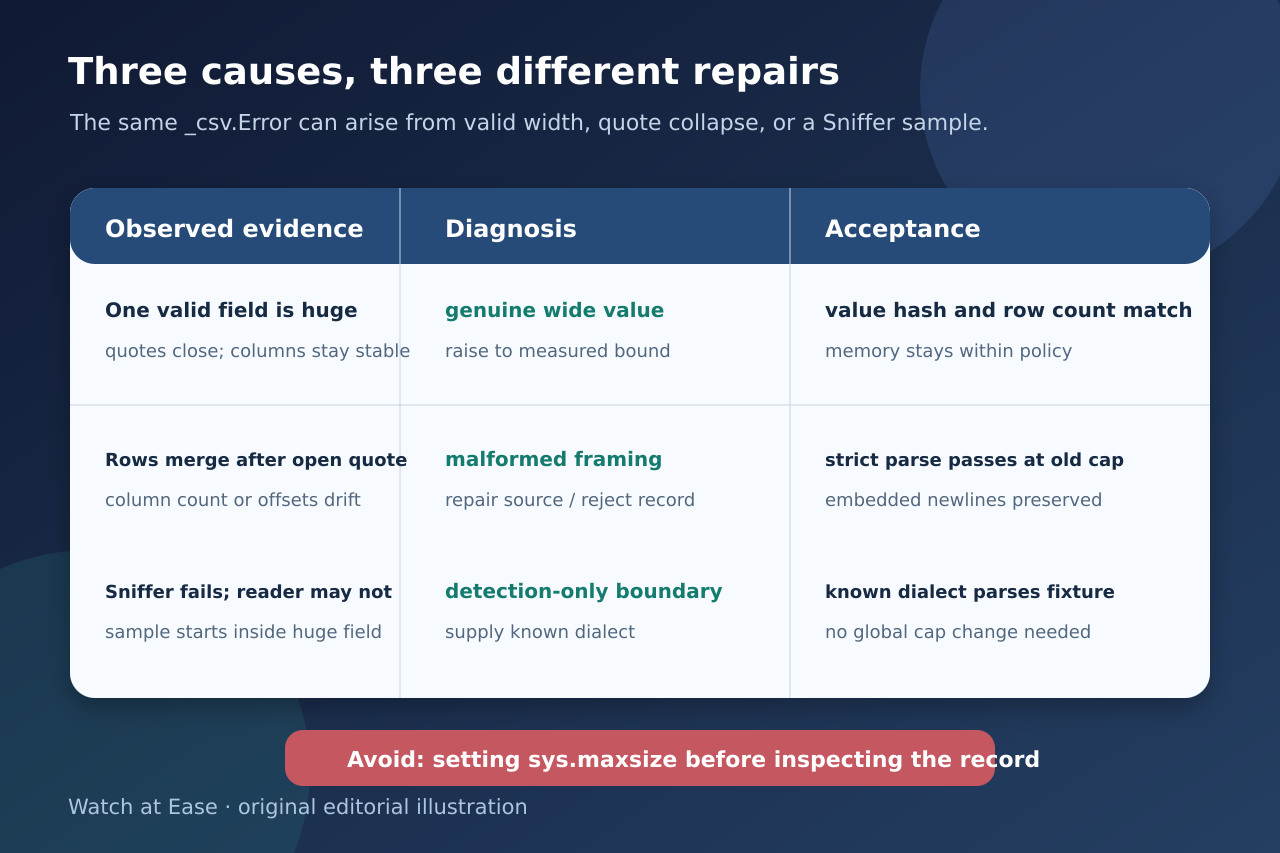
_csv.Error は原因ではなく境界です。大きな正当 field、閉じない quote による record 結合、Sniffer sample の失敗で同じ表示になります。
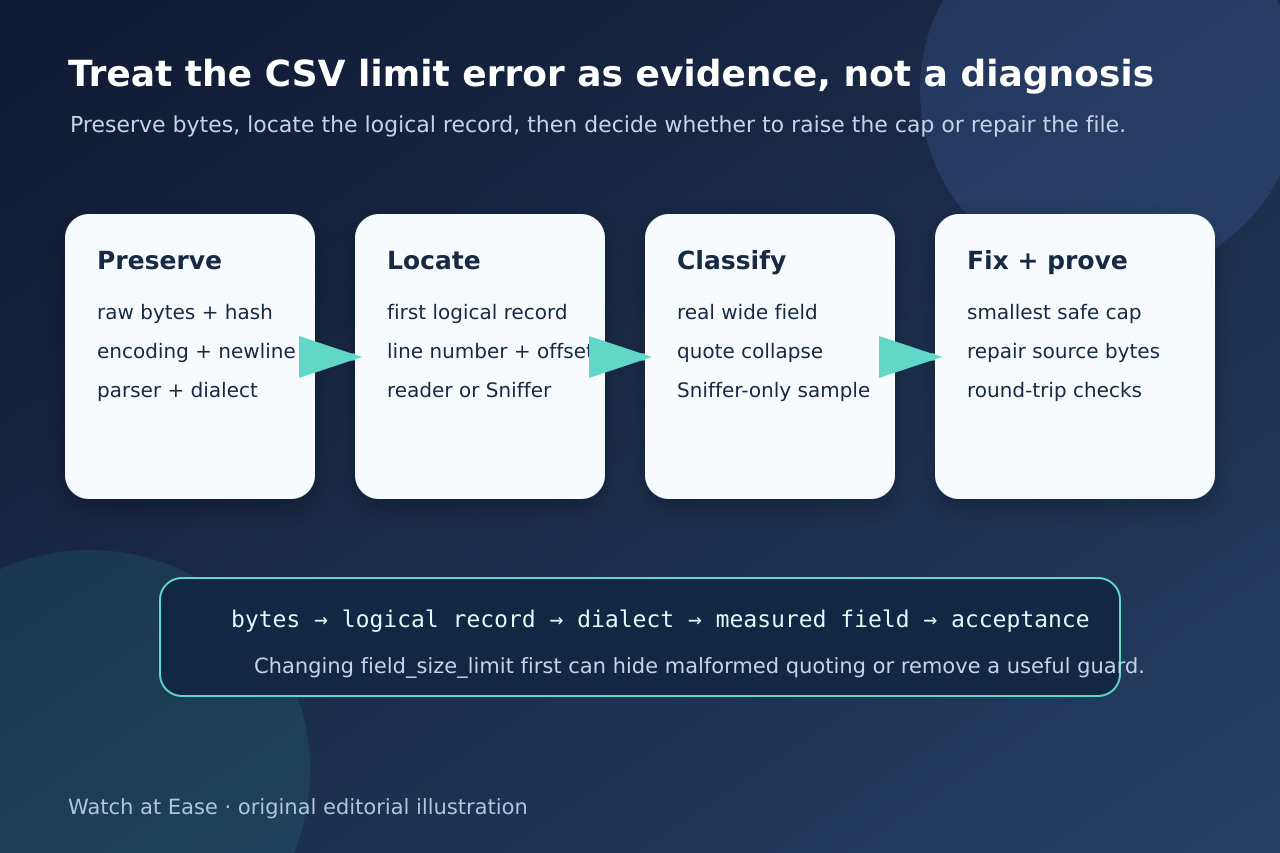
bytes と parser contract を保存し、最初の logical record を特定し、最小の修正後に意味と memory の両方を検証します。
1. bytes と parser contract を保存
hash、size、encoding、BOM、engine を記録し、変換前の file を newline="" で開きます。
dialect 設定と現在の limit を保存し、test 後に戻します。
2. reader と Sniffer を分けて再現
既知 dialect がある場合は Sniffer を避け、同じ bytes を明示設定で読みます。
明示 reader が成功した場合だけ Sniffer-only と判断します。
3. 最初の logical record を特定
fresh handle で stream し、reader.line_num と候補周辺の限定 byte offset を残します。
physical line と CSV record は別なので、quote closure と column drift を確認します。
4. width、quote collapse、検出境界を分類
正当な wide field は framing と構造が安定し、producer contract と測定値が一致します。根拠ある有限 cap だけ設定します。
quote が閉じなければ source を修正・拒否し、Sniffer-only なら既知 dialect を使います。
5. platform bound と修正を検証
C long 変換が overflow する場合は値を下げ、sys.maxsize を普遍的設定にしません。
row・column・hash・embedded character・memory・limit restore を確認します。