テクノロジー · 実用ガイド
PythonのBadZipFile:ZIP構造、CRC、必要ファイルを分けて確認
PKの先頭、一覧の成功、整合性検査は別の判断です。修復前に入力を保存してください。
BadZipFile: File is not a zip fileが出たら、入力そのものと完全な例外を残します。このメッセージだけでは、拡張子変更やキャッシュ削除、バイトの切り詰めで目的のZIPが復元できるとは判断できません。
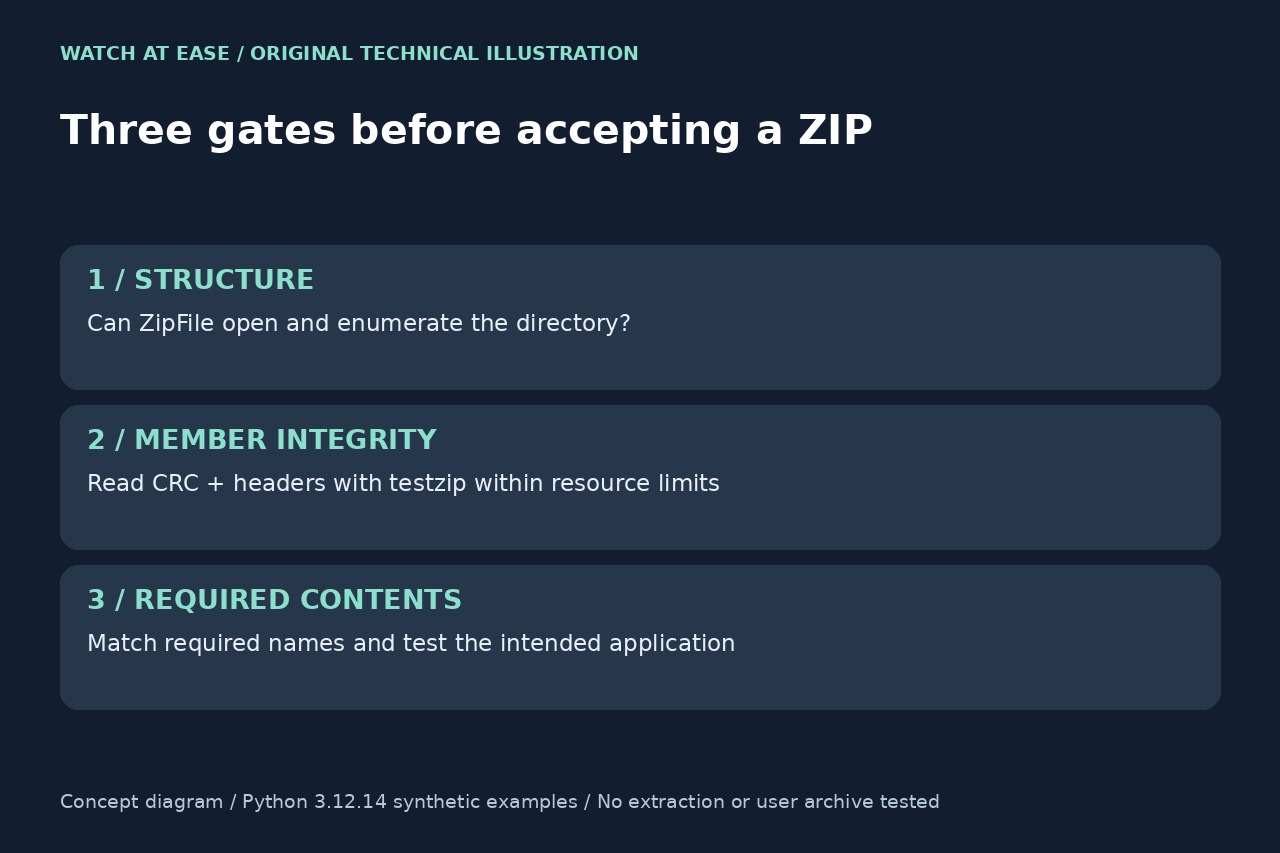
構造を読めるか、メンバーをCRCエラーなく読めるか、必要な内容が揃うかを別々に判定します。小さな合成試験5例で、前の成功を次の成功に置き換えられない理由を確認しました。
1. 入力と失敗段階を保存する
実際のパス、バイト数、SHA-256、Python版、完全な例外を記録し、原本を変えずコピーで調べます。手元のハッシュは同一性の記録であり、同じ成果物の独立して信頼できる参照値と照合しなければ真正性を証明しません。
ダウンロードでは正規の入手経路と版を確認し、保存物がエラー画面やログイン画面ではないか調べます。作成したZIPは書き手を閉じてから読みます。Pythonは終了処理で必要レコードを書きます。原本をwモードで開くと切り詰めるため避けてください。
2. 構造を見てから全メンバーを読む
出所が分かる十分小さな候補にzipfile.is_zipfile(path)を使い、with zipfile.ZipFile(path, "r") as zで開いてz.infolist()を確認します。名前、file_size、compress_size、compress_typeを記録します。構築に失敗したなら一覧成功ではありません。PKWAREは終了レコードを要求し、先頭のPKだけでは不足します。
出所と処理範囲を評価してから同じコンテキストでz.testzip()を実行します。最初の不良名を返し、検査通過時はNoneです。例外は未解決として残します。申告サイズは参考で、強制的な資源上限ではありません。大きい、または信頼できないZIPには上限を強制する隔離処理が必要です。
3. 実測5例を比べる
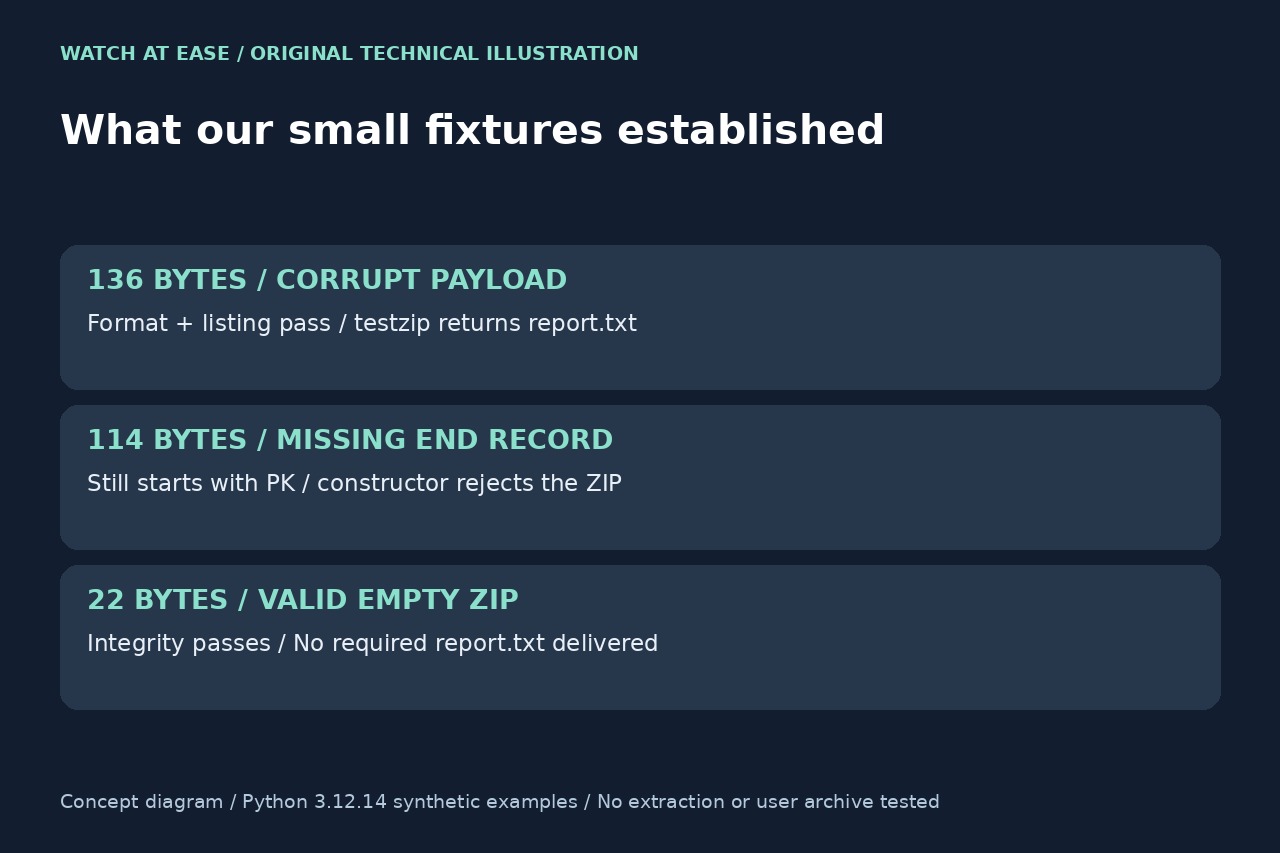
Python3.12.14の小さなBytesIO試験で、展開はしませんでした。正常136バイトはreport.txtを列挙し、testzip()はNoneでした。22バイトの終了レコードを除いた114バイトはPKで始まりますが、is_zipfile()はFalse、構築時はBadZipFileでした。
非圧縮データ1バイトを変えてCRCを残すと136バイトのままです。is_zipfile()はTrueで名前も見えますが、testzip()はreport.txtを返しました。有効な22バイト空ZIPはTrueとNoneでも一覧は空です。20バイトHTMLは形式確認に失敗しました。読者のファイルや全ZIP機能の試験ではありません。
4. 原因に合わせて修復し、必要内容を検証する
別形式や不完全な入力なら正規経路で別名のコピーを入手して同じ成果物の参照値と比較します。書きかけなら正しく生成し直して閉じます。非対応の圧縮や暗号化を示す例外は、読み手の対応機能を確認してから判断します。Python zipfileは分割ZIPを扱いません。
ハッシュ、構造結果、CRC結果、必要メンバー名、アプリでの最終確認を残します。CRC成功は発行元、無害性、必要内容を保証しません。欠けた名前があればNoneでも受領完了にしないでください。唯一の原本を汎用の署名検索で切り詰めても、欠けたデータは復元されません。