기술 · 실용 가이드
PDF 이미지 수가 안 맞나요? 객체·배치·실제로 보이는 화면을 구별하세요
이미지 재사용, 페이지 밖 배치, 불투명 가림은 서로 다른 개수를 만듭니다. 네 가지 실측 대조군으로 추출 목표에 맞는 검증을 설명합니다.
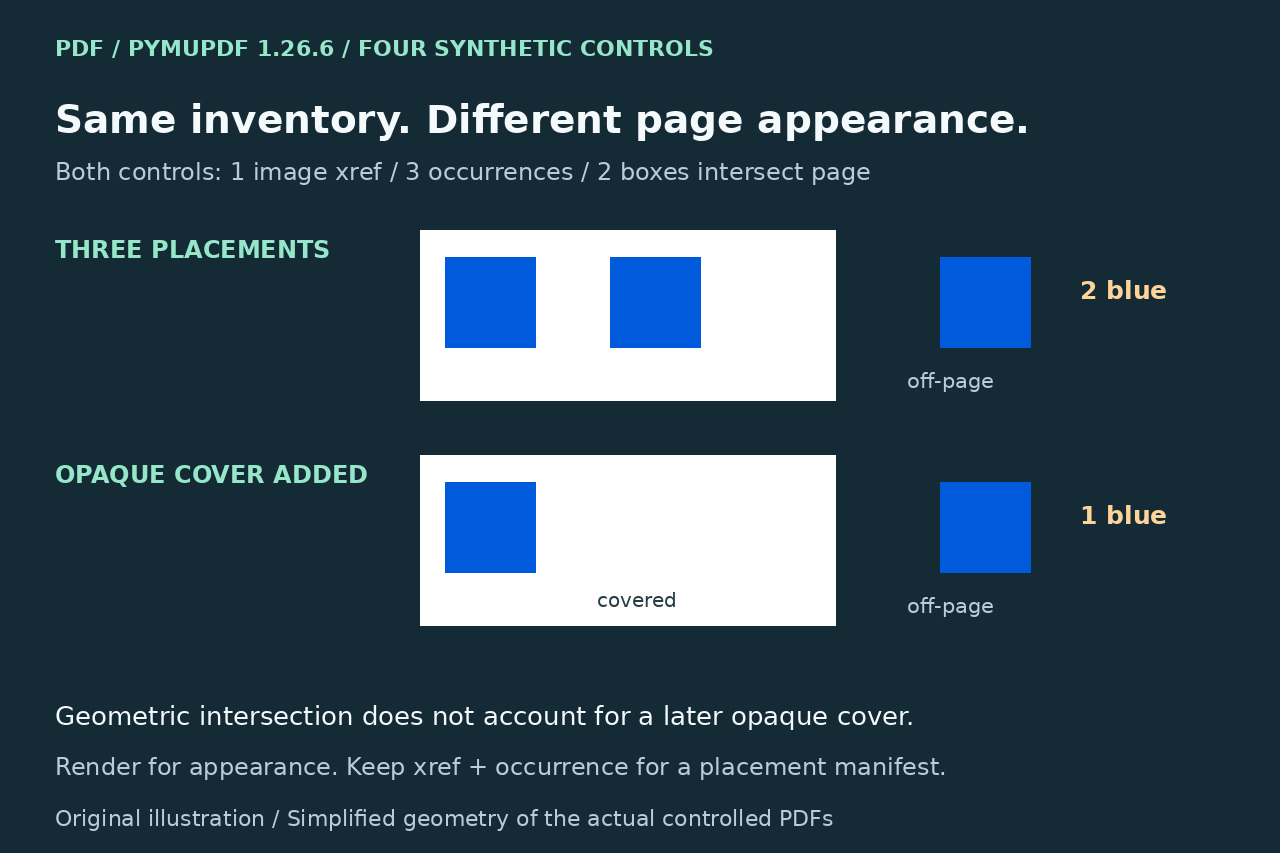
PDF 이미지 목록은 독자가 볼 수 있는 그림의 수와 같지 않습니다. 통제된 예제에서는 하나의 내장 래스터 이미지를 세 번 배치했습니다. 두 위치는 페이지와 겹치고 하나는 페이지 밖이었습니다. 페이지 안 두 번째 위치에 흰색 불투명 덮개를 추가하자 렌더링의 파란 사각형은 두 개에서 하나로 줄었지만 이미지 목록은 그대로였습니다.
먼저 필요한 것이 고유 내장 자산인지, 모든 배치 기록인지, 렌더링된 페이지 외관인지 정하고 그 목표의 증거를 보존하세요. 기존 PyMuPDF 추출·클리핑 방법은 여전히 유용합니다. 여기서 추가로 검증하는 것은 이미지 경계 상자가 페이지와 겹쳐도 최종 화면의 가시성을 입증하지 못한다는 점입니다.
개수를 고르기 전에 출력 목표 정의
자산을 내보내려면 내장 이미지의 식별 정보와 추출 결과를 보존하세요. 여러 페이지에서 재사용된 이미지를 여러 독립 자산으로 저장할 필요는 없을 수 있습니다. 배치 명세라면 xref가 같아도 각 발생의 페이지, bbox, transform을 남깁니다. 페이지의 시각적 영역이 필요하면 원본 이미지 추출이 합성 화면과 같다고 가정하지 말고 해당 영역을 렌더링하세요.
이 목표들은 하나의 성공 개수를 공유할 수 없습니다. xref 중복 제거는 자산 저장소에 적합할 수 있지만 유일한 명세로 쓰면 배치 정보가 사라집니다. 반대로 리소스 행 수는 그만큼의 독립 원본 이미지가 있다는 증거가 아닙니다. PyMuPDF 문서는 반복 발생, 그려지지 않은 리소스, 인라인 이미지 또는 찾지 못한 참조의 xref 0을 설명합니다. xref 0인 항목을 모두 하나의 알려진 자산으로 합치지 마세요.
읽기 전용 발생 명세 만들기
정확한 PDF 해시, 물리적 페이지, 라이브러리 버전과 목표를 기록합니다. 다음 코드는 적당한 크기의 허가받은 작업 사본에서 첫 물리적 페이지를 읽으며 PDF를 다시 쓰지 않습니다. 발생 번호와 xref, bbox, transform을 남기고 xref만 키로 하는 사전으로 바꾸지 마세요. 다른 페이지에는 해당하는 0부터 시작하는 인덱스를 사용합니다. ```python import pymupdf with pymupdf.open("input.pdf") as doc: page = doc[0] # first physical page refs = page.get_images(full=True) placements = page.get_image_info(xrefs=True) print("resource rows:", len(refs)) print("unique positive xrefs:", len({r[0] for r in refs if r[0] > 0})) print("placements:", len(placements)) for occurrence, item in enumerate(placements): print(occurrence, item["xref"], item["bbox"], item["transform"]) ```
독립 명세에는 pdfimages -list "input.pdf"를 사용할 수 있습니다. 추출 이미지를 쓰지 않고 페이지, 이미지 번호, 유형, 객체 ID를 표시합니다. 종료 상태와 반복 객체 ID를 비교하고 각 행을 고유 자산으로 보지 마세요. 크기는 내장 픽셀 수이지 페이지에 그려지는 크기가 아닙니다. mask와 smask는 별도 유형이며 이번 단순 예제에는 없었습니다.
누락을 판단하기 전에 클리핑 차이 확인
image-info 명세는 보이는 페이지 사각형으로 제한되지 않습니다. 반면 get_text('dict')는 보통 그 사각형을 쓰며 클립 안에 완전히 포함된 이미지만 넣습니다. 기존 지원 질문은 clip=pymupdf.INFINITE_RECT()로 개수 차이를 해결했습니다. clip=None은 일반적인 페이지 영역 기본값입니다. 이 기존 해결법을 새로운 발견으로 소개하지 않습니다.
무한 클립은 목록 범위를 바꿀 뿐 페이지 밖 내용을 렌더링 화면에 보이게 만들지 않습니다. get_text('dict')는 이미지 바이트도 읽지만 get_image_info는 그 바이트를 읽지 않습니다. 비교가 필요할 때만 적당한 크기의 해당 페이지에서 더 무거운 검사를 수행하세요. 래스터 목록이 비어도 페이지가 비었다는 뜻은 아닙니다. 텍스트와 벡터 그리기 명령은 별도 내용입니다.
네 가지 실측 대조군 읽기
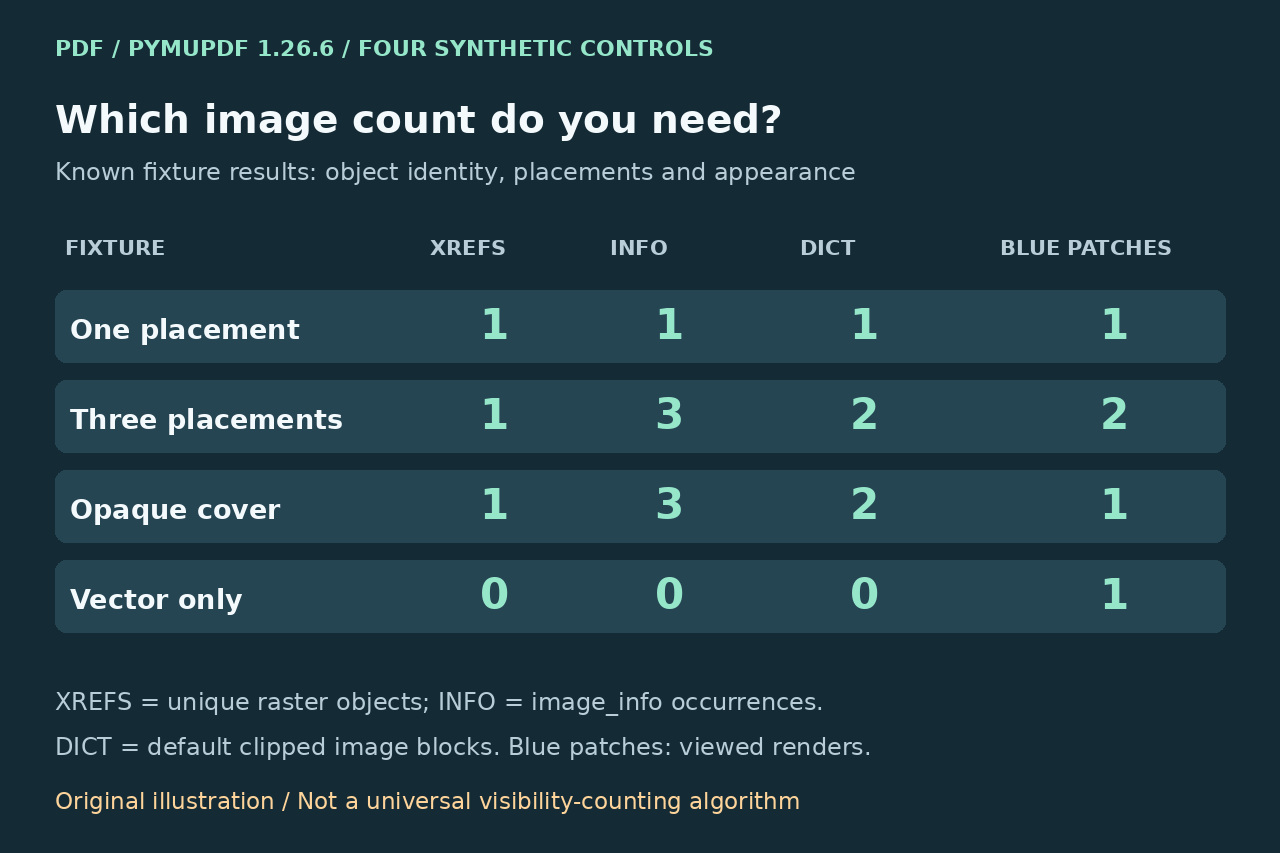
200×150포인트, 회전 없는 한 페이지 PDF 네 개를 만들고 다시 열었습니다. 래스터 타일은 직접 만든 20×20픽셀 RGB 사각형입니다. 단일 배치 대조군은 고유 xref 1개, image-info 발생 1개, 기본 이미지 블록 1개, 실제 파란 영역 1개였습니다. 세 번 배치 대조군은 같은 xref를 페이지 안 두 곳과 밖 한 곳에 써서 리소스 행 3개, 발생 3개, 기본 블록 2개, 무한 클립 블록 3개, 페이지 교차 상자 2개가 됐습니다.
페이지 안 두 번째 위치에 흰색 불투명 벡터 사각형을 덮어도 목록 개수는 모두 같았지만 보이는 파란 영역은 첫 번째 하나뿐이었습니다. 픽셀 표본도 가리지 않은 곳은 파랑, 가린 곳은 흰색임을 확인했습니다. 별도 벡터 전용 사각형은 리소스·image-info·이미지 블록 0개여도 파란 그림으로 렌더링됐습니다. Poppler는 두 재사용 대조군 모두 같은 객체 ID로 세 행을 표시했습니다. 유의미한 아홉 단언이 통과했으나 이 알려진 예제는 범용 가시성 탐지기가 아닙니다.
작업에 맞는 결과로 검증
배치가 목적이면 내보내기 전에 전체 발생 명세와 예상 위치를 비교하세요. 자산이 목적이면 식별·중복 제거 정책을 별도로 기록합니다. 외관이 목적이면 page.get_pixmap() 같은 페이지 렌더링과 실제 필요한 잘라낸 결과를 봅니다. 원본 PDF를 보존하고 개수가 다르다는 이유만으로 이미지를 삭제하지 마세요. 페이지 교차는 기하학 검사이며 불투명 덮개 예제는 그것만으로 가시성을 보증하지 못함을 보여줍니다.
Linux의 PyMuPDF 1.26.6, MuPDF 1.26.11, pdfimages 24.02.0만 시험했습니다. 마스크, 투명도, 회전 페이지, Form XObject, 선택적 콘텐츠, 주석, 개인 문서는 시험하지 않았습니다. 일반적인 겹침과 합성에는 추가 확인이 필요합니다. 올바르게 보이는 잘라내기는 외관 결과일 뿐 객체 제거 증명이나 문서 비식별화·보안 감사가 아닙니다.