기술 · 실용 가이드
PDF 글자는 선택되는데 검색이 안 되나요? OCR 전 매핑과 뷰어 확인
선택은 올바른 추출 증거가 아닙니다. 같은 문제 페이지와 다른 뷰어를 비교하며 uni의 yes/no만으로 단정하지 마세요.
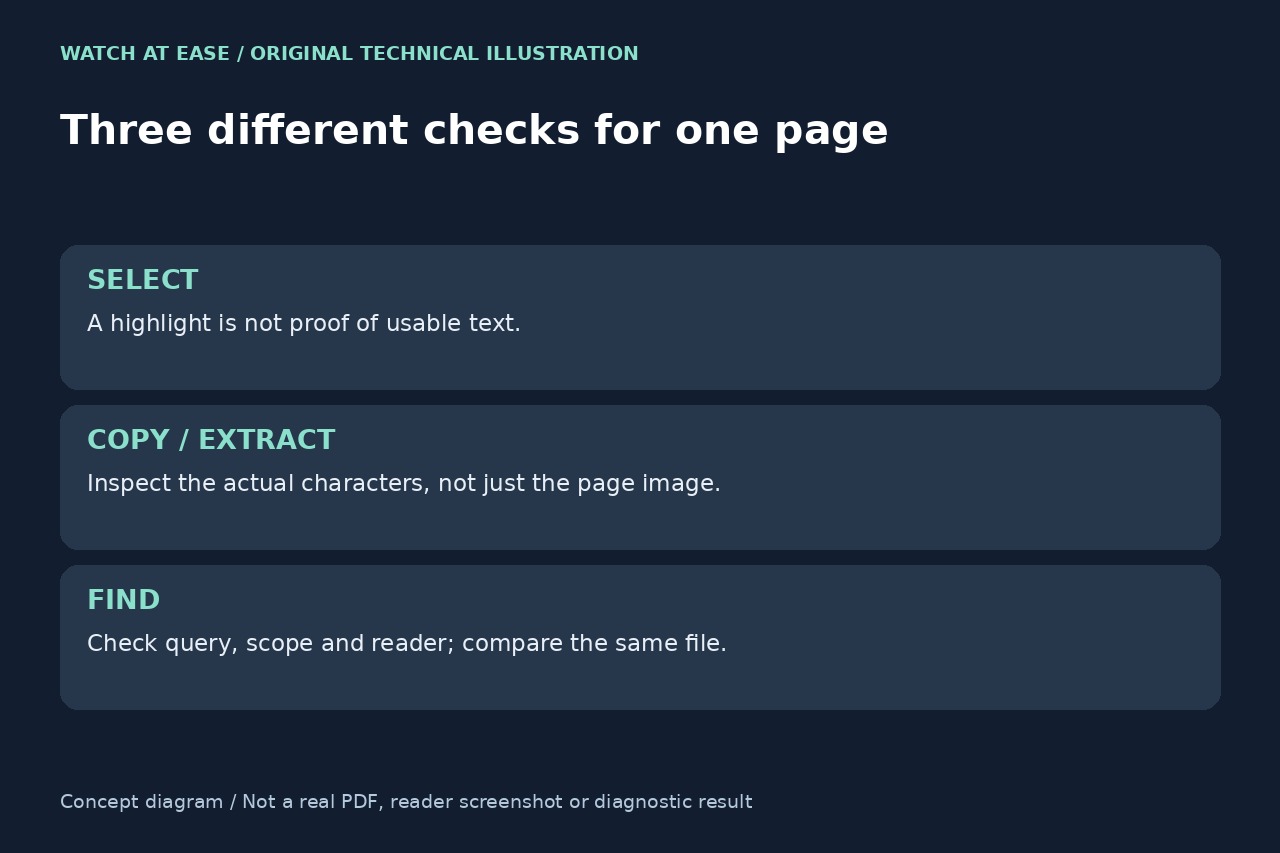
PDF가 정상으로 보이고 선택돼도 검색은 실패할 수 있다. 복사·추출 문자와 화면을 대조하고 같은 파일을 다른 뷰어로 비교한다. 먼저 OCR이나 재인쇄하면 원인을 감출 수 있다.
작은 재현 사례 기록
원본을 남기고 복사본을 사용한다. 뷰어 버전·실제 페이지·짧은 단어·검색 설정을 기록한다. Acrobat 현재 문서 Find의 전체 단어·대소문자를 확인하고 클라우드 목록·색인 검색과 구분한다.
보이는 단어를 입력하고 선택한 짧은 문자열도 Find와 비공개 로컬 편집기에 붙인다. 강조나 다른 페이지 성공은 이 페이지 추출의 보증이 아니다.
PDF 변경 없이 한 페이지 확인
Poppler의 pdffonts -f 1 -l 1 "document.pdf" 는 첫 페이지 폰트를 표시한다. 두 번호를 문제의 실제 페이지로 바꾼다. uni=no가 변환 불가를 뜻하지 않으며 yes도 매핑의 정확성 아닌 존재만 뜻한다.
pdftotext -f 1 -l 1 "document.pdf" - 는 로컬 터미널로 보내며 PDF를 바꾸지 않는다. 내용을 외부에 보내지 말고 오류 상태도 확인한다. 권한·열기 실패는 빈 텍스트가 아니다. 기본·-layout 순서 차이만으로 매핑 손상을 단정하지 않는다.
비교에 맞는 경로 선택
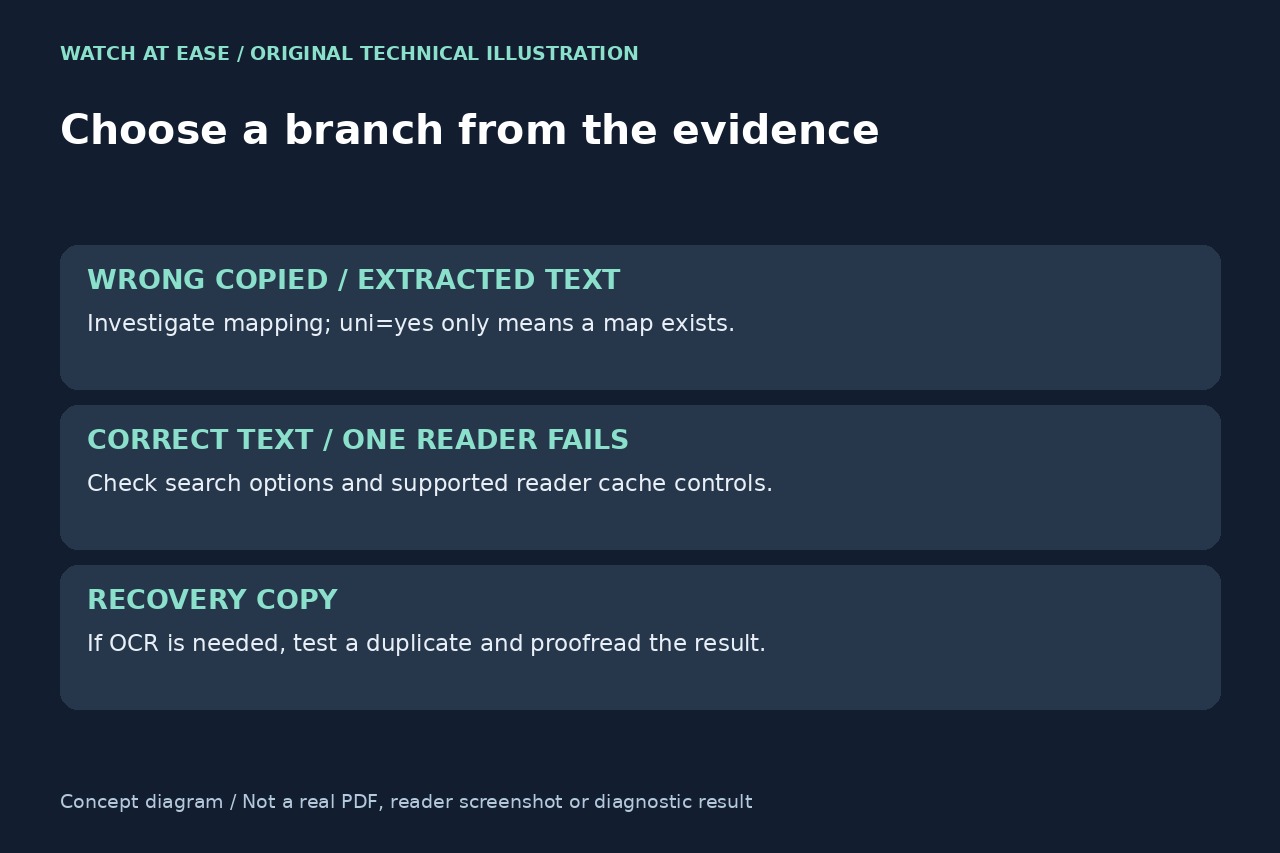
복사와 추출 모두 문자 오류라면 매핑이 의심된다. 정확히 추출되나 한 뷰어만 못 찾으면 검색 설정·캐시부터 본다. 비교만으로 단일 원인이 확정되진 않는다.
Adobe는 Search 설정의 Fast Find와 Purge Cache Contents를 안내한다. 뷰어 한정 경로에서 공식 캐시 조작 후 재확인한다. 오래된 글만 보고 PDF ID·CMap을 직접 고치지 말고 제작자에게 재현 사례를 전달한다.
필요한 범위만 OCR 후 검증
이미지뿐이거나 원자료에서 복원할 수 없는 문자 페이지는 OCR 작업 복사본을 고려한다. Scan & OCR은 페이지·언어를 골라 검색 층을 만든다. 복제한 문제 샘플부터 시험하고 원본 전체를 기본적으로 래스터화하지 않는다.
재내보내기·OCR 후 단어·숫자·이름을 화면과 비교하고 링크·양식·주석도 확인한다. 원자료와 PDF 원본을 남긴다. 검색 성공은 완전 정확성 보증이 아니며 독자 파일이나 모든 Acrobat 버전을 시험한 글이 아니다.