テクノロジー · 実用ガイド
PDFの画像数が合わない? オブジェクト・配置・見える画面を分けて確認
画像の再利用、ページ外配置、不透明な覆いで数え方は変わります。4つの実測例で、抽出目的ごとの確認方法を示します。
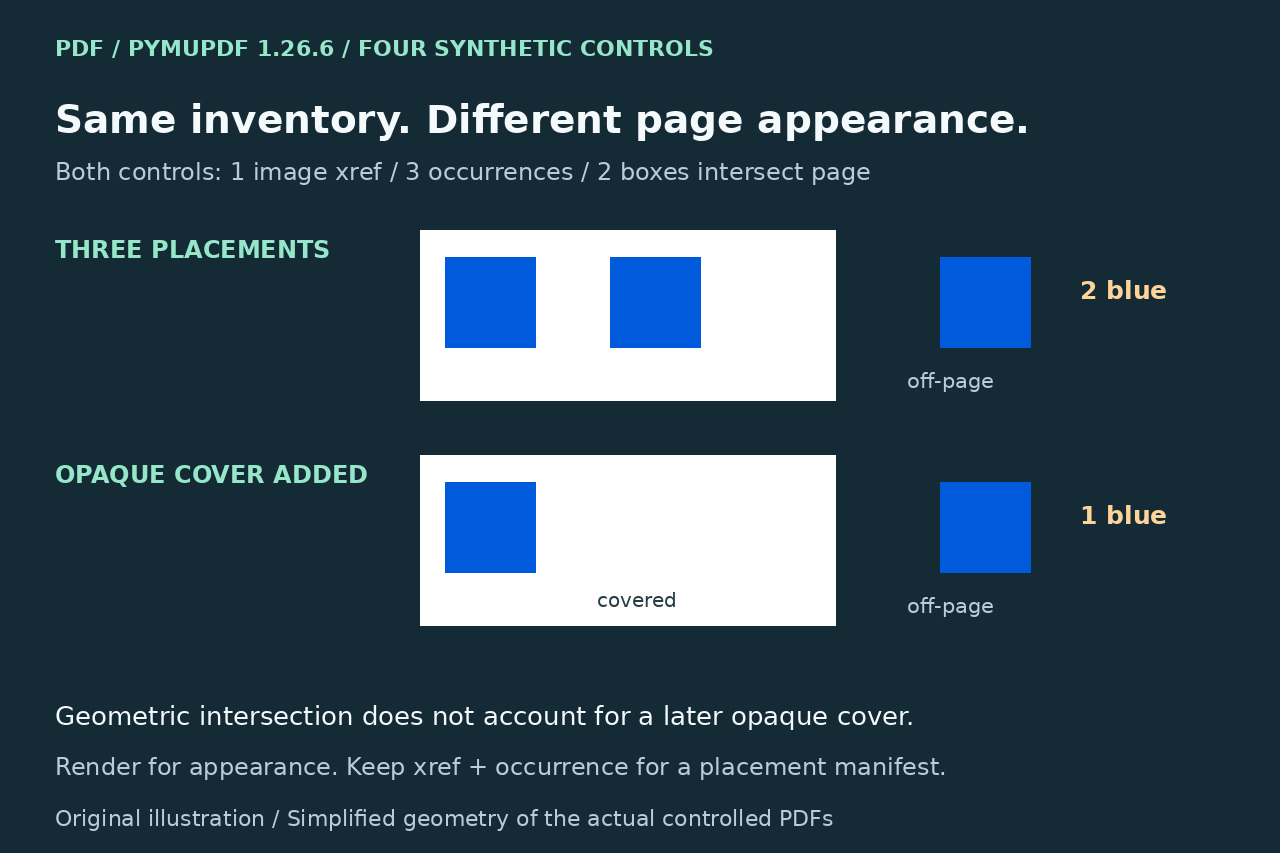
PDFの画像一覧は、読者に見える絵の数とは限りません。制御した例では、埋め込んだ1つのラスター画像を3か所に配置しました。2か所はページと交差し、1か所はページ外です。ページ内の2つ目に白い不透明な覆いを追加すると、描画結果の青い四角は2つから1つになりましたが、画像一覧は変わりませんでした。
独立した埋め込み素材、すべての配置、ページの描画外観のどれが必要かを先に決め、それに合う証拠を残します。既存のPyMuPDF抽出・クリップ方法は有効です。ここで補うのは、画像の境界ボックスがページと交差していても最終的に見えるとは証明できない点です。
数える前に出力を定義
素材を出すなら埋め込み画像の識別情報と抽出結果を保持します。複数ページで使う同じ画像を、独立素材として何度も保存する必要はないかもしれません。配置一覧ならxrefが同じでも各出現のページ、bbox、transformを残します。ページの見た目を切り出すなら、元画像の抽出が合成結果と同じだと仮定せず、対象領域を描画します。
これらを一つの成功件数で判定してはいけません。xrefによる重複排除は素材管理には適しても、それだけの一覧では配置が失われます。反対に資源行数は独立した原画像数の証明ではありません。PyMuPDFは繰り返し配置、未描画の資源、インライン画像や検出できない参照のxref0を説明しています。xref0の全項目を一つの既知素材にまとめないでください。
読み取り専用の出現一覧を作る
正確なPDFハッシュ、物理ページ、ライブラリの版、目的を記録します。次の例は、許可された適度な大きさの作業コピーの最初のページを読み、PDFを書き換えません。出現番号、xref、bbox、transformを残し、xrefだけをキーにする辞書へ置き換えません。他のページでは対応する0始まりの番号を使います。 ```python import pymupdf with pymupdf.open("input.pdf") as doc: page = doc[0] # first physical page refs = page.get_images(full=True) placements = page.get_image_info(xrefs=True) print("resource rows:", len(refs)) print("unique positive xrefs:", len({r[0] for r in refs if r[0] > 0})) print("placements:", len(placements)) for occurrence, item in enumerate(placements): print(occurrence, item["xref"], item["bbox"], item["transform"]) ```
独立した一覧にはpdfimages -list "input.pdf"を使えます。抽出画像を書かずにページ、画像番号、種類、オブジェクトIDを出します。終了状態と重複IDを確認し、各行を独立素材と見なさないでください。幅と高さは埋め込み画素数で、ページで描かれる大きさではありません。maskとsmaskは別の種類です。今回の単純な例には含めていません。
欠落と判断する前にクリップを説明
image-info一覧は見えるページ矩形に制限されません。一方get_text('dict')は通常その矩形を使い、クリップ内に完全に収まる画像だけを含めます。既存のサポート例はclip=pymupdf.INFINITE_RECT()で数の違いを解決しています。clip=Noneは通常のページ範囲のままです。この既知の解決策を、新発見とは扱いません。
無限クリップは一覧の対象範囲を変えるだけで、ページ外の内容を描画画面に見せるものではありません。get_text('dict')は画像バイナリも読み込みますが、get_image_infoはそのバイト列を読み込みません。比較が必要な影響ページに限り、適切なサイズで重い処理を使います。ラスター一覧が空でもページが空とは限らず、文字とベクターの命令は別の内容です。
4つの実測対照を読む
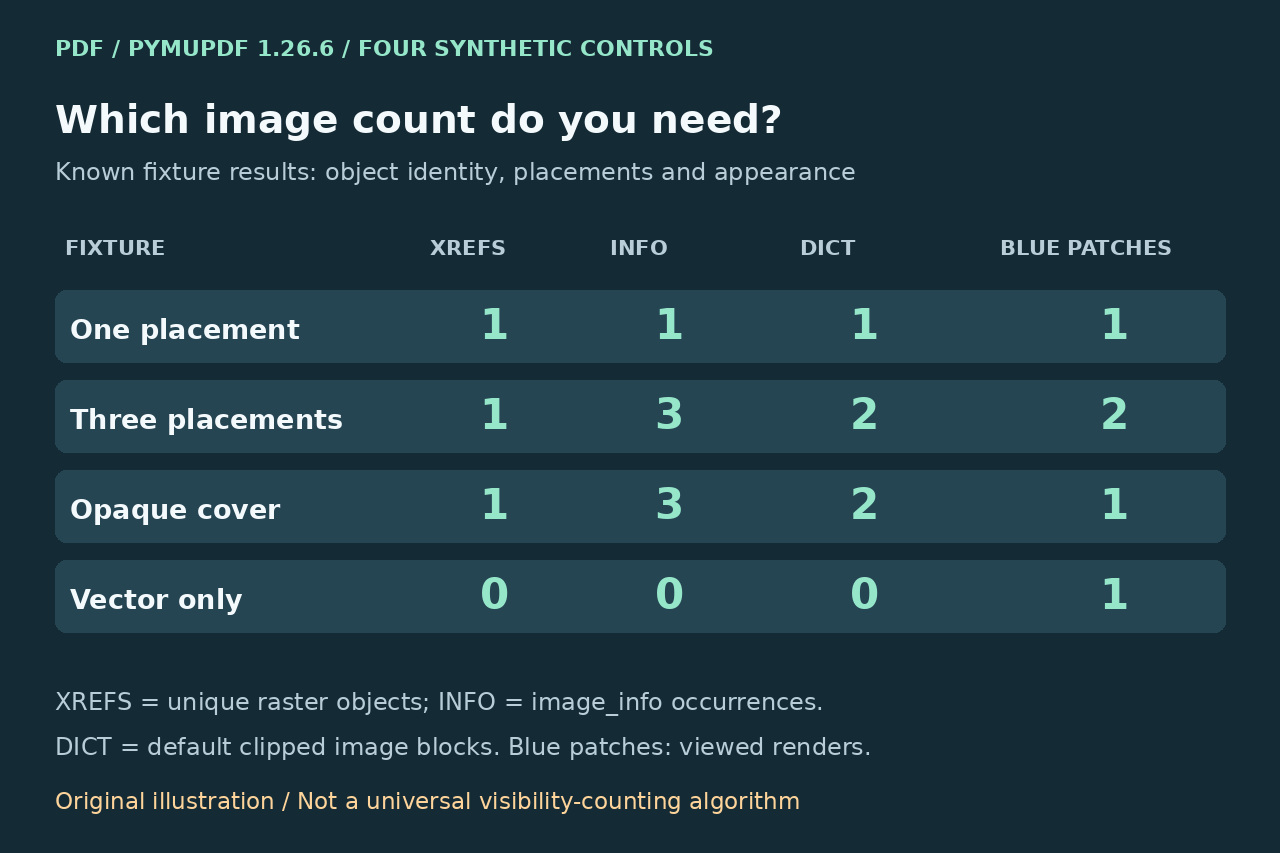
200×150ポイント、回転なしの1ページPDFを4つ作って開き直しました。画像は自作の20×20画素RGB四角です。1配置例は一意xref1、image-info出現1、標準画像ブロック1、描画で青い四角1でした。3配置例では同じxrefをページ内2か所とページ外1か所で使い、資源行3、出現3、標準ブロック2、無限クリップのブロック3、交差ボックス2となりました。
ページ内2か所目に白い不透明ベクター矩形を重ねても、これらの一覧値はすべて同じで、見える青い四角だけが1つになりました。画素サンプルでも未被覆位置は青、被覆位置は白でした。別のベクターだけの四角は資源・image-info・画像ブロックが0でも青く描画されました。Popplerは再利用した両例で同一IDの画像を3行出しました。意味のある9つの検証が通りましたが、既知の例であり汎用可視性検出器ではありません。
目的に合う結果を確認
配置なら、抽出前に全出現一覧と期待位置を比較します。素材なら識別と重複排除の方針を別に記録します。外観ならpage.get_pixmap()などの描画と必要な実際の切り出しを見ます。原PDFを残し、数が違うだけで画像を削除しません。ページ交差は幾何判定であり、不透明な覆いの例が示すように、それだけで可視性は保証できません。
対象はLinux上のPyMuPDF1.26.6、MuPDF1.26.11、pdfimages24.02.0です。マスク、透明度、ページ回転、Form XObject、オプション内容、注釈、非公開資料は試していません。一般的な重なりや合成には追加の確認が必要です。正しく見える切り出しは外観の結果であり、オブジェクト削除の証明や墨消し・安全性の監査ではありません。