Tecnología · GUÍA PRÁCTICA
¿No cuadra el número de imágenes del PDF? Separa objetos, posiciones y vista
Reutilizar una imagen, colocarla fuera de página o cubrirla puede cambiar el recuento útil. Cuatro controles probados separan las metas de extracción.
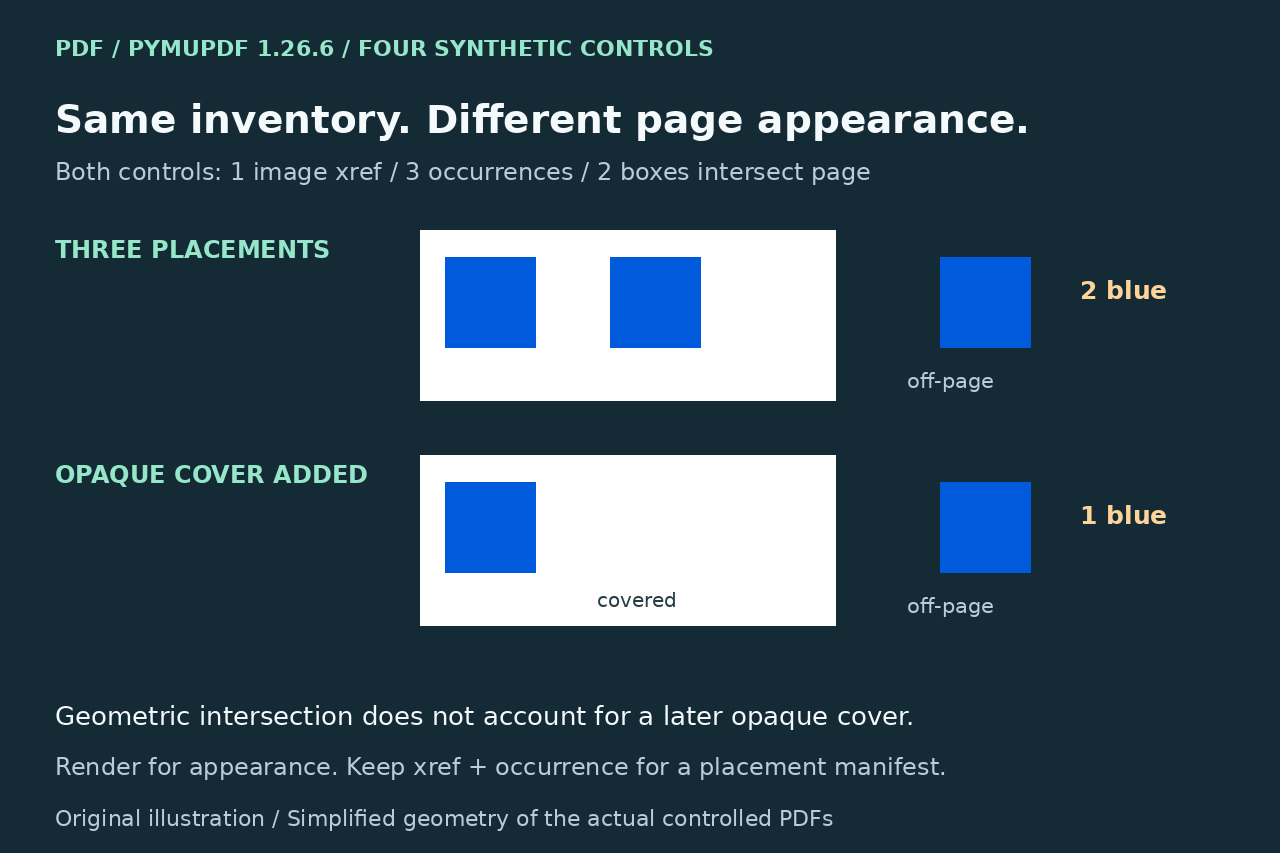
Un inventario de imágenes PDF no equivale al número de dibujos que ve el lector. En nuestro ejemplo controlado, una sola imagen ráster incrustada se colocó tres veces: dos posiciones intersectaban la página y una quedaba fuera. Añadir una cubierta blanca opaca sobre la segunda posición interior cambió la vista renderizada de dos cuadrados azules a uno, sin cambiar el inventario.
Decide primero si necesitas recursos incrustados únicos, todas las posiciones o la apariencia de una página renderizada. Conserva las pruebas de ese objetivo. Las recetas existentes de extracción y recorte de PyMuPDF siguen siendo útiles; la comprobación adicional es que ni siquiera una caja que intersecta la página demuestra que el dibujo sea visible.
Define la salida antes de elegir el recuento
Para exportar recursos, conserva la identidad de la imagen incrustada y el resultado extraído; una imagen usada en varias páginas no necesita convertirse en varios recursos independientes. Para un manifiesto de posiciones, mantén cada aparición con página, bbox y transform, aunque se repitan xrefs. Para un recorte visual, renderiza la región prevista en vez de suponer que la imagen fuente extraída reproduce la composición.
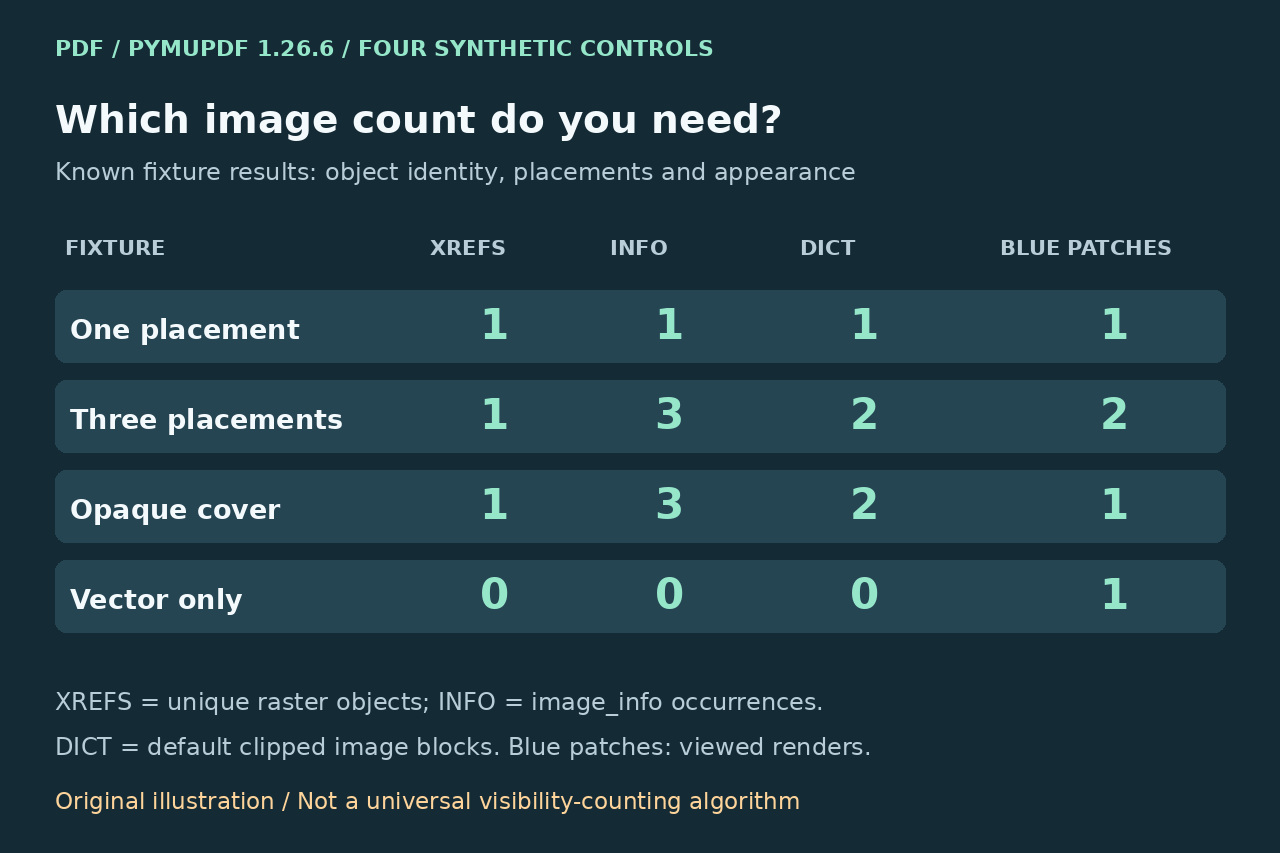
Estos objetivos no comparten una cifra de éxito. Deduplicar por xref puede servir para una biblioteca de recursos, pero pierde posiciones si es el único manifiesto. Tampoco el número de filas de recursos demuestra que existan tantas imágenes originales distintas. PyMuPDF documenta apariciones repetidas, posibles recursos no dibujados y xref 0 para imágenes en línea o referencias no detectadas. No agrupes todos los xrefs cero como un único recurso conocido.
Crea un registro de apariciones de solo lectura
Registra hash exacto del PDF, página física, versión y salida deseada. Este código inspecciona la primera página de una copia autorizada de tamaño adecuado, sin reescribirla. Conserva el número de aparición además de xref, bbox y transform; no sustituyas la lista por un diccionario cuya única clave sea xref. Las demás páginas usan su índice correspondiente, empezando por cero. ```python import pymupdf with pymupdf.open("input.pdf") as doc: page = doc[0] # first physical page refs = page.get_images(full=True) placements = page.get_image_info(xrefs=True) print("resource rows:", len(refs)) print("unique positive xrefs:", len({r[0] for r in refs if r[0] > 0})) print("placements:", len(placements)) for occurrence, item in enumerate(placements): print(occurrence, item["xref"], item["bbox"], item["transform"]) ```
Como inventario independiente, pdfimages -list "input.pdf" muestra página, número de imagen, tipo e ID de objeto sin escribir imágenes extraídas. Comprueba la salida del proceso y compara IDs repetidos en lugar de considerar cada fila un recurso único. Las dimensiones describen píxeles incrustados, no el tamaño dibujado en página. Las máscaras y máscaras suaves son tipos separados en ese informe; nuestro ejemplo sencillo no tenía ninguna.
Explica el recorte antes de declarar una pérdida
El inventario image-info no queda limitado al rectángulo visible de página. get_text('dict'), en cambio, suele usar ese rectángulo e incluye solo imágenes totalmente contenidas en su recorte. Una consulta de soporte existente ya resuelve una discrepancia con clip=pymupdf.INFINITE_RECT(); clip=None mantiene el área normal de página. Reconocemos esa solución, sin presentarla como descubrimiento.
El recorte infinito cambia el inventario, no hace visible en la página lo que está fuera. get_text('dict') también carga los bytes de las imágenes, mientras get_image_info evita cargarlos. Haz la comparación más pesada solo en la página afectada y de tamaño adecuado cuando responda a tu duda. Un listado ráster vacío tampoco demuestra una página vacía: texto y órdenes vectoriales son otros contenidos.
Lee los cuatro controles medidos
Creamos y reabrimos cuatro PDFs nuevos de una página sin rotación, de 200×150 puntos. La imagen era un cuadrado RGB propio de 20×20 píxeles. El control de una posición tuvo un xref único, una aparición image-info, un bloque predeterminado y una zona azul visible. El de tres posiciones reutilizó un xref en dos lugares interiores y uno exterior: filas de recursos 3, apariciones 3, bloques predeterminados 2, bloques con recorte infinito 3 y cajas que intersectaban la página 2.
Añadir un rectángulo vectorial blanco opaco sobre la segunda posición interior dejó iguales todos esos recuentos, pero solo se veía la primera zona azul. Muestras de píxeles confirmaron azul en la posición descubierta y blanco en la cubierta. Un control vectorial separado produjo cero filas de recursos, image-info y bloques de imagen, aunque su página mostraba un cuadrado azul. Poppler enumeró tres filas con el mismo ID en ambos controles de reutilización. Pasaron nueve aserciones relevantes; estos casos conocidos no son un detector general de visibilidad.
Valida el resultado que corresponde a la tarea
Para posiciones, compara el registro completo con los lugares esperados antes de exportar. Para recursos, documenta aparte la identidad y política de deduplicación. Para apariencia, inspecciona una renderización, por ejemplo page.get_pixmap(), y el recorte realmente necesario. Conserva el PDF original y no borres imágenes solo porque las cifras difieran. La intersección es geométrica: el control con cubierta opaca demuestra que no certifica visibilidad.
Probamos PyMuPDF 1.26.6, MuPDF 1.26.11 y pdfimages 24.02.0 en Linux. No probamos máscaras, transparencia, páginas giradas, Form XObjects, contenido opcional, anotaciones ni documentos privados. La superposición y composición generales requieren más comprobaciones. Un recorte visualmente correcto es un resultado de apariencia, no prueba de eliminación de objetos ni una auditoría de censura o seguridad.