Tecnología · GUÍA PRÁCTICA
PostgreSQL dice “could not resize shared memory segment”: demuestra qué sistema de archivos se agotó
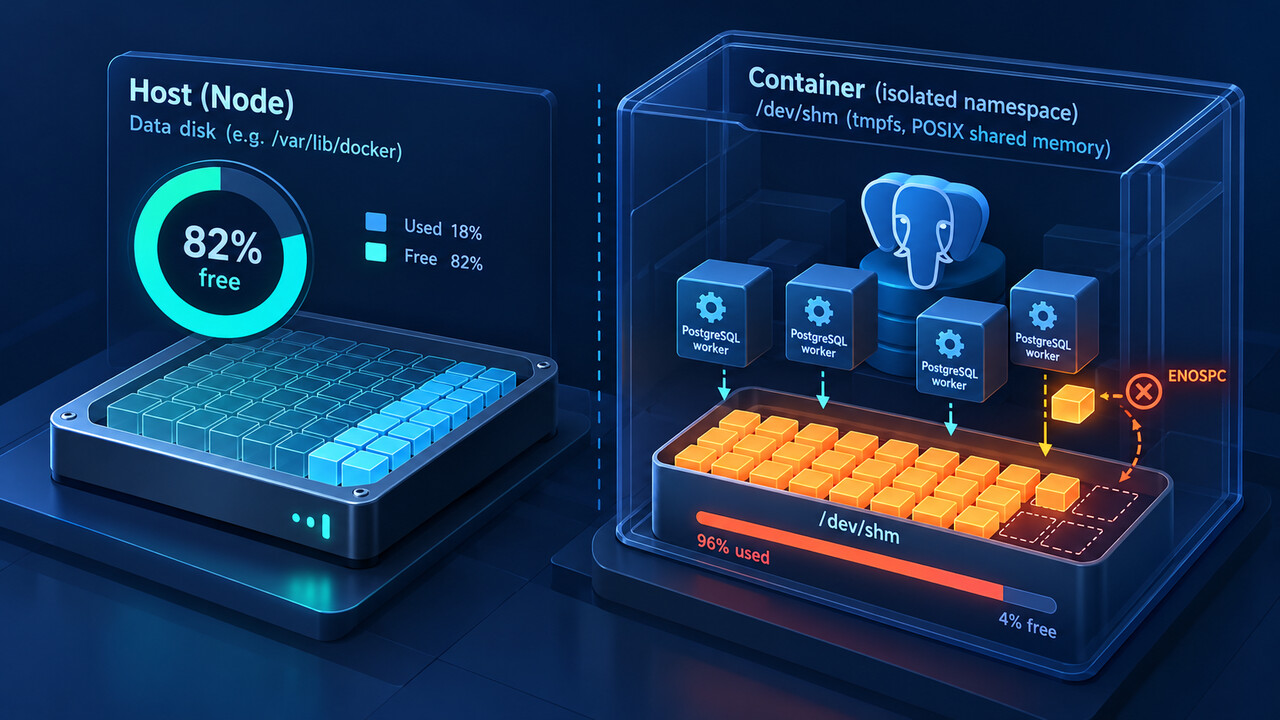
ENOSPC no demuestra que el disco de datos esté lleno. Conserva el error exacto, inspecciona el montaje desde el namespace de PostgreSQL, relaciona el pico con la carga fallida y cambia un solo límite antes de repetir la misma operación.
ENOSPC no demuestra que el disco de datos esté lleno. Conserva el error exacto, inspecciona el montaje desde el namespace de PostgreSQL, relaciona el pico con la carga fallida y cambia un solo límite antes de repetir la misma operación.
Las operaciones paralelas de PostgreSQL pueden usar memoria compartida dinámica. En Linux, POSIX shared memory suele vivir en un tmpfs en /dev/shm; un contenedor puede tener un montaje privado pequeño aunque host y volumen de datos tengan espacio.
1. Conserva la asignación y la identidad del runtime
Guarda error completo, tamaño solicitado, SQL o mantenimiento, PID backend, tiempos, base, request ID y el container ID, pod UID o service task que alojó ese proceso.
No empieces por la gráfica del volumen del host. ENOSPC solo indica un límite; ruta, implementación DSM y namespace dicen qué recurso revisar.
2. Inspecciona el montaje desde el namespace de PostgreSQL
En el mismo contenedor o pod ejecuta df -h /dev/shm, df -i /dev/shm y findmnt -T /dev/shm; guarda tamaño, uso, inodos, tipo y opciones.
Registra SHOW dynamic_shared_memory_type y ajustes paralelos. posix apunta a /dev/shm en Linux; otro tipo exige seguir su backing documentado.
3. Relaciona el pico con la carga fallida
Usa EXPLAIN sin ejecutar cuando convenga, registra max_parallel_workers_per_gather, consultas concurrentes y VACUUM solapado, y mide /dev/shm antes, durante y después de una reproducción controlada.
No uses shared_buffers o work_mem como remedio universal. Compara el crecimiento solicitado más DSM concurrente con el margen real del montaje activo.
4. Cambia un único límite demostrado
En Docker fija shm size para el servicio y recrea el contenedor; editar configuración no cambia el montaje ya activo. En Kubernetes, emptyDir en memoria debe caber en el presupuesto del pod.
Si no puedes ampliar con seguridad, limita workers o concurrencia. No borres archivos que parezcan de PostgreSQL en /dev/shm mientras el servidor esté vivo.
5. Exige una salida con la misma carga
Tras el rollout, vuelve al runtime activo, guarda findmnt y df nuevos y repite el mismo SQL, paralelismo y concurrencia representativa mientras observas el pico.
Acepta solo si la operación termina, queda margen medible, no aparece otro error DSM y la presión cabe en presupuesto. Si el fallo solo se desplaza, revierte.