Tecnología · GUÍA PRÁCTICA
Linux dice “inotify watch limit reached”: identifica el proceso y el límite antes de subir sysctl
ENOSPC de inotify puede significar agotamiento de instancias por usuario, de watches por usuario o un desbordamiento de cola distinto. Atribuye primero los descriptores y objetos vigilados; después reduce el alcance o aumenta solo el límite demostrado.
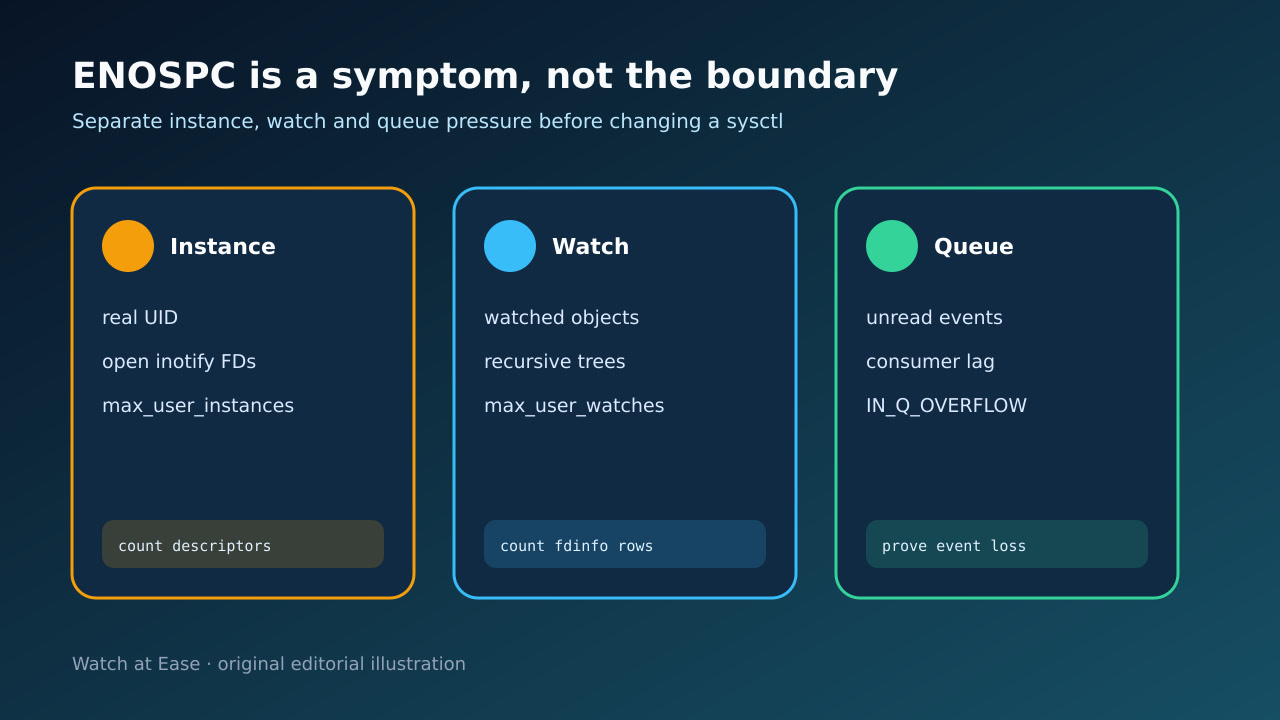
ENOSPC de inotify puede significar agotamiento de instancias por usuario, de watches por usuario o un desbordamiento de cola distinto. Atribuye primero los descriptores y objetos vigilados; después reduce el alcance o aumenta solo el límite demostrado.
max_user_instances y max_user_watches se contabilizan por ID de usuario real. max_queued_events limita los eventos en cola para una instancia inotify recién creada.
1. Conserva el llamador y la identidad contable
Antes de reiniciar, registra el mensaje ENOSPC completo, programa, PID, UID efectivo y real, límite de contenedor o servicio, raíz vigilada y primera hora. Guarda también los tres valores fs.inotify en el host que posee los objetos del kernel.
No deduzcas falta de disco por el nombre del errno ni pegues todavía un valor sysctl popular. Los tres controles responden preguntas diferentes y varios procesos bajo el mismo UID real comparten el cupo por usuario.
2. Separa instancias, watches y cola
Un fallo al crear una instancia apunta al límite de instancias; un fallo al añadir un watch apunta al límite de watches. Conserva la ruta de llamada porque una biblioteca puede ocultar qué syscall falló.
El desbordamiento de cola es diferente: la instancia ya existe, el consumidor lee demasiado despacio y aparece IN_Q_OVERFLOW. Aumentar max_user_watches no recupera eventos perdidos; la aplicación debe volver a explorar.
3. Atribuye el consumo vivo con fdinfo
Enumera descriptores inotify por PID y UID real e inspecciona /proc/<pid>/fdinfo/<fd>. Cuenta las líneas inotify por descriptor y proceso; conserva solo una muestra de wd, inode, device y mask para no publicar árboles de rutas sensibles.
Compara el proceso dominante con sus raíces previstas. Una herramienta recursiva puede necesitar muchos watches, pero árboles de dependencias duplicados, salidas generadas, bind mounts o bucles de reinicio multiplican el consumo.
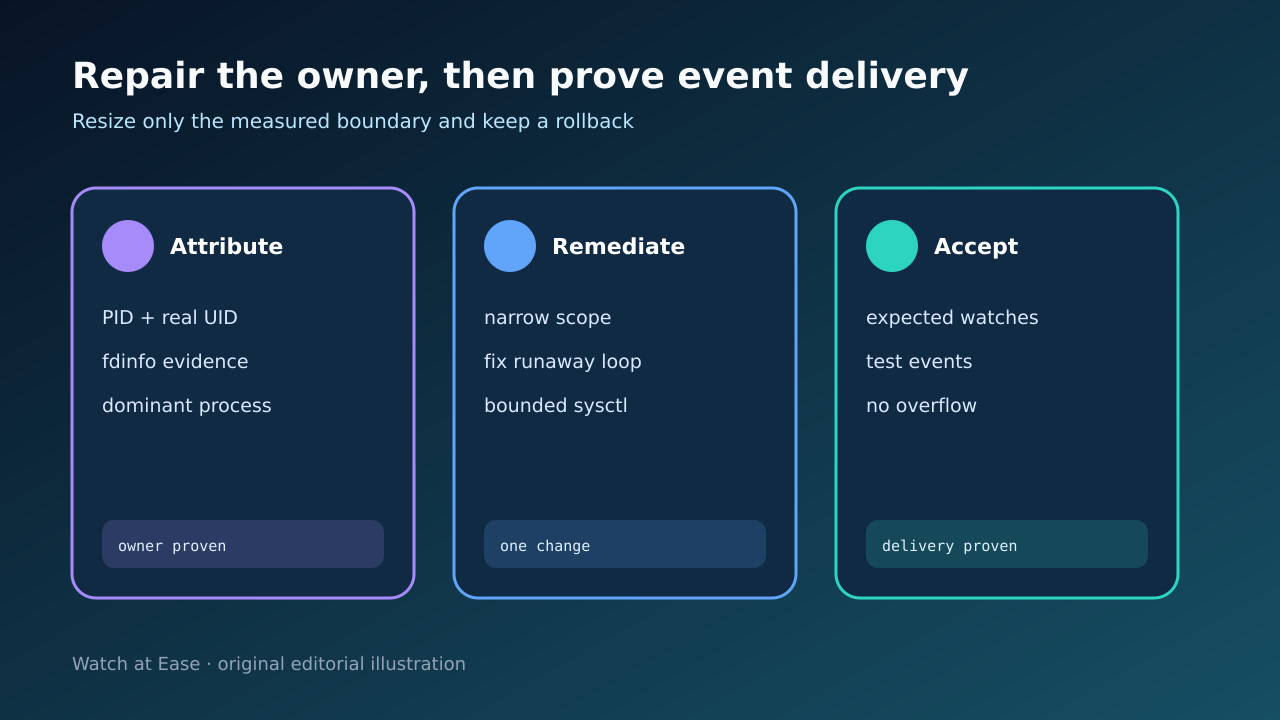
4. Repara la causa más estrecha con reversión
Elimina primero raíces duplicadas, excluye directorios generados o de dependencias cuando la herramienta lo permita y corrige bucles que filtren instancias. Reinicia solo el proceso identificado después de preservar pruebas.
Si la demanda legítima medida supera el límite demostrado, cambia únicamente ese ajuste mediante el mecanismo sysctl administrado. Guarda el valor anterior, motivo, pico esperado y condición de reversión; no subas los tres a la vez.
5. Demuestra los watches y la entrega tras reiniciar
Inicia una carga controlada y registra las instancias y watches nuevos del UID real y PID. Confirma que se estabilizan cerca del alcance esperado en vez de crecer tras cada compilación o reconexión.
Crea, modifica, renombra y elimina archivos representativos dentro de las raíces vigiladas. Verifica todos los eventos necesarios, ausencia de IN_Q_OVERFLOW y capacidad para otros usuarios. Revierte si falla la aceptación.