科技 · 實用指南
PDF可選字卻搜不到?先核文字映射與閱讀器,再做OCR
能反白不等於可正確擷取。同一問題頁比較字元及另一閱讀器,uni=yes或no都不能單獨定因。
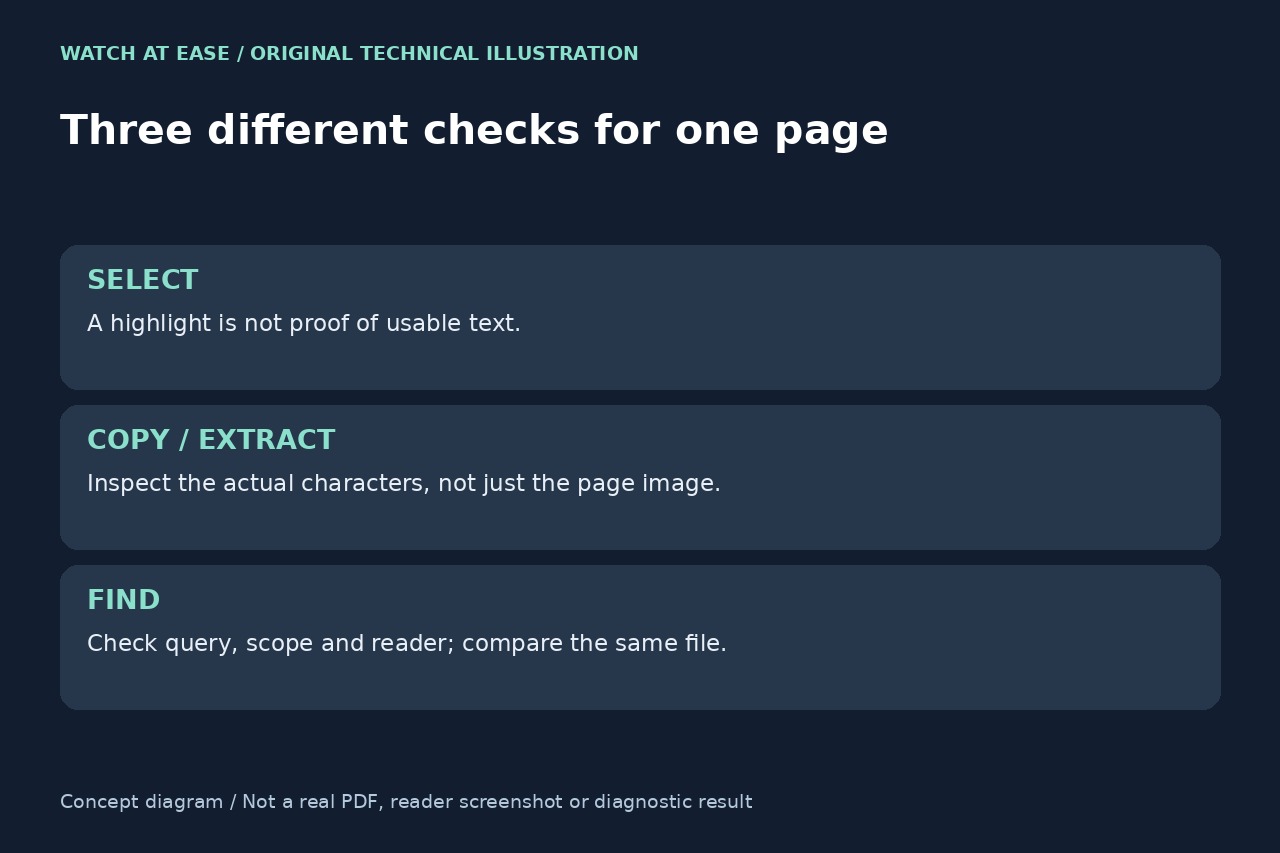
PDF外觀正確且可選字,搜尋仍可能錯。先核複製或擷取字元是否符合畫面,再比較同檔不同閱讀器,勿未對照就OCR或列印重製。
建立可重現案例
留原PDF並用副本,記閱讀器版本、實際頁序、短詞及選項。Acrobat當前文件Find先核整詞、大小寫,雲檔案庫及目錄索引是別的範圍。
試手打可見詞、貼短選取到Find,再貼本機私密純文字看字元。反白或別處成功,不證明此頁正常。
只讀一頁不改PDF
Poppler的 pdffonts -f 1 -l 1 "document.pdf" 列第一頁字型,將兩數換成問題頁實際序號。uni只報顯式ToUnicode;no不必然無法轉換,yes不保證映射正確。
pdftotext -f 1 -l 1 "document.pdf" - 在本機終端輸出而不改PDF,內容留本地。核錯誤狀態,權限或開檔錯不是空文字;預設及-layout排序不同,斷詞不等於映射損壞。
依對照選分支
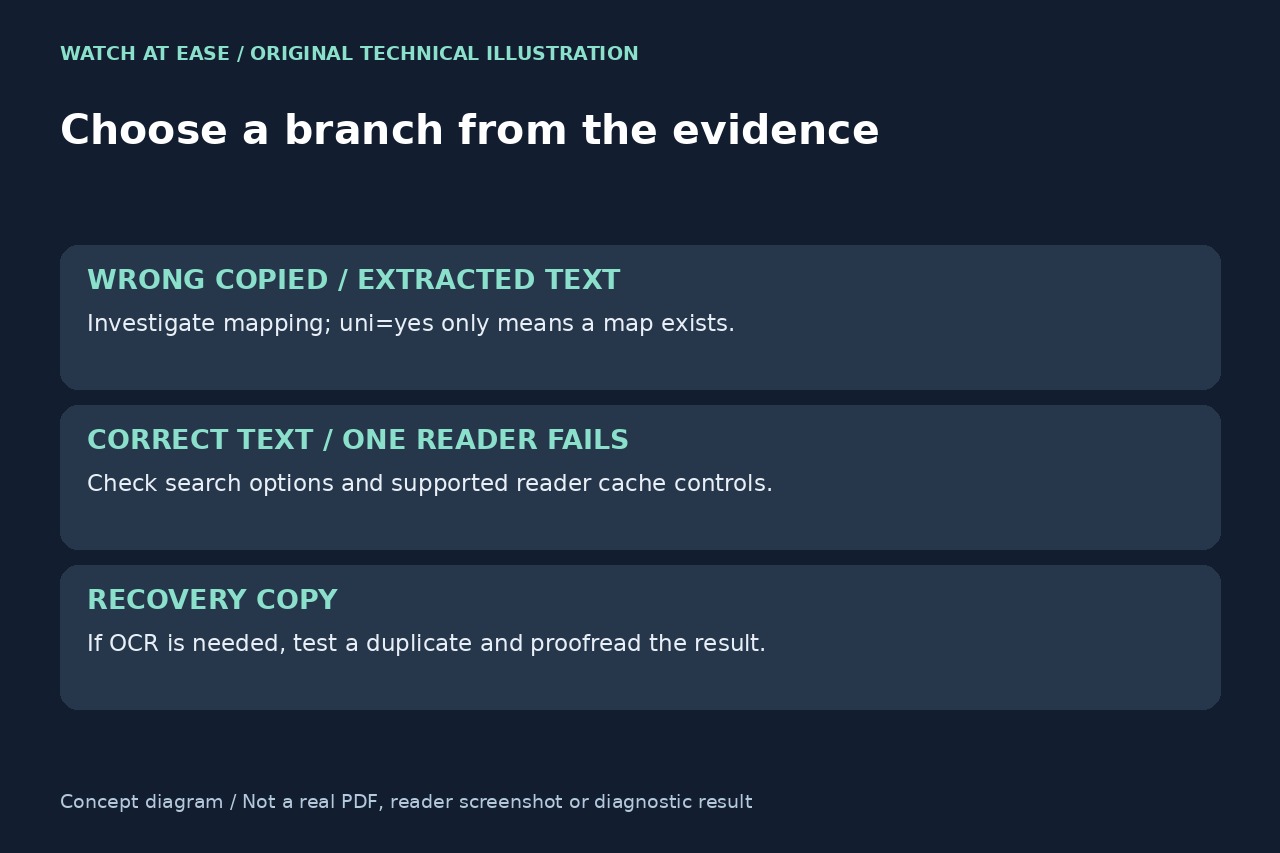
複製與擷取均錯字,映射才較可疑;正確擷取但單一閱讀器找不到,先查其設定或快取,仍非唯一原因證明。
Adobe的Search偏好提供Fast Find及Purge Cache Contents。僅在閱讀器分支用受支援清快取後重測。勿照舊論壇手改ID或CMap,把案例交製作者或支援。
需要才樣頁OCR並校對
純影像或原來源無法恢復的文字頁,可OCR產生工作副本。Scan & OCR可選頁與語言再建立搜尋層,先試副本問題頁,勿預設整份原件點陣化。
再匯出或OCR後核詞、數字、姓名及必要連結、表單、註解,保留來源與原PDF。可搜尋不等於完整準確,本文未診斷讀者檔或實測所有版本。