科技 · 实用指南
PDF文字能选中却搜不到?先查文本映射与阅读器,再做OCR
能高亮不代表文字可正常提取。对同一问题页比较字符与另一阅读器;字体的uni=yes或no都不能单独定因。
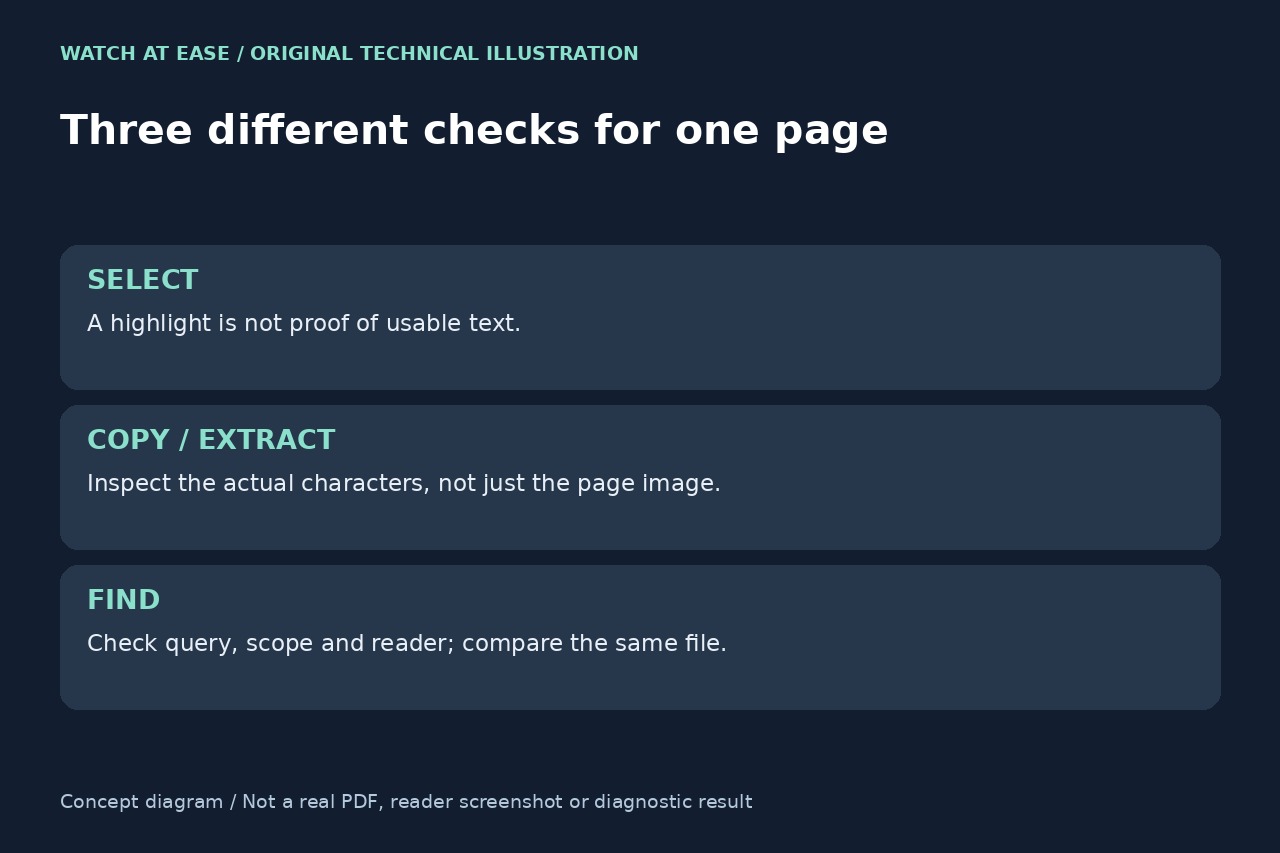
PDF外观正确、能选字,搜索仍可能出错。先核复制或提取后是否得到眼前的字符,再比较同一文件在不同阅读器的表现。未对照就OCR或打印重做,可能掩盖原因。
建立可重现的小案例
保留原PDF,用副本处理。记录阅读器及版本、实际页序、可见短词和搜索选项。Acrobat当前文件Find中,核整词和区分大小写是否过滤;云文件库或目录索引是另一搜索范围。
分别手打可见词、复制短段到Find,也粘到本地私密纯文本编辑器看实际字符。高亮、外观正确或别处搜索成功,都不证明此页文字正常。
只读检查一页,不改写PDF
有Poppler时,pdffonts -f 1 -l 1 "document.pdf" 列第一页字体,把两个页码都换成问题页实际序号。uni列表示显式ToUnicode映射存在;手册明确no不必然无法转换,yes也只说明存在而非正确。
pdftotext -f 1 -l 1 "document.pdf" - 将该页文字送本地终端,不重写PDF,隐私内容留本地。核输出与错误状态;权限或开文件失败不是文字为空。默认提取和-layout顺序可能不同,短语断开不等于字符映射已损坏。
按证据选择分支
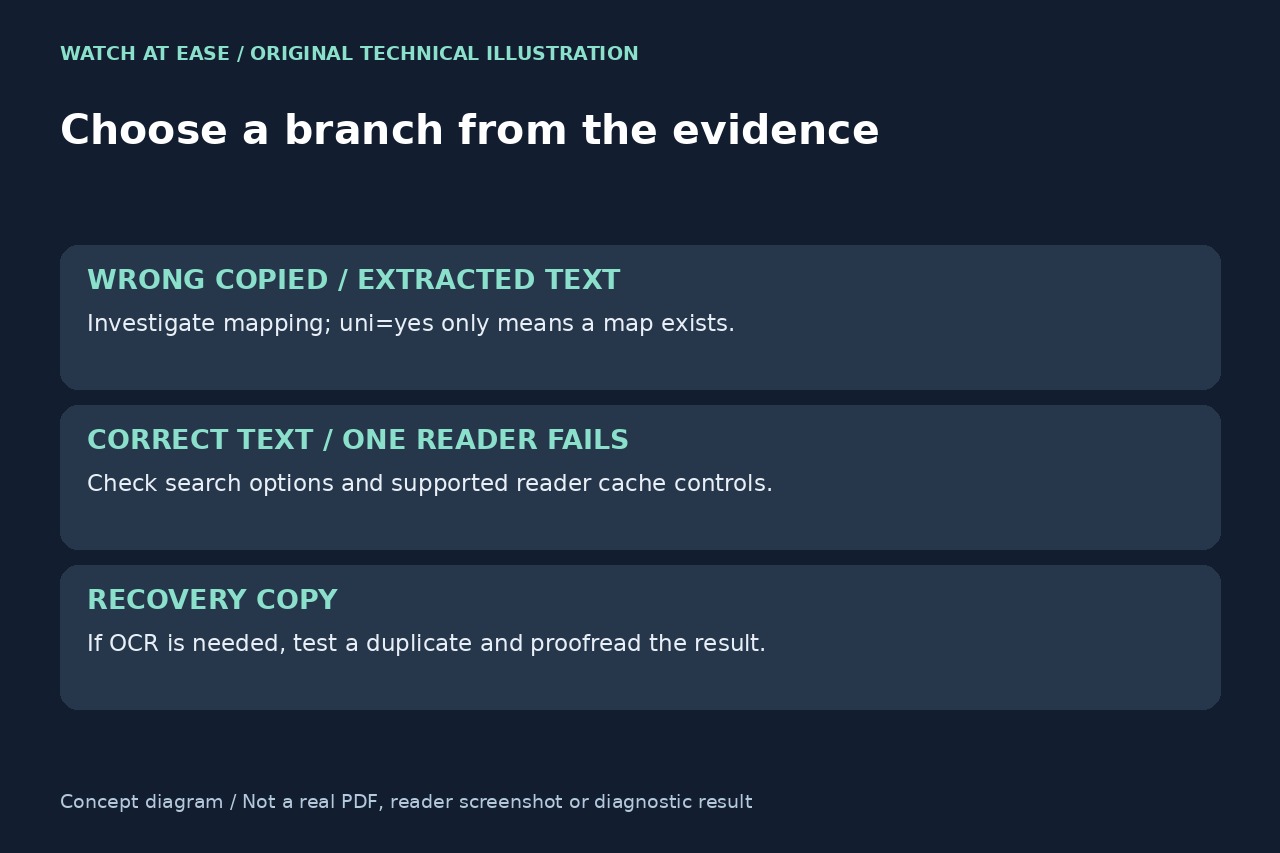
复制和提取都变错字符,映射问题才较可疑;准确提取同一词而仅一个阅读器找不到,先查该阅读器设置或缓存。两类对照都不能独自锁定唯一原因。
Adobe说明Search偏好里有Fast Find搜索信息缓存和Purge Cache Contents。仅在阅读器特定分支考虑受支持清缓存,再测原文件原词。别根据旧论坛案例手改PDF ID或CMap,交制作者或支持人员排查可重现案例。
必要时小范围OCR,再校验结果
纯图像页,或现有来源无法恢复的损坏文字页,可考虑OCR得到工作副本。Adobe的Scan & OCR可选页范围和语言,再建可搜索层。先在副本试问题样页,不默认把整份原件栅格化。
任何重新导出或OCR后,对可见页面核已知词、数字和姓名,再检查链接、表单、注释等所需功能,保留源文件和原PDF。能搜到不等于识别完整准确;本文未诊断读者文件,也未测试所有Acrobat版本。