기술 · 실용 가이드
pandas가 CSV 열 이름에 .1을 붙였나요? 삭제 전에 위치를 보존하세요
접미사는 pandas의 중복 이름 처리일 수도, 원본 이름일 수도 있다. 원본 헤더와 위치 매핑을 남긴 뒤 이름 변경·선택·삭제를 결정하자.
pandas가 일부 이름에 접미사를 붙였다고 .1로 끝나는 열을 전부 지우면 안 된다. 원본에 a.1이라는 정상 이름이 있을 수 있다. DataFrame 이름이 고유하다고 원본 헤더도 고유한 것은 아니다.
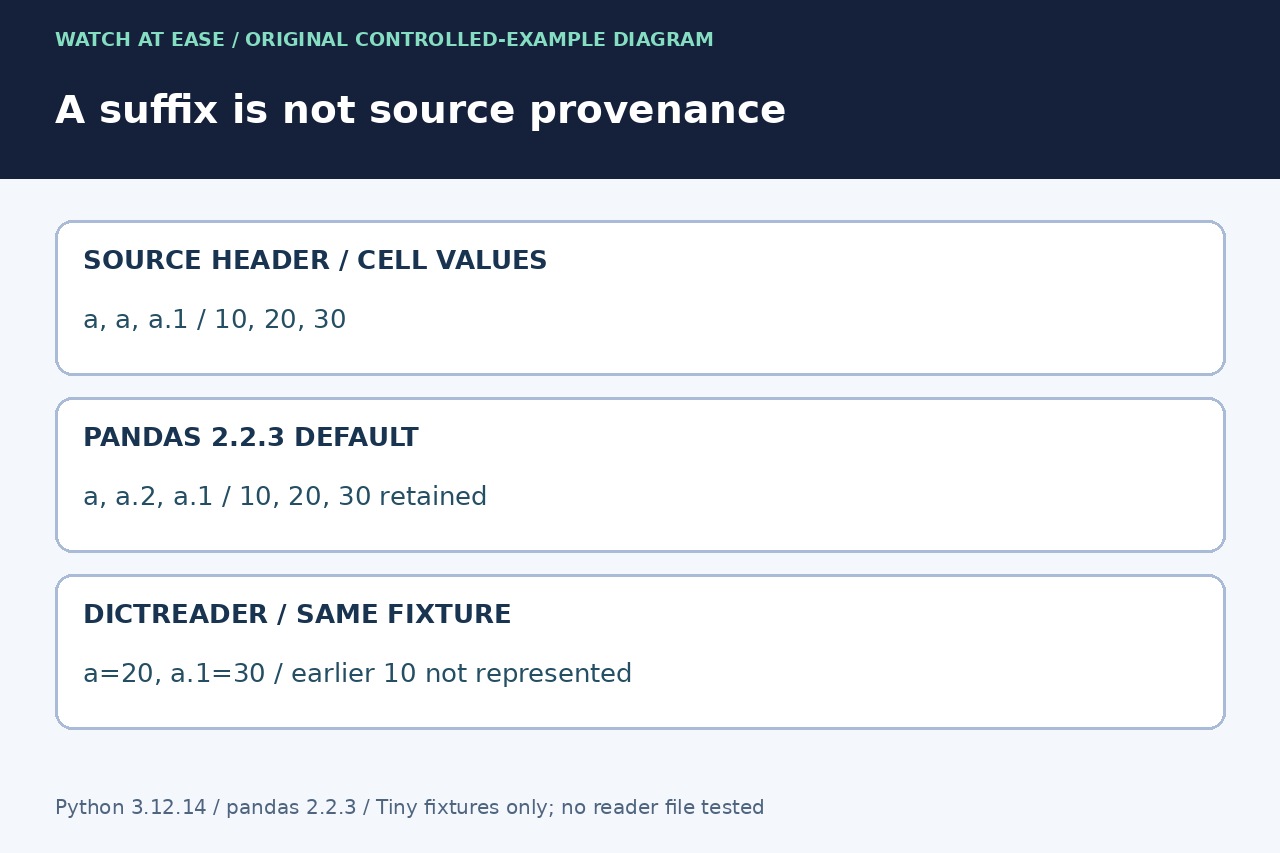
Python 3.12.14와 pandas 2.2.3의 작은 시험에서 a,a,a.1은 a,a.2,a.1이 됐으며 세 값이 유지됐다. 같은 파일을 먼저 csv.DictReader로 읽으면 반복 a 키에는 뒤의 값만 남았다. 서로 다른 변환이다.
원본 헤더를 순서 있는 목록으로 읽기
먼저 import pandas as pd를 실행한다. 원본 CSV 바이트를 보관한다. 여기의 쉼표 구분·한 줄 헤더 예제는 csv와 io를 가져온 뒤 header = next(csv.reader(io.StringIO(text)))로 반복 이름까지 보존한다. pd.read_csv(..., nrows=0).columns만 보면 이미 바뀐 이름이다.
실제 구분자·인용·인코딩·헤더 위치를 맞춰야 한다. 인용된 "last,name"은 한 필드이므로 첫 물리적 줄을 쉼표로 나누면 안 된다. 머리말·주석·여러 줄 헤더는 그에 맞는 절차가 필요하다.
중복 이름과 중복 값을 구분하기
시험은 a,a,a.1 아래에 10,20,30을 넣었다. 기본 이름 a,a.2,a.1에서 세 번째 a.1은 원본 이름이고 두 번째 a가 a.2를 받았다. 점과 숫자 패턴으로 지우거나 접미사를 제거하면 이 차이가 사라진다.
이름이 같아도 값이 같다는 뜻은 아니다. DictReader 결과는 a='20', a.1='30'으로 앞의 10이 사전에 없다. 상위 단계의 사전 변환에서 잃었다면 원본 CSV로 돌아가야 하며 pandas 이름 변경으로 복원할 수 없다.
각 위치에 고유 내부 이름 부여하기
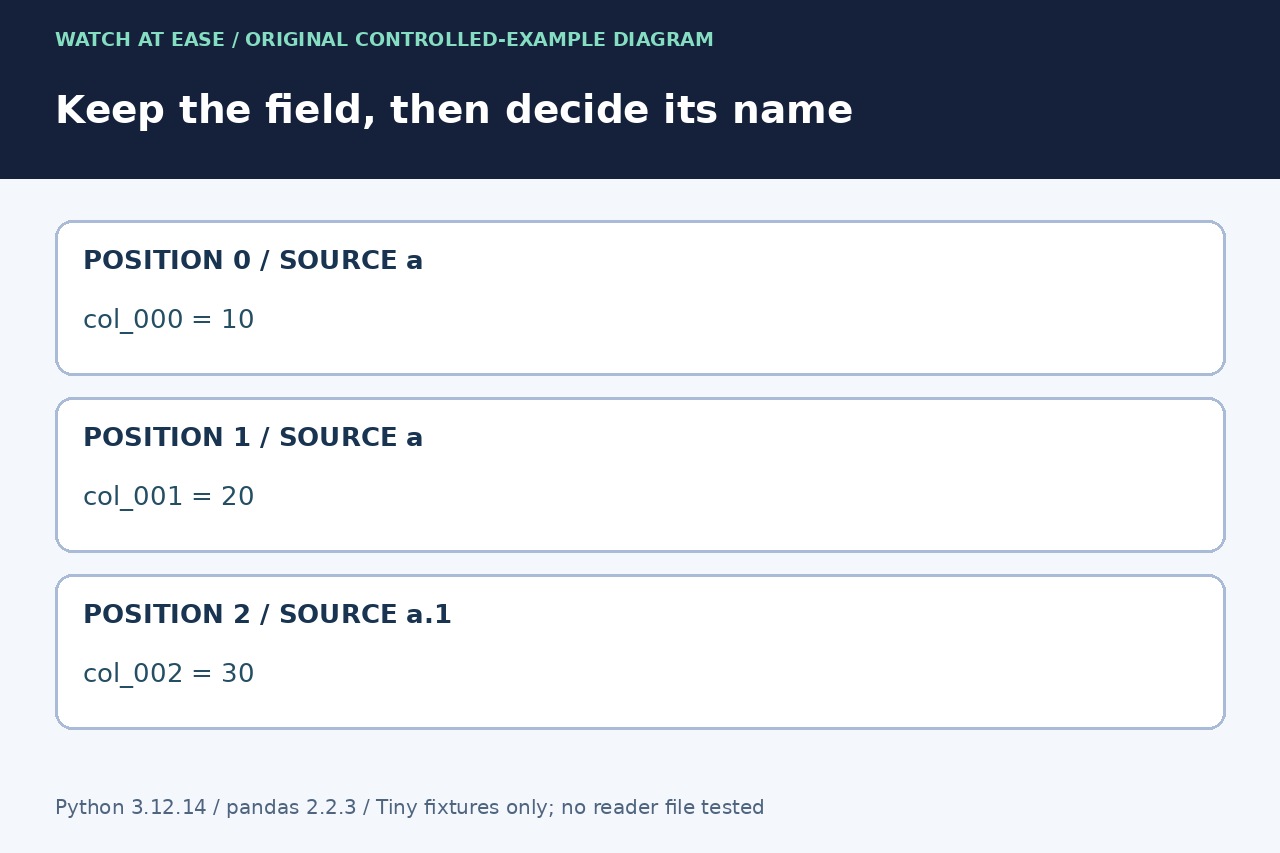
이 단일 헤더 CSV에서는 internal = [f'col_{i:03d}' for i in range(len(header))]를 만들고 list(enumerate(zip(header, internal)))를 저장한다. 이어 df = pd.read_csv(io.StringIO(text), header=0, names=internal, dtype=str, keep_default_na=False)로 위치별로 읽는다.
시험의 col_000·col_001·col_002에는 '10'·'20'·'30'이 남았다. 인용 쉼표가 있는 다른 헤더도 네 필드를 유지했다. 문자열·결측 설정은 이 텍스트 예제용이며 실제 형식 정책은 따로 정한다. 합의 없이 공백이나 Unicode를 정규화하지 않는다.
거부 또는 명시적 매핑을 선택하고 검증하기
수신 시스템이 원본의 고유 이름을 요구하면 len(header)와 len(set(header))가 다른 입력을 거부하고 반복 위치를 보고한다. 의도된 중복은 데이터 소유자가 위치별 의미를 승인해야 한다. 편리한 접미사만 보고 남길 열을 고르지 말자.
usecols·이름 변경·내보내기 전에 필드 수·매핑·서로 다른 대표 값을 확인한다. 설치 버전은 mangle_dupe_cols=False를 알 수 없는 인수로 거부했고 현재 API에도 없다. 작은 메모리 예제만 시험했으며 사용자 파일이나 pandas 3.x는 시험하지 않았다. 배포 버전에서 재확인하고 원본·매핑을 보존한다.