기술 · 실용 가이드
pandas skip인데 잘못된 CSV 행이 남나요? usecols 전에 레코드 검증
on_bad_lines는 파서 정책이지 완전한 스키마 검사가 아닙니다. 열 선택 전에 논리 필드를 세고 읽은 뒤 레코드를 대조하세요.
CSV가 오류 없이 읽혀도 짧은 레코드, 버려진 추가 필드나 의도하지 않은 인덱스가 남을 수 있습니다. 현재 read_csv 문서는 on_bad_lines의 잘못된 행을 필드가 너무 많은 행으로 정의합니다. 업무상 잘못된 모든 레코드를 제거한다는 보장은 아닙니다.
건너뛰기와 검증 구분
생산자의 구분자, 인용 규칙, 인코딩과 기대 스키마부터 확인합니다. pandas 버전, 엔진, header, names, index_col, usecols, 빈 줄·주석 처리와 잘못된 행 정책을 기록하세요. .csv 확장자만으로 그 선택을 정할 수는 없습니다.
현재 API에서 warn도 해당 행을 건너뛰며 skip은 그 경고를 내지 않습니다. 둘 다 무손실 복구 스위치는 아닙니다. 원본을 보존하고 제외된 레코드의 행방을 설명할 수 있는 명시적 거부 규칙만 사용하세요.
열 선택 전에 논리 레코드 감사
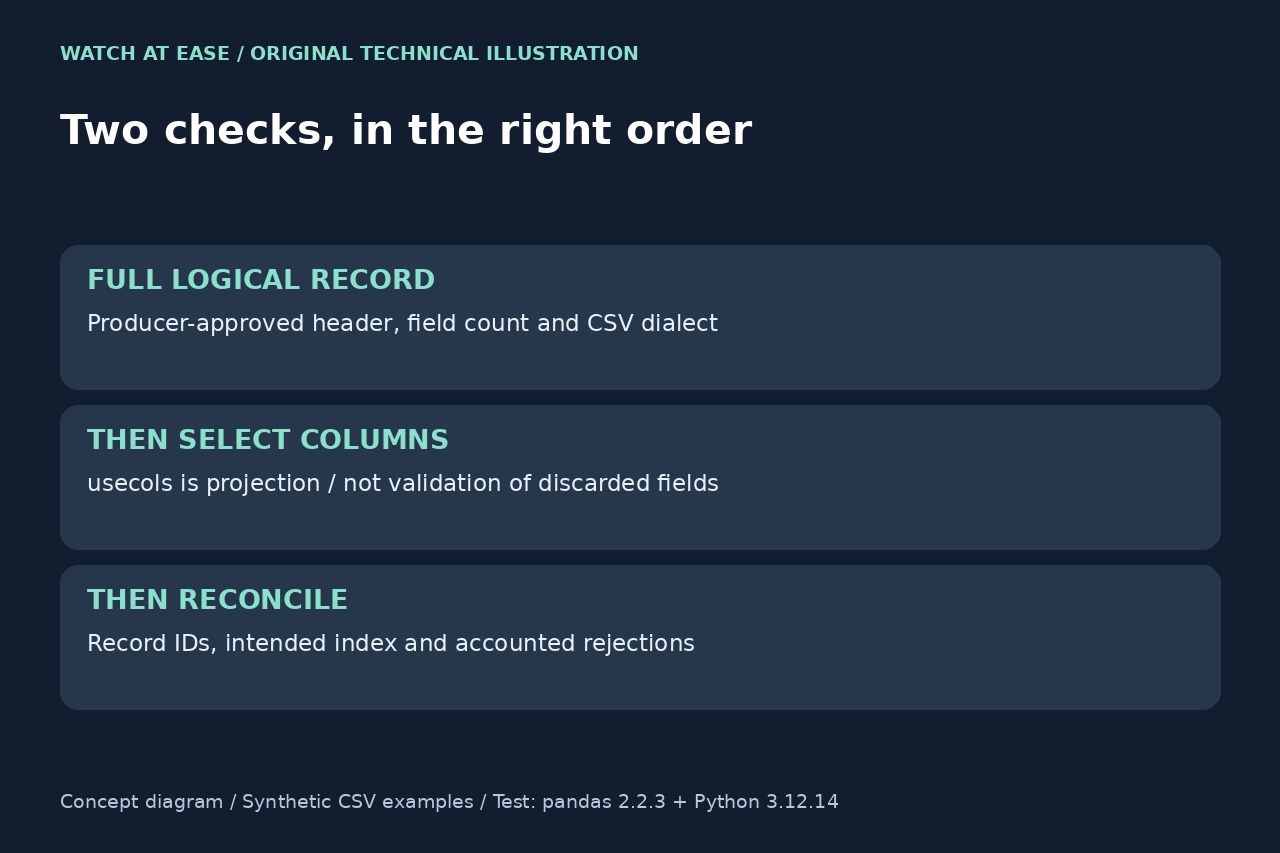
확인된 인코딩과 방언으로 작업 사본을 newline=''로 열고 csv.reader(..., strict=True)를 순회합니다. 헤더를 승인된 이름과 맞추고 모든 논리 데이터 레코드의 len(row)를 요구 폭과 비교하세요. 불일치 레코드와 원본 위치는 따로 보존하며 원시 텍스트의 쉼표를 세지 마세요.
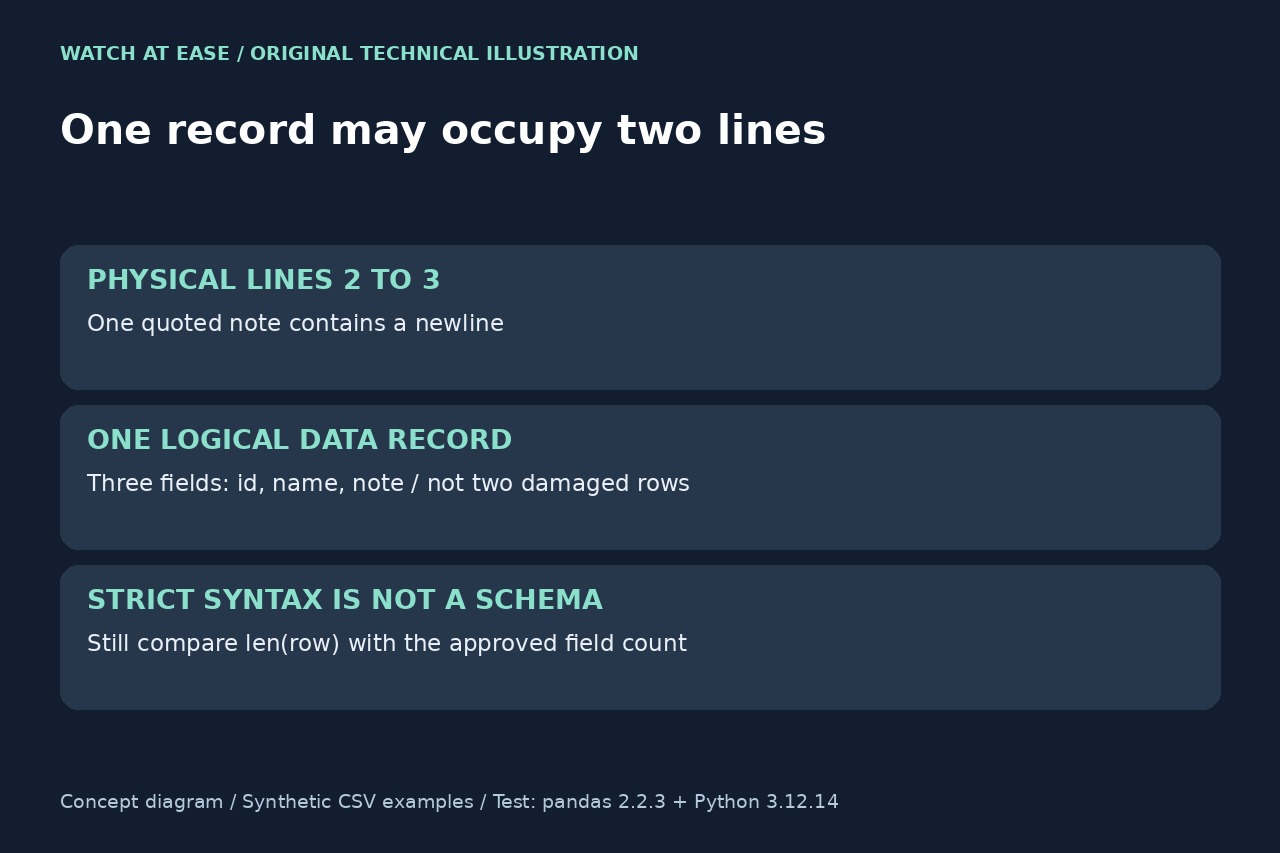
strict=True는 CSV 문법을 검사하며 스키마는 검사하지 않습니다. 각 레코드 전후의 reader.line_num로 물리 줄 범위를 기록하세요. 인용된 줄바꿈은 한 레코드를 여러 줄로 만듭니다. 수를 비교하기 전에 빈 줄·주석 규칙을 맞추고 파싱 오류가 나면 경계를 추측하지 말고 중단합니다.
네 가지 통제 실험이 보여준 함정
pandas 2.2.3과 Python 3.12.14에서 합성 세 열 CSV를 시험했습니다. 뒤의 네 필드 레코드는 기본값에서 ParserError가 났고 skip은 삭제했습니다. usecols를 추가하자 추가 필드만 버리고 레코드는 남았습니다. 두 필드 레코드는 결측값과 함께 남았습니다. 이 설치 환경의 결과이며 현재 pandas 3.0.6 실행 시험은 아닙니다.
첫 데이터가 네 필드면 기본 읽기는 인덱스를 추론해 값을 이동시켰습니다. index_col=False는 세 열을 반환했지만 데이터 손실 경고를 냈으며 레코드를 고친 것은 아닙니다. 별도의 인용된 여러 줄 필드는 물리 두 줄에 걸친 유효한 세 필드 레코드 하나였습니다. 단일 옵션으로 네 사례 모두를 인증하지 못합니다.
검증 가능한 규칙으로만 복구
방언이나 헤더가 잘못됐다면 사본에서 읽기 설정을 고칩니다. 실제로 손상된 레코드는 올바른 재내보내기를 받거나 명시적 규칙으로 격리하세요. 마지막 필드를 무조건 지우지 마세요. 예상 밖 구분자가 의미 있는 값을 중간에서 나눴을 수 있습니다.
읽은 뒤 의도한 열 순서와 인덱스, 필수 ID, 중복과 업무 제약을 검사합니다. 같은 필터 규칙 아래 수락·거부 논리 레코드를 원본 감사와 대조하세요. 필드 수 일치는 구조적 증거일 뿐 값의 의미나 열 선택 뒤 모든 원정보 보존을 입증하지는 않습니다.