テクノロジー · 実用ガイド
pandasがCSV列名に.1を追加?削除前に位置対応を残す
接尾辞はpandasの重複回避の場合も、元からある名前の場合もある。元ヘッダーと位置を保存してから選択・改名・削除する。
pandasが一部の名前に接尾辞を付けたからといって、.1で終わる列をすべて削除してはいけない。元のCSVにa.1という名前がある場合がある。DataFrameの名前が一意でも元のヘッダーが一意とは限らない。
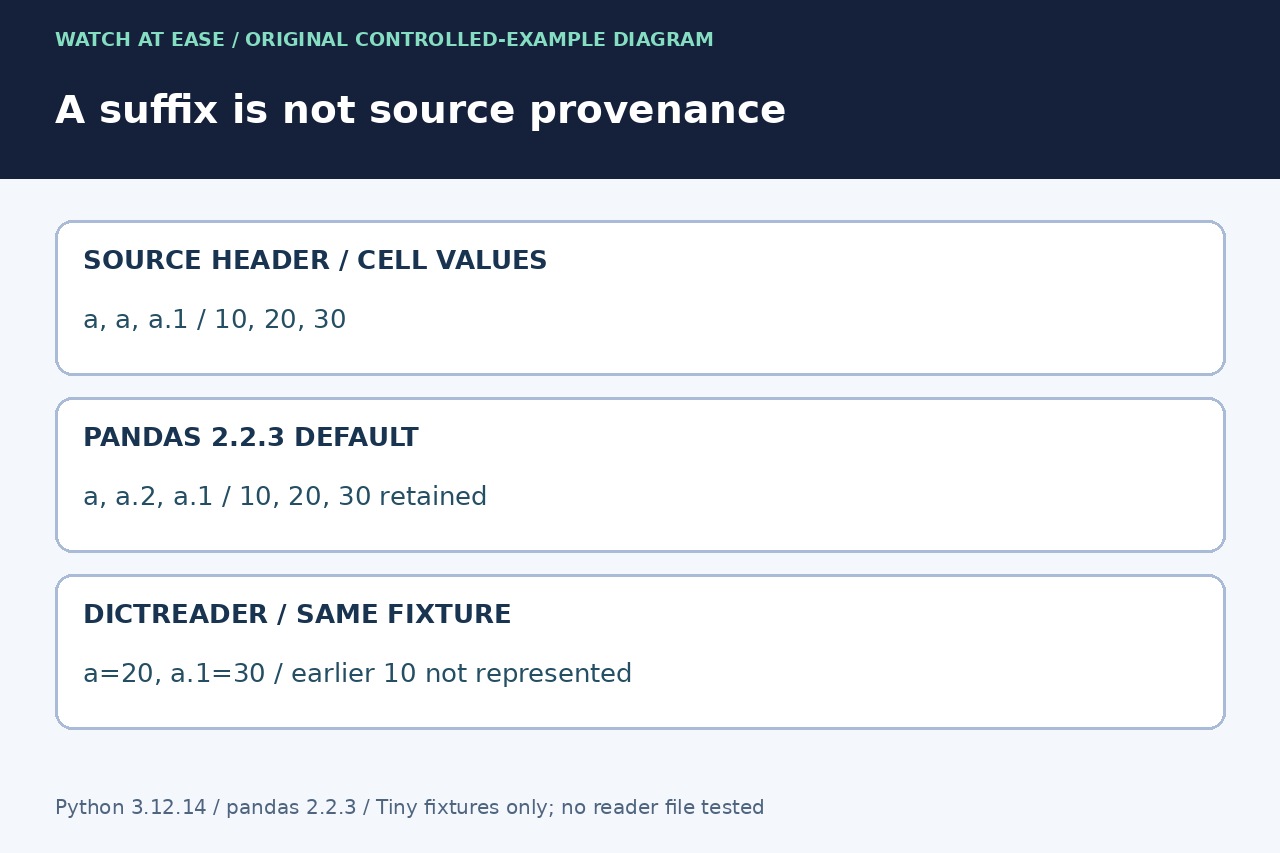
Python 3.12.14とpandas 2.2.3の小規模テストではa,a,a.1がa,a.2,a.1になり、三つの値は残った。一方、先にcsv.DictReaderを通すと重複するaの後の値だけが残った。異なる変換として考える必要がある。
元ヘッダーを順序付きリストで読む
まず import pandas as pd を実行する。元のCSVバイトを保存する。ここで使うカンマ区切り・一行ヘッダーならcsvとioを読み込み、header = next(csv.reader(io.StringIO(text)))で重複を含むリストを得る。pd.read_csv(..., nrows=0).columnsだけでは、すでに変更された名前を見てしまう。
区切り、引用符、文字コード、ヘッダー位置を実ファイルに合わせる。引用された"last,name"は一つの名前なので、最初の物理行をカンマで分割しない。前書きやコメント、複数行ヘッダーは別途正確に扱う。
重複名と重複データを分ける
テストはa,a,a.1の下に10,20,30を置いた。結果a,a.2,a.1では、元の三列目a.1を避けて二番目のaがa.2になる。接尾辞の除去や点と数字による削除はこの区別を失わせる。
名前の重複は値の一致を意味しない。同じデータのDictReader結果はa='20'、a.1='30'となり、先の10は辞書にない。上流の辞書化で値を失ったなら元CSVに戻る。pandasの改名だけでは復元できない。
各位置に一意な内部名を割り当てる
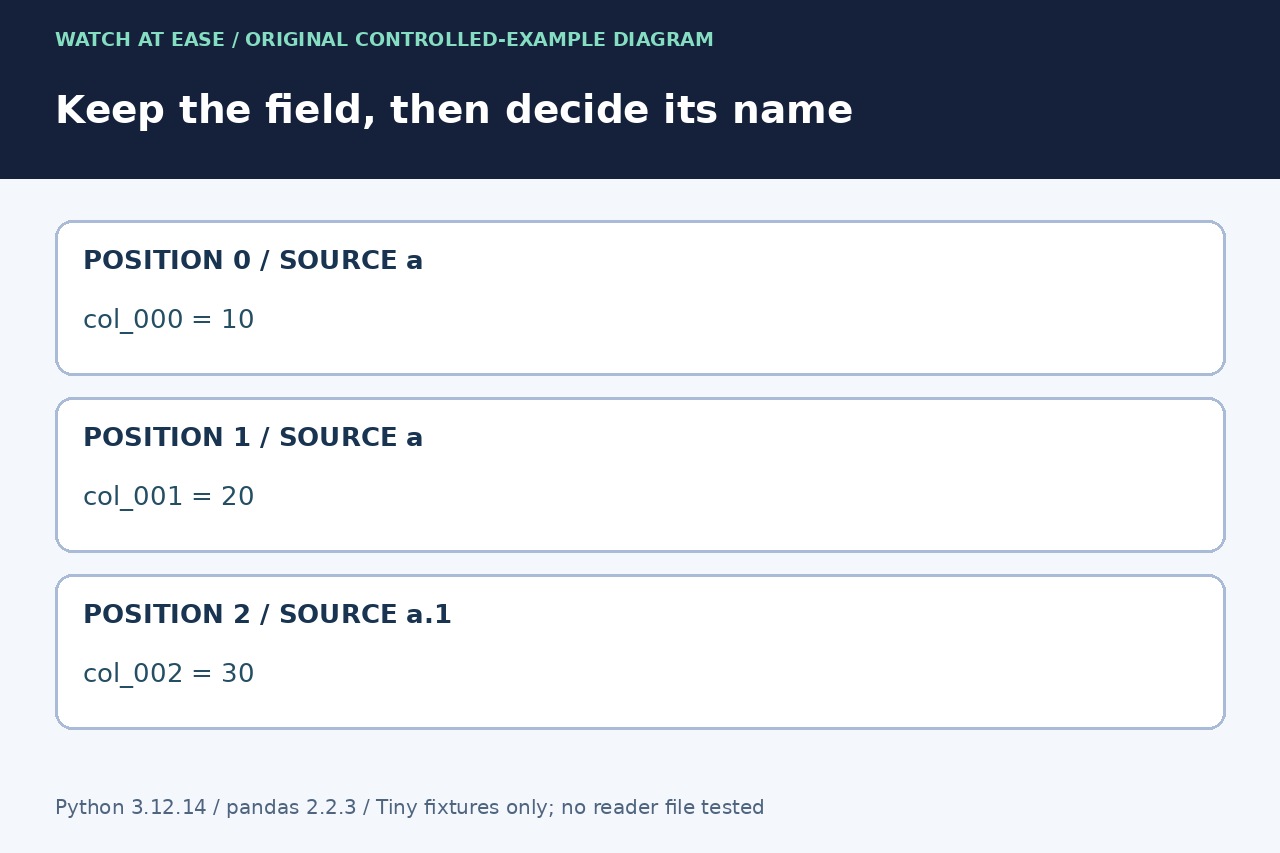
この単一ヘッダーCSVではinternal = [f'col_{i:03d}' for i in range(len(header))]を作り、list(enumerate(zip(header, internal)))を保存する。続いてdf = pd.read_csv(io.StringIO(text), header=0, names=internal, dtype=str, keep_default_na=False)で位置別に読む。
テストではcol_000、col_001、col_002に'10'、'20'、'30'が残った。引用カンマを含む別ヘッダーも四列を保持した。文字列・欠損値設定は今回の例用であり、実際の型方針は別途決める。合意なしに空白やUnicodeを正規化しない。
拒否か明示的対応を選んで検証する
下流が元の一意名を要求するならlen(header)とlen(set(header))が異なる入力を拒否し、重複位置を報告する。意図した重複ならデータ所有者が各位置の意味を承認する。便利な接尾辞だけで採用列を選ばない。
usecols、改名、出力の前に列数・対応・異なる代表値を確認する。mangle_dupe_cols=Falseは導入済み版で未知の引数となり、現行APIにもない。試したのは小さなメモリー例で、読者のファイルやpandas 3.xではない。運用版で確認し原本と対応を残す。