テクノロジー · 実用ガイド
pandasのskipでも不正CSVが残る?usecolsの前にレコードを検証
on_bad_linesは解析方針であり完全なスキーマ検証ではない。列選択前に論理フィールドを数え、読込後にレコードを照合する。
CSVはエラーなく読めても、短いレコード、捨てられた余剰値、意図しない索引が残り得る。現行read_csv文書でon_bad_linesの対象はフィールドが多すぎる行だ。業務上不正な全レコードを取り除く保証ではない。
スキップと検証を分ける
出力元の区切り、引用、文字コード、期待するスキーマを確認する。pandasの版、エンジン、header、names、index_col、usecols、空行・コメント処理、不正行方針を記録する。.csvという拡張子だけでは決まらない。
現行APIではwarnも該当行を捨て、skipは対応する警告を出さない。どちらも無損失の修復設定ではない。原本を保存し、除外レコードの行方を説明できる明示ルールだけを使う。
列選択の前に論理レコードを監査
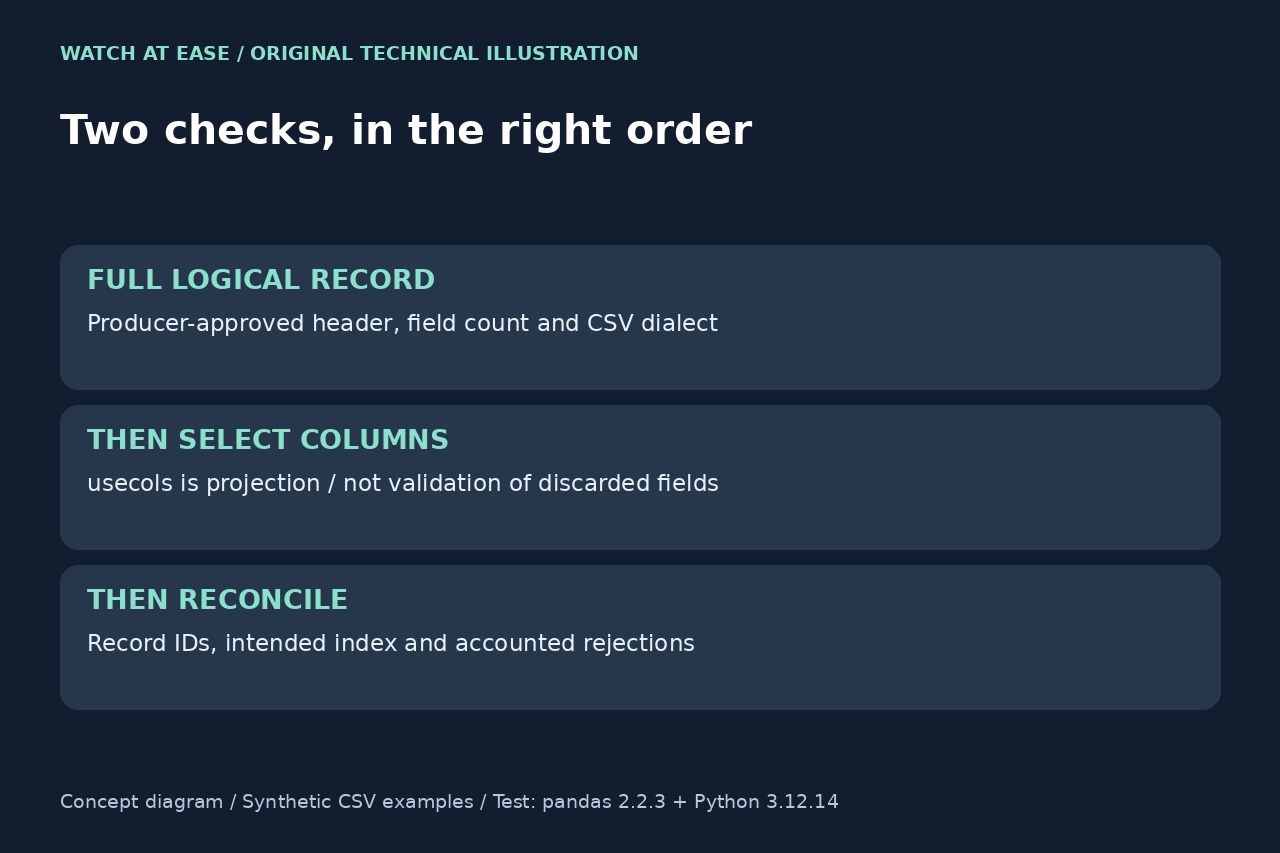
確認済みの文字コードと方言で作業コピーをnewline=''で開き、csv.reader(..., strict=True)を反復する。ヘッダーを承認された名前と照合し、各データレコードのlen(row)を必要な幅と比較する。不一致と元位置は別に保存し、生テキストのカンマ数で判定しない。
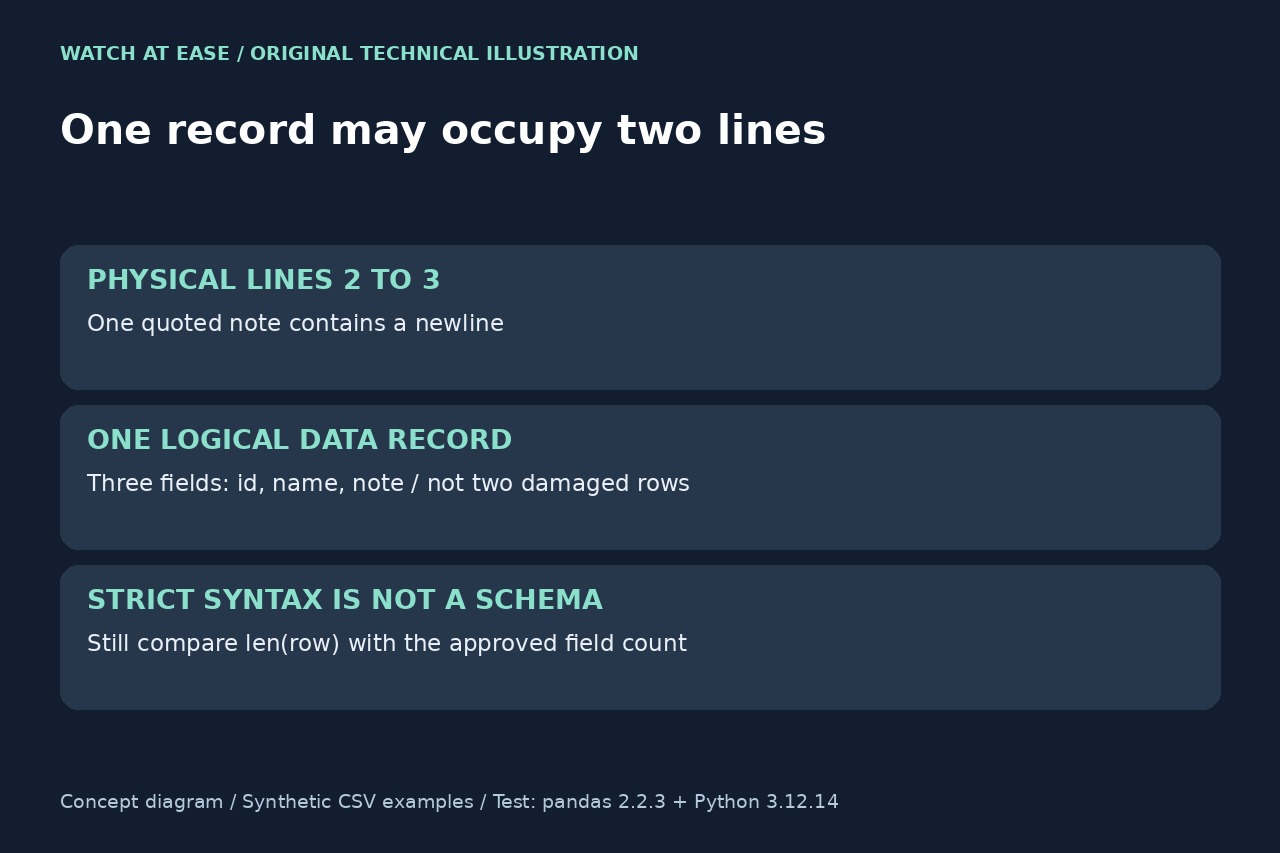
strict=TrueはCSV構文を確認するだけでスキーマではない。各レコード前後のreader.line_numで物理行の範囲を記録する。引用内改行で一つのレコードが複数行になる。空行・コメント規則をそろえ、解析エラーで境界を推測せず停止する。
四つの対照実験が示す違い
pandas 2.2.3とPython 3.12.14で合成3列CSVを試した。途中の4フィールド行は既定でParserErrorとなり、skipでは削除された。usecols追加では余剰値だけ捨ててレコードが残り、2フィールド行は欠損値付きで残った。この環境だけの結果であり、現行pandas 3.0.6の実行試験ではない。
最初のデータ行が4フィールドだと既定読込は索引を推定して値をずらした。index_col=Falseでは3列を返すがデータ損失を警告し、修復にはならなかった。別の引用内改行の例は、物理2行にまたがる有効な3フィールドの1レコードだった。一つの設定で全四例を認証できない。
検証できる規則だけで修復
方言やヘッダー指定が違うならコピー上で設定を直す。真に不正なレコードは正しい再出力を求めるか、明示ルールで隔離する。最後の値を機械的に消さない。余分な区切りが意味のある値を途中で割った可能性がある。
読込後に列順、意図した索引、必須ID、重複、業務条件を確認する。同じ除外条件で採用数と拒否数を元の論理レコード監査に照合する。幅の一致は構造上の証拠にすぎず、値の意味や列選択後の全情報保持を証明しない。