科技 · 實用指南
pandas CSV 編號設為字串仍變動?逐步追蹤匯入前後的值
四列對照實驗區分數值推斷、缺失值規則與已寫入CSV的損失;事後轉字串無法全部修復。
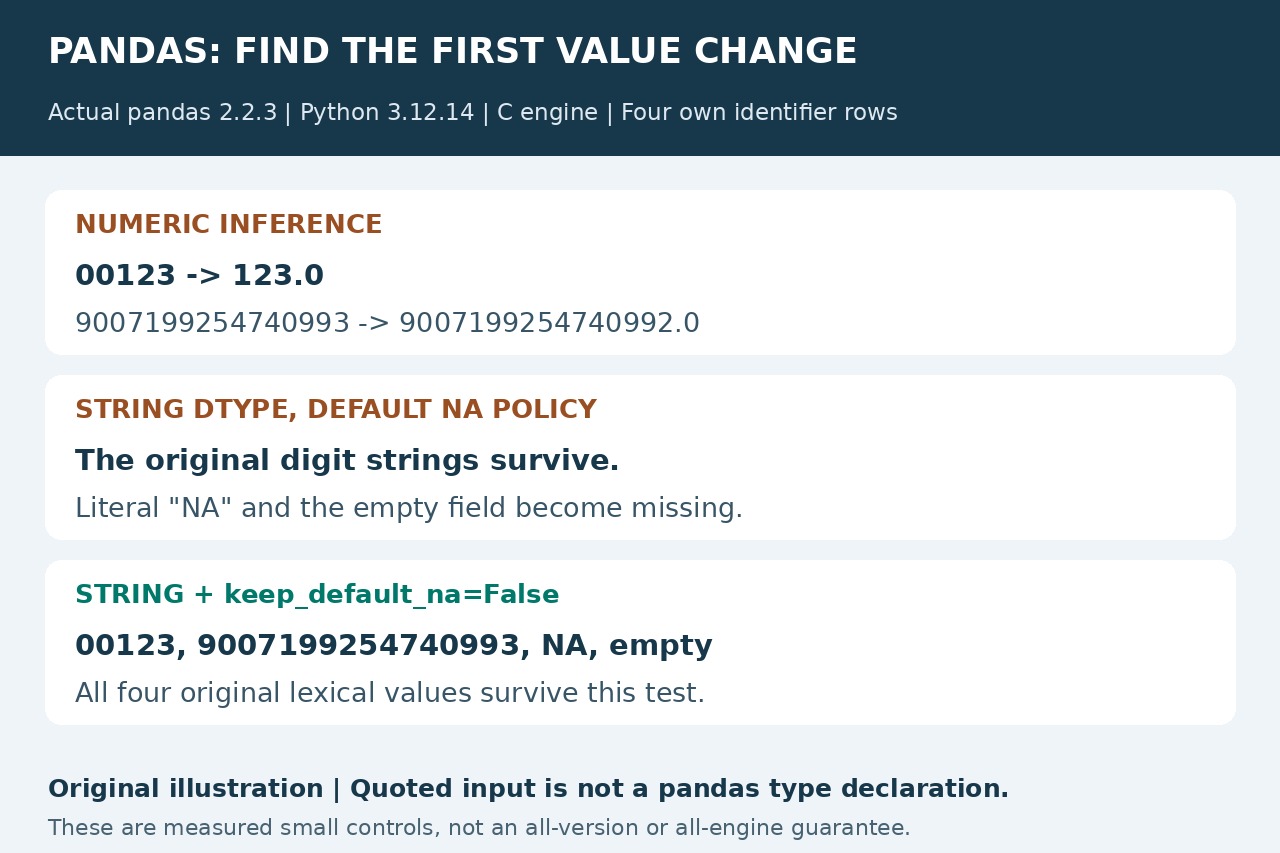
CSV編號發生變動時,應先比較原始欄位與各處理階段的值,再考慮追加型別轉換。字串型別不會自動關閉缺失值辨識,以字串讀取已受損的匯出檔,也無法重建先前數值轉換丟掉的數字。
我們以Python 3.12.14、pandas 2.2.3與C解析器測試四個已宣告的編號值:00123、9007199254740993、字面文字NA及空欄位,13項檢查通過。這些是小型受控樣本,其中NA明確定義為文字;應用本身的缺失值規則仍須另行決定。
從原始欄位與已知結構開始
保留原始CSV,記錄編碼、分隔符號、引號規則、表頭與編號欄,依實際方言解析工作副本。Python的csv.reader通常回傳欄位字串,不自動轉成數值;建立文字基準時不要使用QUOTE_NONNUMERIC。將欄位映射成字典之前,先核對表頭位置。
記錄精確樣本值,而非只看格式化顯示。CSV引號負責界定欄位,不是pandas的型別宣告。所連結的Excel指南說明試算表匯入的相同原始檔邊界,表頭指南則另行處理重複名稱。檔案雜湊記錄位元組身分,但單獨計算本機雜湊,不能判定業務值是否正確。
分別設定文字型別與缺失值策略
先import pandas as pd,測試中使用pd.read_csv('input.csv', engine='c', dtype={'id': 'string'}, keep_default_na=False)。在已知UTF-8樣本裡,它保留00123、精確的大編號、字面NA與空字串;只設定string時,數字雖保留,後兩項仍成為缺失值。
keep_default_na=False影響整次讀取的缺失標記辨識,不只影響id欄。此處用它檢查原始文字,並不表示每一欄的空白都有效。應依提供方的結構規格,逐欄規定缺失標記與型別,再驗證規則。不要為了消除錯誤,任意把缺失值改成零或字面文字'nan'。
確認損失是否早於目前讀取器
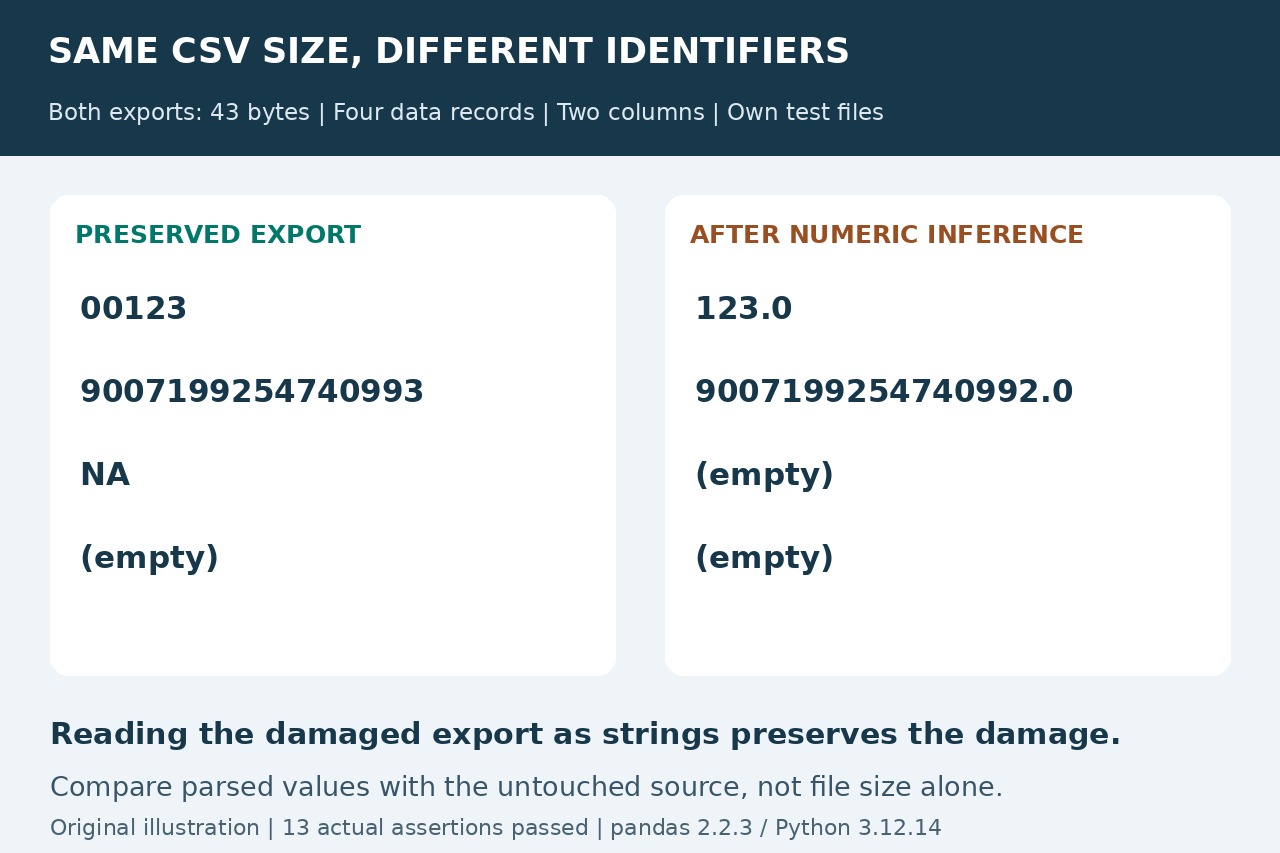
我們的63位元組輸入替所有欄位加了引號。預設數值讀取將編號欄推斷為float64,之後轉string得到123.0和9007199254740992.0。將這組推斷值另存CSV時,變動後的數字寫入檔案,原本的字面NA與空欄位也都寫成空欄位。
再以明確的字串設定讀取這份受損CSV,只會保留已受損的文字;目前讀取器不再是首次丟失點。它與正確保留值的匯出檔恰好同為43位元組,列欄數量也相同。因此在這些樣本中,大小與形狀相同並不證明值相等。
另存後與原始值逐項比較
寫入新目標,以相同已宣告結構重新解析。將有序編號字串及缺失值差異與原始檔比較,核對記錄數,調查編號碰撞或值變動。正確保留的往返測試留下全部四個值;因為引號形式改變,位元組表示由63變成43位元組,所以原始位元組完全相等並非合適的語意驗收標準。
若目前最早的CSV已包含捨入或縮短的編號,應向權威提供方取得新匯出,或回到更早保留的來源。補零或對顯示的浮點數取整,無法確認丟失的原編號。本文測量只涵蓋pandas 2.2.3的C引擎與四列合成資料,套用至其他環境前應複核實際部署版本與解析器。