テクノロジー · 実用ガイド
pandasのCSV識別子が文字列型でも変わる?読み込み前後の値を追跡
4行の対照実験で、数値推論、欠損値規則、CSVに書き込まれた既存の損失を分離。後からの文字列変換では戻せません。
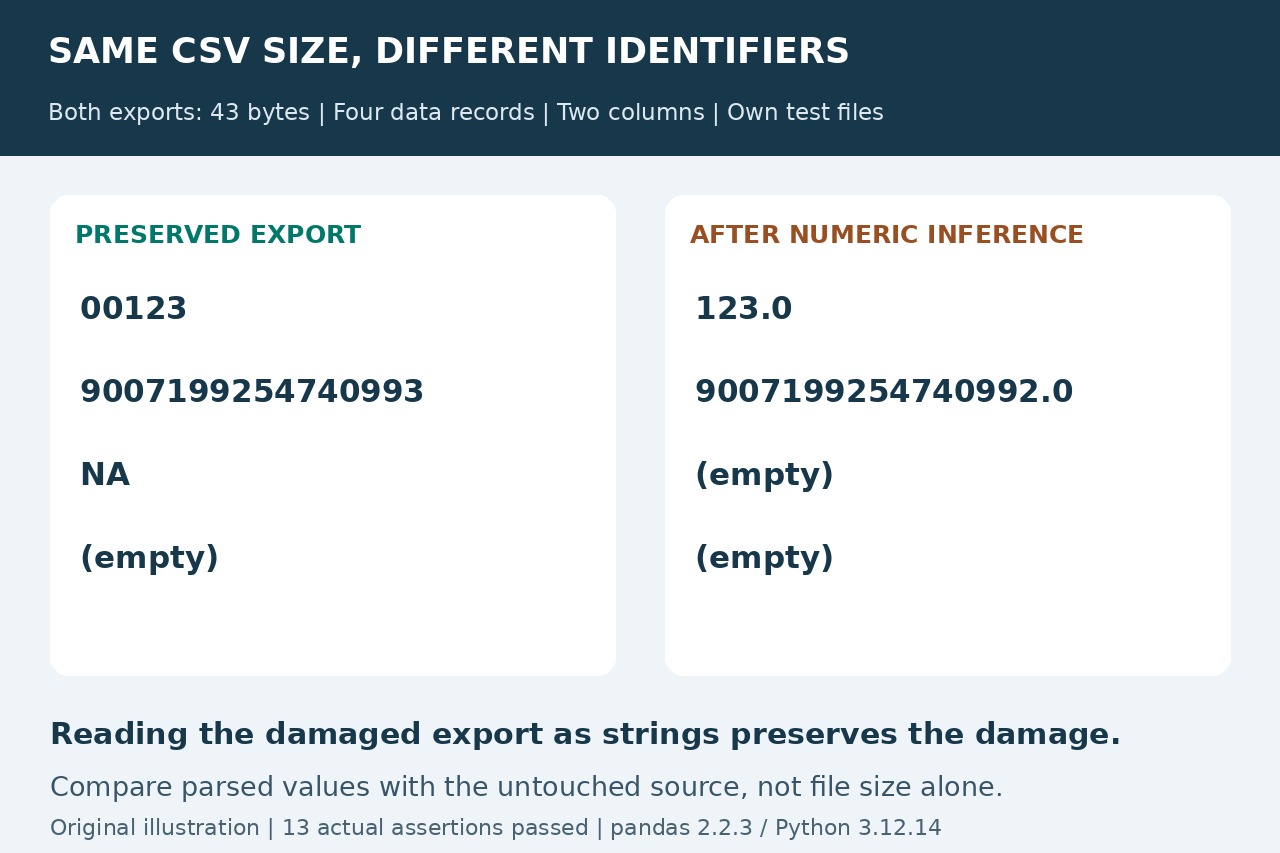
CSVの識別子が変わったら、型変換を追加する前に原本のフィールドと各処理段階の値を比較します。文字列型は欠損値認識を自動では無効にせず、すでに壊れた書き出しを文字列で読んでも、以前の数値変換で失った桁は復元できません。
Python 3.12.14、pandas 2.2.3、Cパーサーで、00123、9007199254740993、文字列NA、空フィールドという4つの識別子を試し、13項目の確認が通りました。NAを文字列と定義した小さな対照例であり、実際の欠損値規則は別途決める必要があります。
原本のフィールドと既知のスキーマから始める
原本のCSVを保存し、エンコーディング、区切り、引用符、ヘッダー、識別子列を記録します。実際の方言で作業用コピーを解析してください。Pythonのcsv.readerは通常、数値に自動変換せず文字列を返します。文字列の基準を作るときはQUOTE_NONNUMERICを使わず、辞書に対応付ける前にヘッダー位置を確認します。
整形表示だけでなく正確なサンプル値を記録します。CSVの引用符はフィールドの区切りであり、pandasへの型宣言ではありません。関連するExcelガイドは同じ原本との境界を、ヘッダーガイドは重複ラベルを扱います。ファイルのハッシュはバイトの同一性を記録しますが、それだけで業務上の正しい値は確定しません。
文字列型と欠損値の規則を別々に設定する
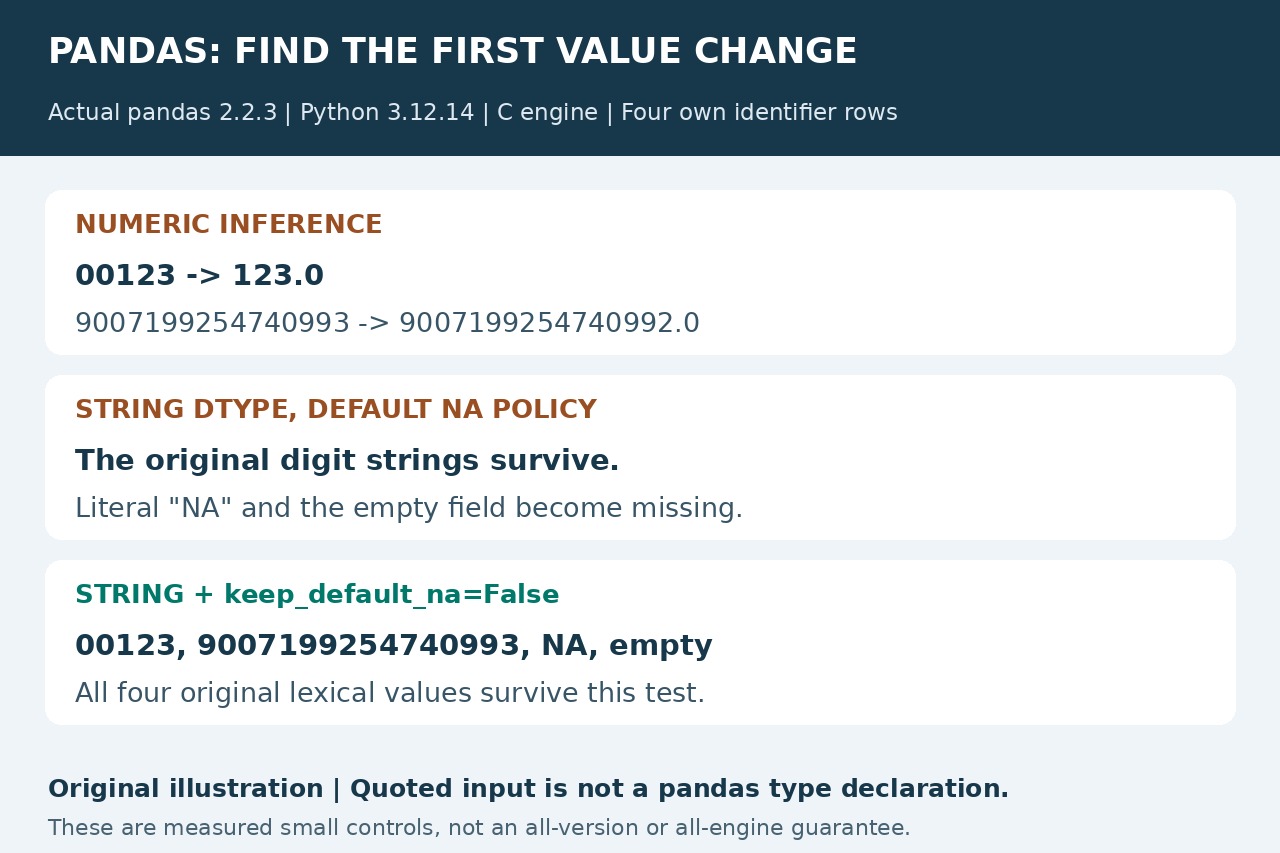
import pandas as pdの後、試した読み込みはpd.read_csv('input.csv', engine='c', dtype={'id': 'string'}, keep_default_na=False)です。既知のUTF-8入力では00123、大きな識別子の全桁、文字列NA、空文字を保持しました。stringだけでは桁は保持しても、後の2つが欠損になりました。
keep_default_na=Falseはid列だけでなく読み込み全体の欠損トークン認識に影響します。ここでは原文確認のための設定で、全列の空欄が有効という宣言ではありません。作成元のスキーマに基づいて列ごとの欠損トークンと型を定義し、検証します。エラーを消すためだけに欠損をゼロや文字列'nan'へ置換しないでください。
現在の読み込みより前の損失を探す
63バイトの入力は全フィールドを引用符で囲みました。既定の読み込みでは識別子がfloat64となり、後からstringにすると123.0と9007199254740992.0になりました。その値を書き出すと変更後の桁が新しいCSVに残り、文字列NAと元の空欄はともに空フィールドになりました。
そのCSVを明示的な文字列設定で再読込しても、失われた情報は戻りません。現在の読み込みが最初の損失箇所ではないためです。損失後と正常な出力は、偶然どちらも43バイトで行列数も同じでした。この対照例ではサイズと形の一致は値の一致を意味しません。
別ファイルの往復を原本の値と比較する
新しい保存先へ書き出し、同じ宣言済みスキーマで再解析します。識別子の順序付き文字列と欠損の区別を原本と比較し、レコード数、衝突、値の変化を確認します。正常な往復では4値すべてを保持しましたが、引用符の表現が変わって63から43バイトになりました。生バイトの完全一致は適切な意味上の完了条件ではありません。
最も古い手元のCSVにすでに丸めや短縮があれば、信頼できる作成元の再出力か以前の保存原本へ戻ります。ゼロ埋めや表示された浮動小数点数の丸め直しでは元の識別子は特定できません。測定はpandas 2.2.3のCエンジンと4行の合成データに限定され、別環境では実際のバージョンとパーサーを再確認してください。