科技 · 實用指南
pandas設定skip仍留下壞CSV紀錄?先驗證紀錄再用usecols
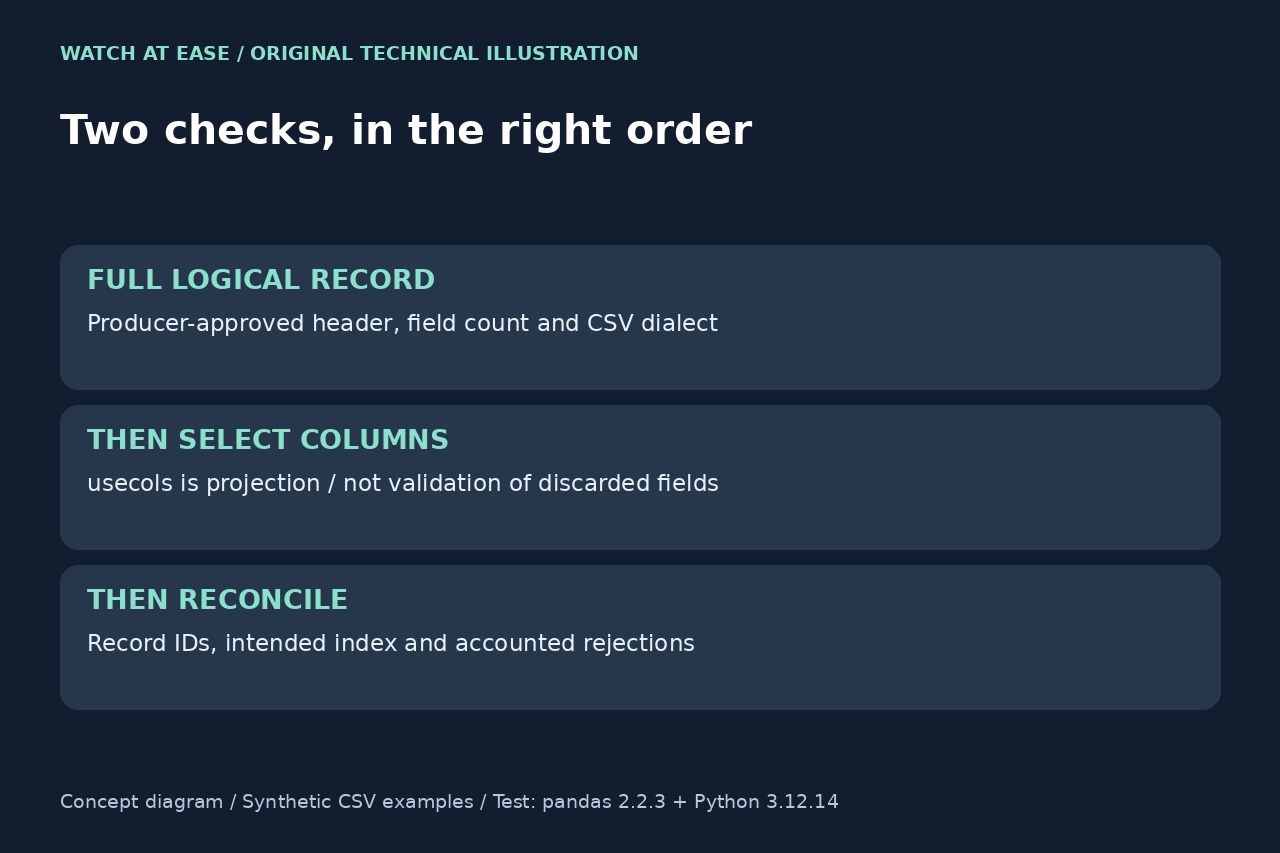
on_bad_lines是解析策略,並非完整結構驗證。先在選欄前核對邏輯欄位,再於讀取後核對紀錄去向。
CSV讀取不報錯,仍可能留下欄位不足的紀錄、遭捨棄的額外欄位或非預期索引。現行read_csv文件把on_bad_lines處理的壞行定義為欄位過多的行,並未保證所有不符業務規則的紀錄都會消失。
區分略過與驗證
先確認匯出方的分隔符號、引號規則、編碼及預期結構。記錄pandas版本、解析引擎、header、names、index_col、usecols、空行與註解處理及壞行策略。副檔名是.csv,不能證明這些選擇正確。
現行API說明warn也會略過該行,skip則不發出對應警告。兩者都不是無損修復開關。保留原檔,只有能交代被排除紀錄去向時,才執行明確的拒收規則。
選欄之前稽核邏輯紀錄
依確認的編碼及格式,以newline=''開啟工作副本,用csv.reader(..., strict=True)逐筆讀取。先將表頭與核准欄名比較,再檢查每筆邏輯資料紀錄的len(row)是否等於規定寬度。分開保存不符紀錄與來源位置,不可直接計算原始文字的逗號。
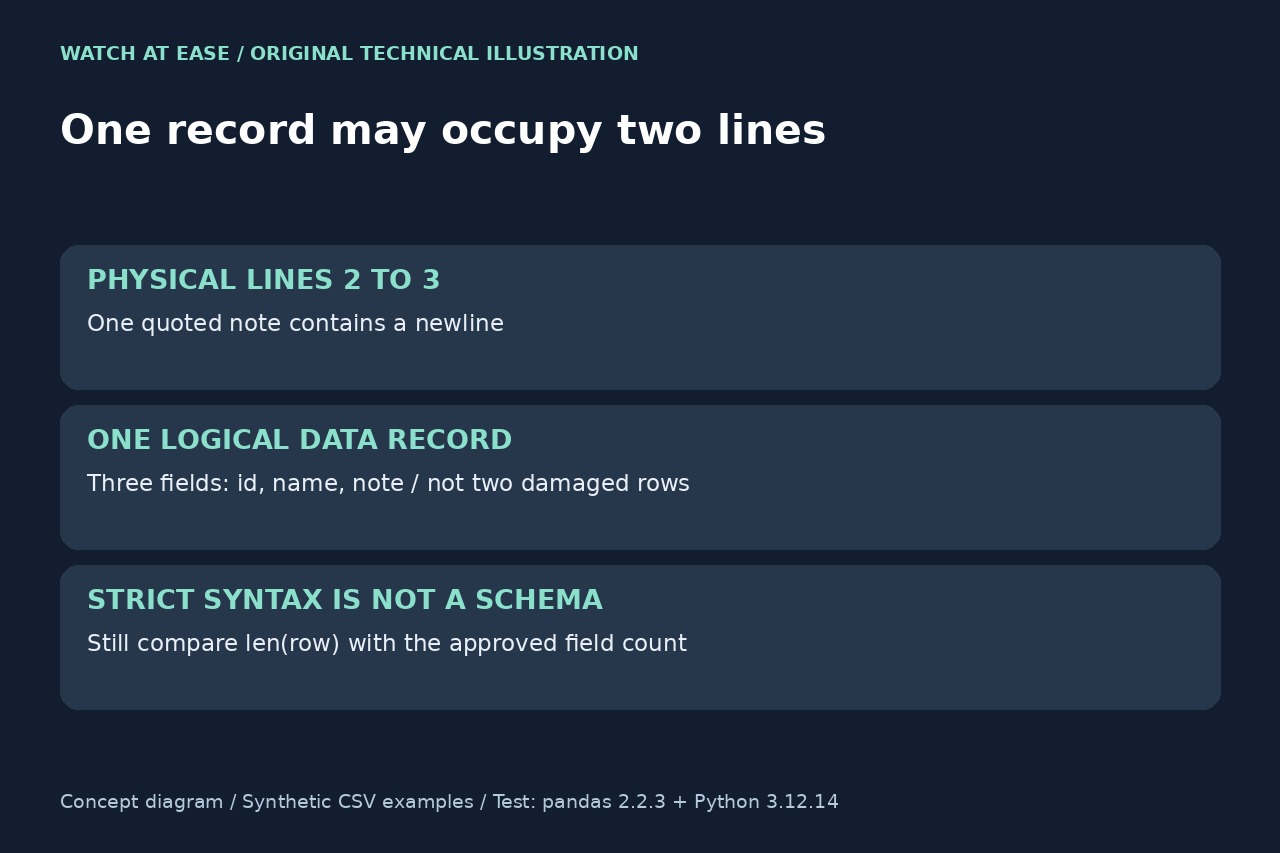
strict=True檢查CSV語法,並不檢查業務結構。記錄每筆前後的reader.line_num以定位實體行範圍;引號內換行可使一筆跨多行。比較數量前先統一空行及註解規則;解析失敗應停止,不可猜測紀錄邊界。
四組受控範例說明陷阱
我們以pandas 2.2.3、Python 3.12.14測試合成三欄CSV。後續出現四欄紀錄時,預設報ParserError,skip將其刪除;加入usecols後卻保留紀錄並捨棄額外欄位。兩欄紀錄則留下缺失值。這僅是所裝環境的結果,並非現行pandas 3.0.6的執行測試。
首筆資料有四欄時,預設讀取推斷索引並移位;index_col=False返回三欄,卻發出資料遺失警告,並未修好紀錄。另一份引號內多行欄位範例中,一筆有效三欄紀錄跨兩個實體行。沒有一個開關能認證全部四種情況。
只做可核對的修復
若格式或表頭選錯,在副本上修正讀取設定。紀錄確實損壞時,應取得正確匯出,或依明確規則隔離。不要盲刪最後一欄:意外分隔符號可能在中間拆開有意義的值。
讀取後檢查目標欄位順序、索引、必要識別碼、重複項與業務限制。依相同篩選規則,將接受與拒收的邏輯紀錄對回來源稽核。欄數一致只是結構證據,不能證明值的意義正確,也不能證明選欄後的DataFrame保留所有來源資訊。