科技 · 實用指南
Linux 顯示「fork: Cannot allocate memory」?重啟前先證明失敗邊界
空閒記憶體不是診斷。先保存 fork 失敗現場,證明 PID namespace 仍存活,再比較 cgroup 記憶體事件與有效上限,最後讀取主機 commit 帳本。
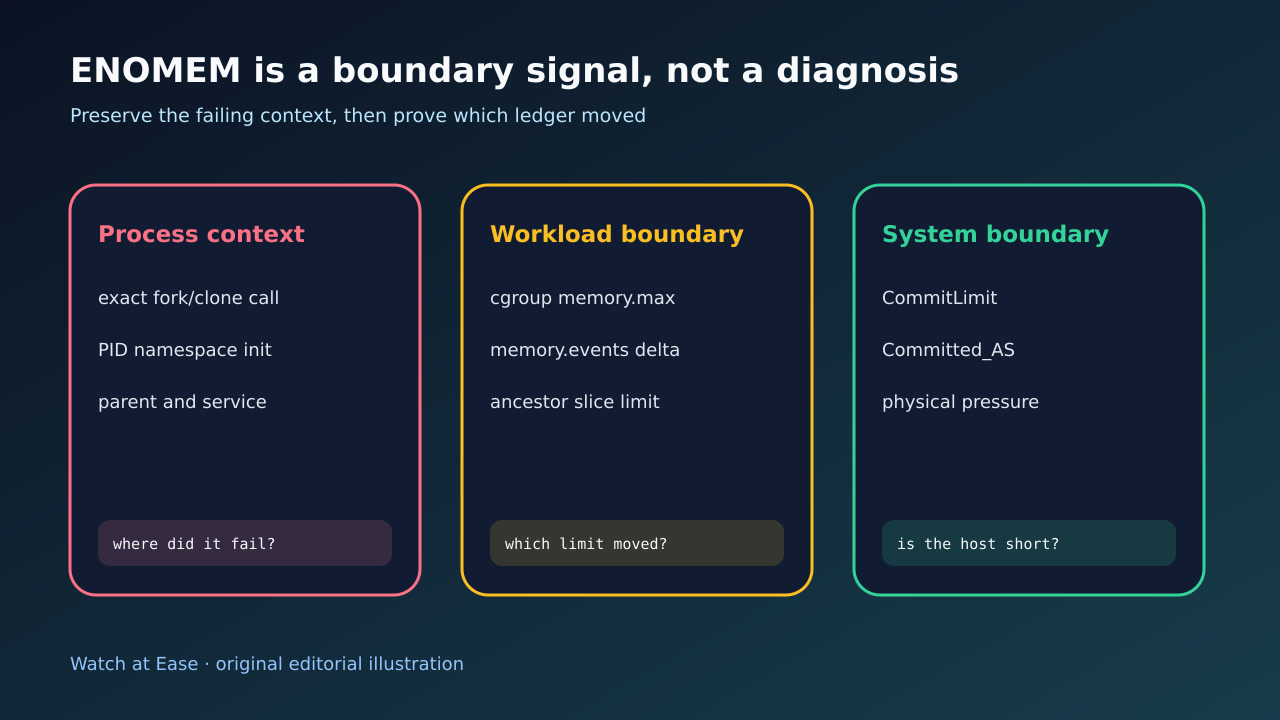
空閒記憶體不是診斷。先保存 fork 失敗現場,證明 PID namespace 仍存活,再比較 cgroup 記憶體事件與有效上限,最後讀取主機 commit 帳本。
fork 回傳 ENOMEM 可能因核心記憶體緊張,也可能因目標 PID namespace 的 init 已終止。 即使主機仍有可用記憶體,cgroup 也可能觸及 memory.max。
1. 保存精確 fork 失敗與執行上下文
重啟前記錄時間、父 PID、服務或容器、精確命令與 syscall errno,並保留第一條 journal 或 trace、cgroup 與 namespace 路徑。shell 訊息本身無法指出拒絕邊界。
不要先 drop_caches、觸發全域 OOM、取消所有限制或重啟。這些動作會清除現場、影響其他工作負載,並使後續成功無法歸因。
2. 證明 PID namespace 仍能建立子程序
fork 手冊記錄一個獨立 ENOMEM 分支:目標 PID namespace 的 init 已終止。比較失敗父程序與正常程序的 namespace 連結,確認該 namespace 仍有活著的 PID 1。
若證實此分支,應修復容器或 namespace 生命週期,讓受監督 init 存活。增加 swap 或提高 MemoryMax 無法復活已死 namespace。
3. 稽核服務 cgroup 與祖先上限
把失敗 PID 對應到 cgroup,在一次受控嘗試前後保存 memory.current、memory.max、memory.high、memory.swap.current 與 memory.events,並檢查父 slice。
若 max 或 oom 增加但主機無整體壓力,就是工作負載本地證據。oom_kill 為零也不能排除不觸發 killer 的配置失敗。
4. 比較主機 commit 與物理壓力證據
共同閱讀 MemAvailable、swap、CommitLimit、Committed_AS、壓力與核心日誌。嚴格 overcommit 下,已承諾位址空間達上限時,即使空閒快照看似充足仍會失敗。
區分 ENOMEM 與工作數限制。RLIMIT_NPROC、threads-max、pid_max 或 pids.max 通常產生 EAGAIN;調整工作上限前先保存真實 errno。
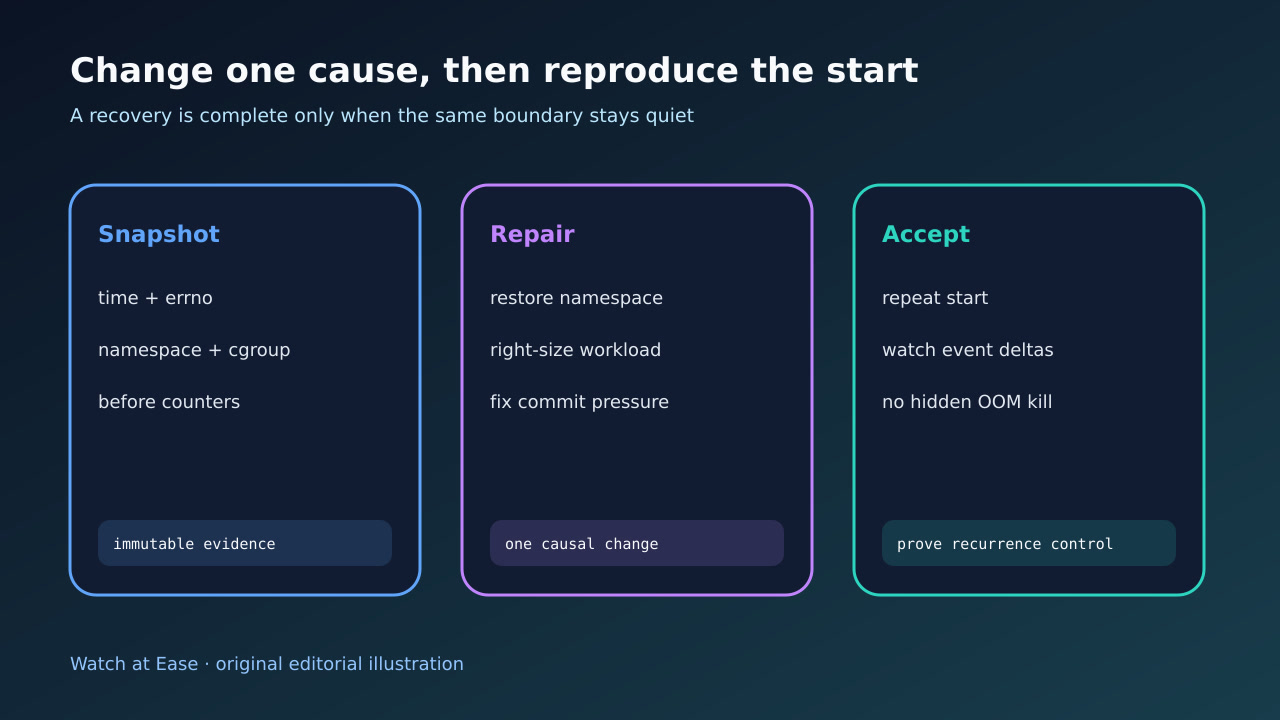
5. 只修一個邊界並重複同一啟動
namespace 死亡就恢復受監督 init;cgroup 邊界就修復洩漏或窄幅調整單元與祖先;主機壓力則處理已證明消耗者或容量。
保持同一 namespace、cgroup 與 commit 帳本,至少重複啟動兩次。要求子程序成功、歸屬正確、事件計數無異常增加、無隱藏 OOM kill,且正常重啟仍通過。