科技 · 實用指南
Linux 顯示「fork: Resource temporarily unavailable」?先證明耗盡的是哪一層工作預算
提高限制、終止程序或重新啟動前,先區分使用者、cgroup、systemd 與核心的 PID 或執行緒上限。
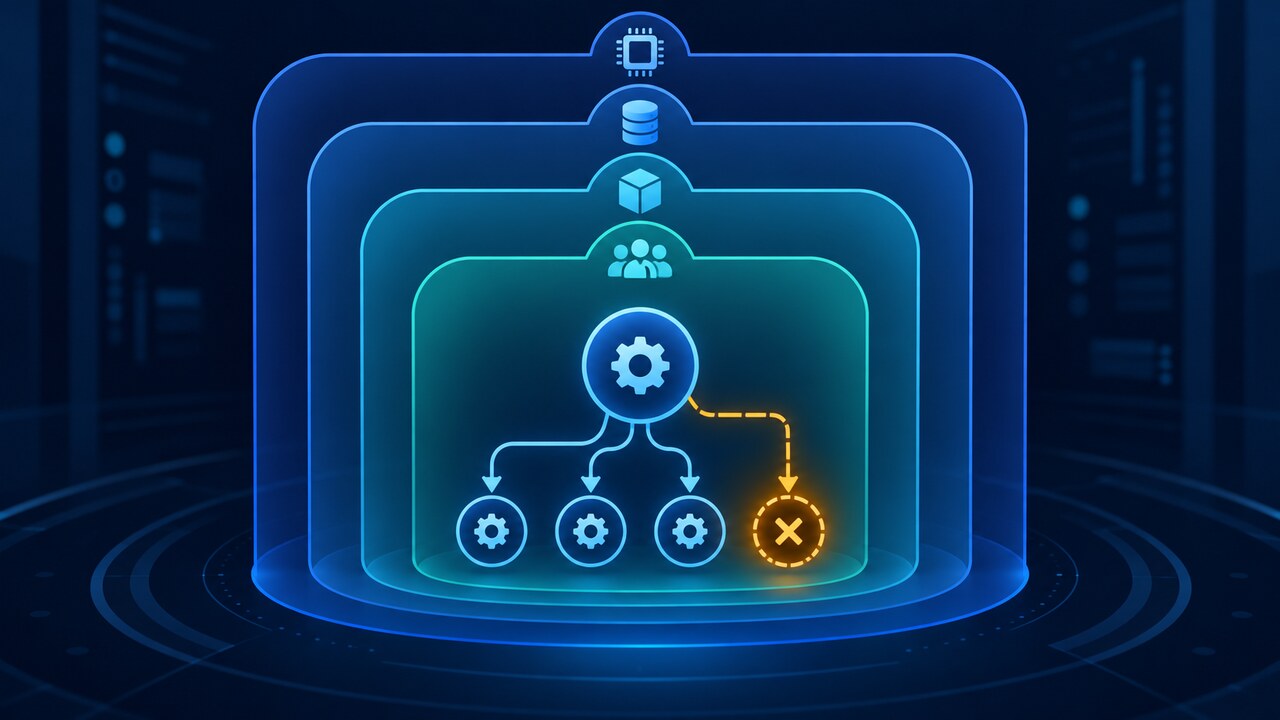
Linux 的 fork 或 clone 即使在記憶體與檔案描述符看似充足時也可能回傳 EAGAIN。這表示工作預算不足,但預算可能屬於使用者、cgroup、systemd 單元或主機。
本稽核先保留證據,再找出生效邊界與程序或執行緒擴張的責任方,最後驗證最小可回復修正。
先凍結故障,再釋放工作
保留一個復原 shell,重新啟動前複製原命令、時間、使用者、服務或容器、stderr 與退出狀態。記錄實際是 EAGAIN 或 ENOMEM;fork(2) 將兩者分開,不能以「像記憶體問題」取代真實 errno。
在相同範圍保存 PID、PPID、使用者、命令與 NLWP 等清單,並記錄近期部署或流量變化。不要先批次 kill,否則會抹掉辨識預算與擴張責任方所需的樹與計數器。
先檢查每使用者預算
fork(2) 把 RLIMIT_NPROC 列為 EAGAIN 原因之一;Linux 上它更精確地限制真實使用者 ID 的工作或執行緒。比較失敗程序的真實 UID、軟硬限制,並統計該 UID 的活動執行緒。
目前 shell 的高 ulimit 不能證明服務擁有相同有效限制。應從失敗程序或服務管理器環境取得限制,區分服務帳戶與排障人員;若接近上限,先找出正在成長的程式與父程序。
定位 cgroup 並讀取 PID 帳本
cgroup v2 的 pids 控制器統計工作 ID,包括各執行緒。定位失敗程序的 cgroup,讀取 pids.current、pids.peak、pids.events 與 pids.max;max 事件增加是 fork 或 clone 越界並回傳 EAGAIN 的證據。
對 systemd 單元比較 TasksCurrent、TasksMax 與 EffectiveTasksMax。TasksMax 映射 pids.max,有效值會反映更緊的父層。讀取真實單元與 cgroup,不要假設容器、使用者 slice 和主機餘量相同。
近端限制有餘量後再查主機上限
若使用者與 cgroup 都有餘量,再檢查 threads-max、pid_max 與主機工作總數。fork(2) 把兩者都列為 EAGAIN 原因;pid_max 很大不能排除 threads-max、使用者或巢狀 cgroup。
將本層與檔案描述符限制分開。提高 nofile 或關閉通訊端不會產生 PID 或執行緒預算。也可記錄未設定 reset-on-fork 的 SCHED_DEADLINE,但不要把特殊案例當預設答案。
找出擴張責任方並分類
依執行緒數與後代數排序程序,檢查領先的父程序、服務和工作量,並與健康基線比較。單一程序 NLWP 快速增加較像執行緒洩漏;大量短命子程序可能是重試風暴、worker 過量或上游並行變更。
判斷負載是正常並行或失控成長。緩解前保存日誌、堆疊樣本和程序樹。重新啟動或 kill 也許恢復容量,但沒有責任方與成長模式只會讓事件復發。
執行最小可回復修正
優先停止洩漏或失控的產生者、降低 worker 或重試並行,或修正已證明過低的服務邊界。只有穩態工作量與安全餘量支持時才提高限制,避免 infinity 與全域變更。
記錄舊值、新值、責任人、原因和回復命令。systemd 變更應寫入受控單元設定並正常 reload;cgroup 或容器邊界應修改來源設定,而非短暫執行期寫入。
重跑原建立路徑並證明餘量
緩解後從相同使用者、單元和容器重跑原命令或受控工作量,確認真的建立子工作。再次檢查使用者執行緒、pids.current 對 pids.max、pids.events 和主機上限。
成功代表原 fork 或 clone 路徑可用、相關事件計數不再增加,且觀察期內使用量低於邊界。保留證據與回復方案;缺少這些檢查的成功重新啟動只是復原,不是診斷。