科技 · 实用指南
Linux 报“fork: Cannot allocate memory”?重启前先证明失败边界
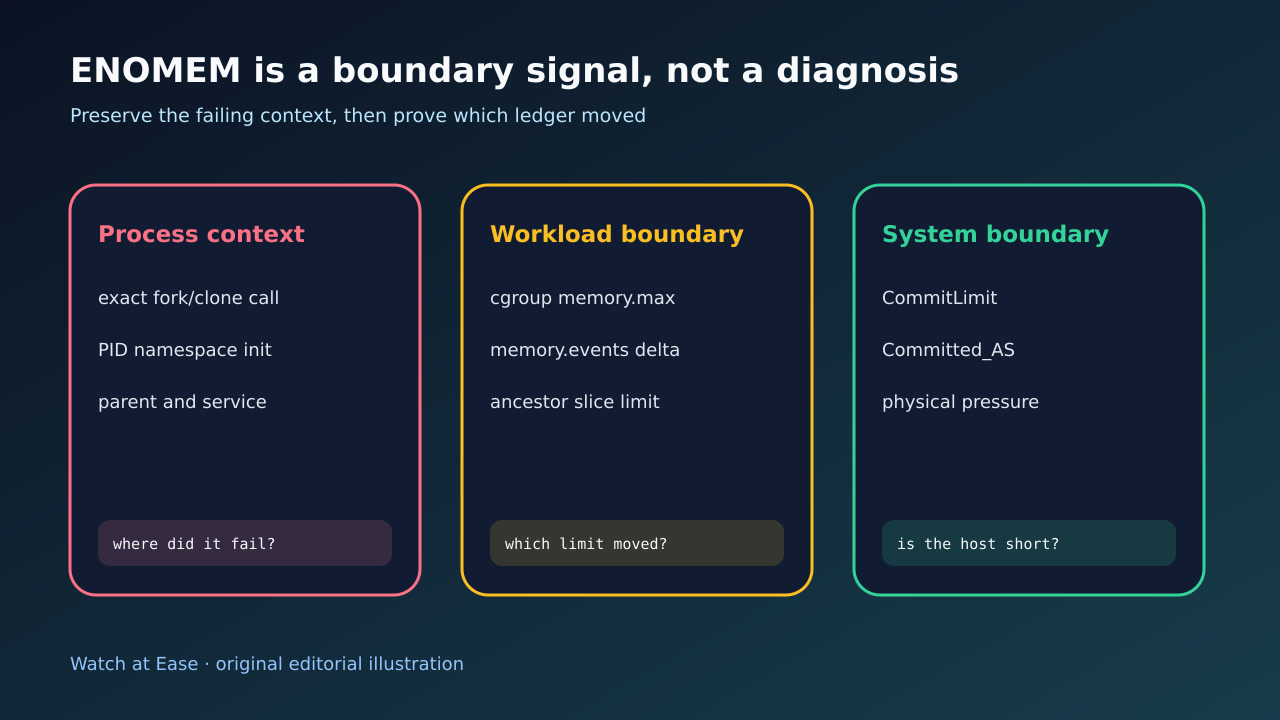
空闲内存不是诊断。先保留 fork 失败现场,证明 PID namespace 仍存活,再比较 cgroup 内存事件与有效上限,最后读取主机 commit 账本,然后才决定是否加 swap 或重启。
空闲内存不是诊断。先保留 fork 失败现场,证明 PID namespace 仍存活,再比较 cgroup 内存事件与有效上限,最后读取主机 commit 账本,然后才决定是否加 swap 或重启。
fork 返回 ENOMEM 可能是内核内存紧张,也可能是目标 PID namespace 的 init 已终止。 即使主机仍有可用内存,cgroup 也可能撞到 memory.max。
1. 冻结精确 fork 失败与执行上下文
重启前记录时间、父 PID、服务或容器身份、精确命令和 syscall errno,并保留第一条 journal 或 trace、cgroup 与 namespace 路径。shell 文案本身不能说明哪个边界拒绝了子进程。
不要先 drop_caches、触发全局 OOM、取消所有限制或重启主机。这些动作会清除现场、影响无关工作负载,也让后续成功无法归因。
2. 证明 PID namespace 仍能创建子进程
fork 手册明确记录一种独立 ENOMEM:目标 PID namespace 的 init 已终止。把失败父进程的 namespace 链接与正常进程比较,并先确认该 namespace 仍有活着的 PID 1。
若证实是此分支,应修复容器或 namespace 生命周期,让受监督 init 持续存活。加 swap、提高 MemoryMax 或随机杀高 RSS 进程都不能复活已死的 namespace。
3. 审计服务 cgroup 与祖先上限
把失败 PID 映射到 cgroup,在一次受控尝试前后保存 memory.current、memory.max、memory.high、memory.swap.current 与 memory.events 或 memory.events.local,并检查父 slice。
若 max 或 oom 增长而主机没有整体压力,就是工作负载本地证据。某些失败不会调用 OOM killer,因此 oom_kill 为零也不能排除 cgroup 边界。
4. 比较主机 commit 与物理压力证据
把 MemAvailable、swap、CommitLimit、Committed_AS、压力与内核日志一起看。严格 overcommit 下,即使空闲内存快照看起来充足,已承诺地址空间到达上限也会拒绝分配。
把内存 ENOMEM 与任务数失败分开。RLIMIT_NPROC、threads-max、pid_max 或 pids.max 通常让 fork 返回 EAGAIN;改任务上限前先记录真实 errno。
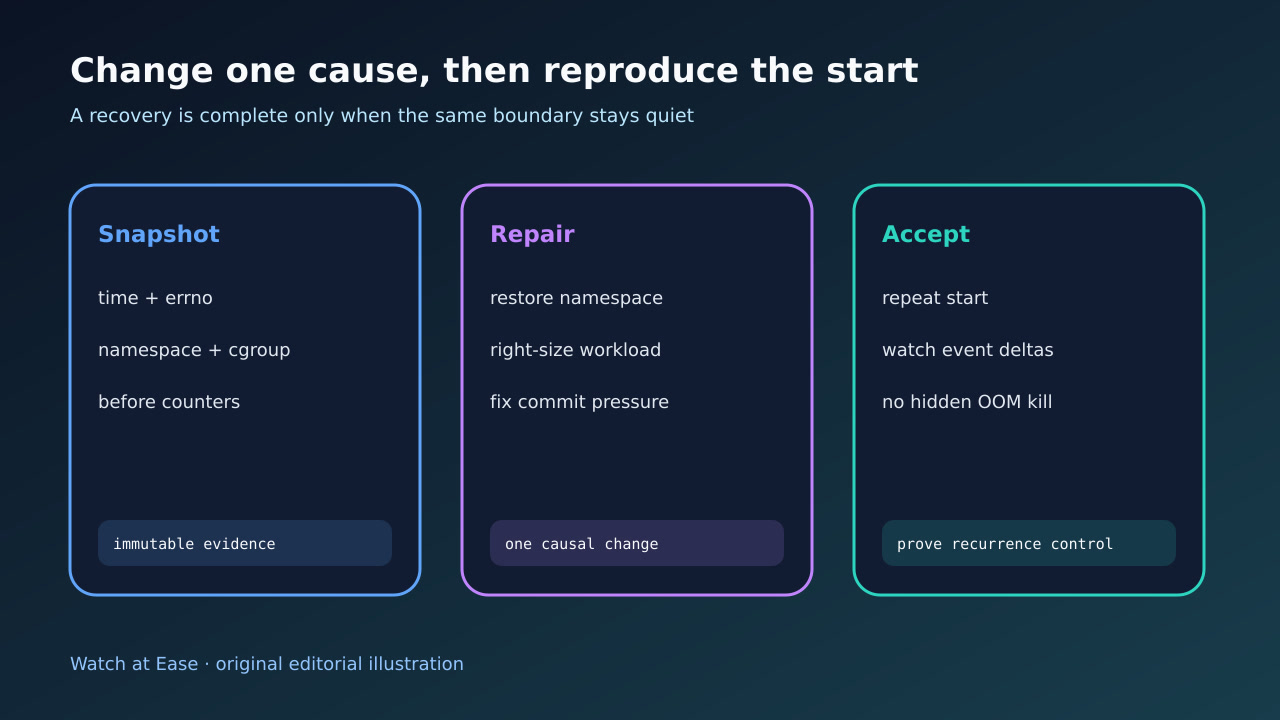
5. 只修一个边界并重复同一启动
namespace 死亡就恢复受监督 init;cgroup 边界就修泄漏或只调整窄单元及祖先策略;主机 commit 或物理压力则处理已证明的消费者或容量。
保持相同 namespace、cgroup 与 commit 账本,至少重复启动两次。只有子进程启动、归属预期 supervisor、事件计数无异常增长、无隐藏 OOM kill 且正常重启仍通过才验收。