科技 · 实用指南
Linux 提示“fork: Resource temporarily unavailable”?先证明耗尽的是哪一层任务预算
在提高限制、杀进程或重启前,区分用户、cgroup、systemd 与内核的 PID 或线程上限。
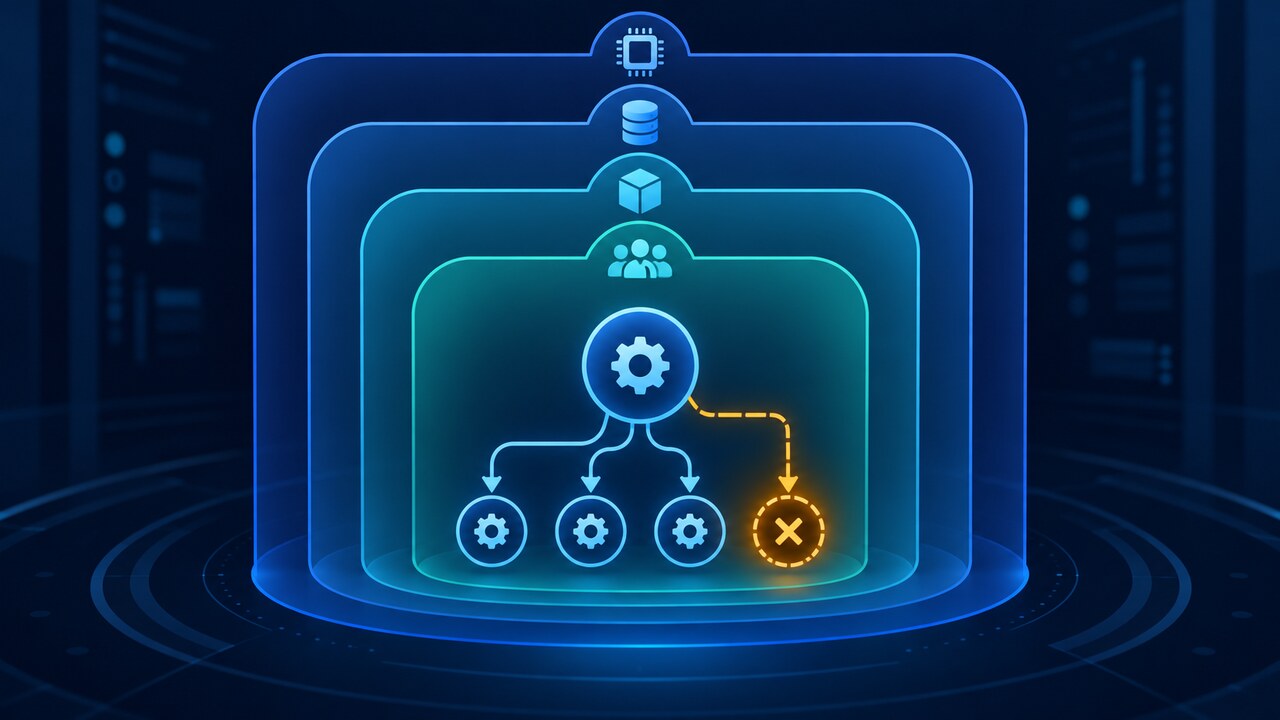
Linux 的 fork 或 clone 即使在内存和文件描述符看似充足时也可能返回 EAGAIN。它表示任务预算不足,但预算可能属于某个用户、cgroup、systemd 单元或整台主机。
本审计先保留证据,再确定生效边界和进程或线程扩张的责任方,最后验证最小可回滚修复,避免把局部故障变成全局提限。
先冻结故障,再释放任务
保留一个恢复 shell,重启前复制原命令、时间、用户、服务或容器、stderr 和退出状态。记录实际是 EAGAIN 还是 ENOMEM;fork(2) 将两者分开,不能用“像内存问题”替代真实 errno。
从同一作用域保存 PID、PPID、用户、命令和 NLWP 等进程线程清单,并记录近期发布或流量变化。不要先执行批量 kill,否则会抹掉识别预算与扩张责任方所需的树和计数器。
先检查每用户预算
fork(2) 把 RLIMIT_NPROC 列为 EAGAIN 原因之一。在 Linux 上它更准确地限制真实用户 ID 的任务或线程。比较失败进程的真实 UID、软硬限制,并统计该 UID 的活动线程,而非只数进程行。
当前 shell 的高 ulimit 不能证明服务拥有相同有效限制。应从失败进程或服务管理器环境采集限制,区分服务账户与排障人员。若计数接近上限,先找出哪个程序和父进程在增长。
定位 cgroup 并读取 PID 账本
cgroup v2 的 pids 控制器统计任务 ID,包括各线程。定位失败进程的 cgroup,读取 pids.current、pids.peak、pids.events 与 pids.max。max 事件持续增加是 fork 或 clone 越界并返回 EAGAIN 的证据。
对 systemd 单元比较 TasksCurrent、TasksMax 与 EffectiveTasksMax。TasksMax 映射到 pids.max,而有效值会反映更紧的父边界。读取真实单元和 cgroup,不能假设容器、用户 slice 与主机余量相同。
较近限制有余量后再查主机上限
如果用户与 cgroup 均有余量,再检查 /proc/sys/kernel/threads-max、pid_max 与主机任务总数。fork(2) 将两者都列为 EAGAIN 原因;pid_max 很大并不能排除 threads-max、用户或嵌套 cgroup。
把本层与文件描述符限制分开。提高 nofile 或关闭套接字不会创造 PID 或线程预算。还可记录调用方是否使用未启用 reset-on-fork 的 SCHED_DEADLINE,但不要把这个特殊情况当默认答案。
找出扩张责任方并分类
按线程数和后代数量排序进程,检查领先的父进程、服务和负载,并与健康基线比较。单个进程 NLWP 快速增长更像线程泄漏;大量短命子进程可能来自重试风暴、worker 过量或上游并发变化。
判断负载是正常并发还是失控增长。缓解前保存日志、栈样本和进程树。重启或 kill 也许恢复容量,但如果没有责任方和增长模式,只会把可诊断的耗尽变成复发事件。
执行最小可回滚修复
优先停止泄漏或失控的生产者,降低 worker 或重试并发,或修正已证明过低的服务边界。只有测得稳态负载和安全余量支持时才提限,避免 infinity,也避免为一个单元的问题改所有用户。
记录旧值、新值、责任人、原因和回滚命令。systemd 变更应写入受控单元配置并按正常流程 reload;cgroup 或容器边界应修改源配置,而非依赖短暂的运行时写入。
重跑原创建路径并证明余量
缓解后,从相同用户、单元和容器重跑原命令或受控负载。确认真的创建了子任务,而不是某个包装层不再显示错误。再次检查用户线程数、pids.current 对 pids.max、pids.events 与主机上限。
成功意味着原 fork 或 clone 路径工作、相关事件计数不再增长,且观察期内任务使用低于边界。把证据与回滚方案留在事件记录中;没有这些检查的成功重启只是恢复,不是诊断。