科技 · 实用指南
将 Zotero 批注导出为 CSV:每条批注独占一行
用已有的 Zotero 批注制作研究表格,将引文、评论、标签、页码标签和来源元数据保存在一起,同时区分文献的出版信息与批注日期。
你已经在 Zotero 中标记了一些段落,希望整理成便于分析的表格:每条批注一行,带上对应的评论、标签,以及足以识别引文出处的信息。把所有批注汇总到一份文档中便于阅读,但这与一张可以逐条筛选、比较记录的表格,是两种不同的结果。
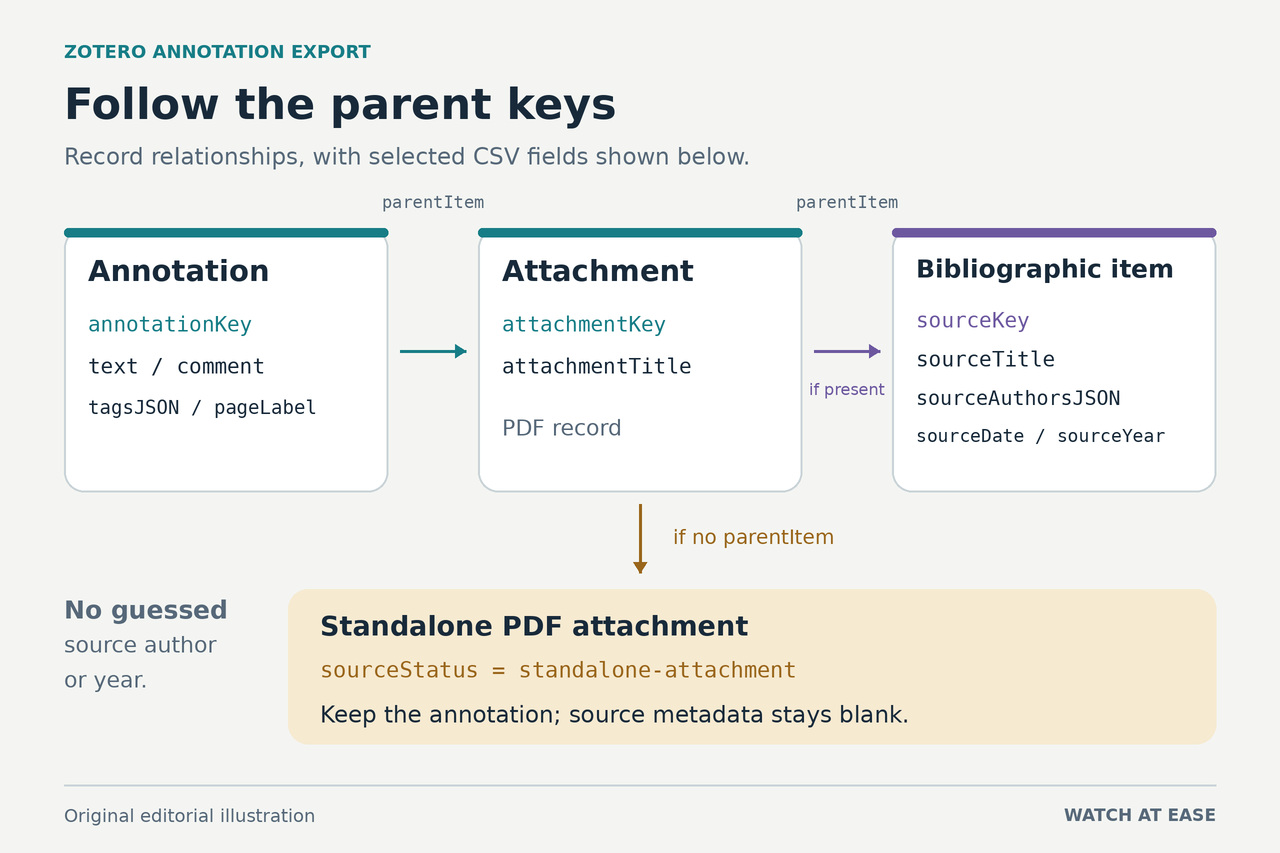
下面的本地导出程序会读取个人文献库 My Library 中已有的原生批注记录,并写入一个新的 CSV 文件。它会沿着每条批注找到所属附件,再找到附件关联的书目父条目(如果存在)。笔记、Pyzotero 和 Highlight Collector 等工具也提供相关功能;本指南给出的是一套完整、明确的导出和检查流程。它不会转换旧版 Extracted Annotations 笔记中的 HTML。
1. 确认这正是你需要的数据
先打开保存了研究资料的 Zotero 桌面应用。此程序读取 Zotero 存储的原生批注条目,包括与 PDF、EPUB 和网页快照关联的批注。它不会扫描附件文件,提取其他 PDF 编辑器创建、但尚未导入为 Zotero 原生批注的标记,也不会将普通笔记或旧版 Extracted Annotations HTML 拆分成记录。
范围是通过本地 users/0 访问的个人文献库 My Library 中,所有符合条件且不在回收站内的批注。在 Zotero 中选中一个文献集或几个 PDF,并不会缩小此次导出的范围。群组文献库的批注不在此程序的处理范围内。请利用输出中的来源和附件字段识别要分析的资料,并先保留一份未经改动的原始 CSV,再另做一份经过筛选的工作副本。
预先选几条批注,留待导出后核对:一条带评论的高亮、一条带标签的批注,以及一条页码标签容易辨认的批注。如果你有独立存放、没有书目父条目的附件,也选一条其中的批注。这些例子能帮助你区分真正缺失的记录与有意留空的字段。
2. 启用本地读取,并暂停文献库变动
在 Zotero 中打开设置(Settings),进入高级(Advanced),启用“Allow other applications on this computer to communicate with Zotero”(允许此计算机上的其他应用与 Zotero 通信)。保持 Zotero 运行。本地 API 允许不带 API 密钥的读取请求;此程序不需要 zotero.org 云端密钥,也不需要获得修改文献库的授权。
在运行 Zotero 的同一台计算机上运行程序。它会向 127.0.0.1 的常用本地端口 23119 发送只读请求。不要转发该端口、将其暴露给外部,也不要换用远程地址。导出程序不会直接读取 SQLite 数据库、打开 PDF、上传引文或向 Zotero 写回更改。
等待当前同步完成,然后在程序运行期间暂停编辑和同步。你可以断开计算机的网络连接,以防再次同步;本地 API 可以离线工作。在程序结束前,不要添加批注、修改来源元数据或重启 Zotero。程序会检查数量、条目键和版本信息,但这些检查并不能让导出成为事务快照:较旧版本的 Zotero 本地 API 返回的是同步版本号,本地编辑后该值可能仍保持不变。
3. 将完整导出程序保存为纯文本文件
在同一台计算机上使用较新的 Node.js LTS 长期支持版本。打开终端并运行 node --version,确认 Node 可用。此导出程序不需要安装 npm 或 pip 软件包。请在支持硬链接的普通本地磁盘上创建工作文件夹,不要假定网络文件系统或特殊虚拟文件系统也能使用。
将下一段中的完整程序复制到纯文本编辑器,并以 UTF-8 编码保存为 export_zotero_annotations.mjs。保留直引号、反斜线和所有标点。确认文件名确实以 .mjs 结尾,而不是 .mjs.txt。代码在此页面上可能显示为一整段长文本;折叠空白后的版本与多行版本均经过了测试。
import {open,link,unlink} from 'node:fs/promises'; import {resolve} from 'node:path'; import {randomUUID} from 'node:crypto'; const fail=c=>{const e=new Error(c);e.code=c;throw e;}; const str=v=>{if(v==null)return '';if(typeof v!=='string')fail('INVALID_FIELD');return v;}; const key=v=>{if(typeof v!=='string'||!/^[A-Z0-9]{8}$/.test(v))fail('INVALID_KEY');return v;}; const item=o=>{if(!o||!o.data||key(o.key)!==key(o.data.key)||!str(o.data.itemType))fail('INVALID_ITEM');return o;}; const array=v=>{if(v==null)return [];if(!Array.isArray(v))fail('INVALID_ARRAY');return v;}; let temporary,handle,serverID,version,total,published=false; try { const port=process.env.ZOTERO_PORT||'23119'; if(!/^\d+$/.test(port)||1>Number(port)||Number(port)>65535)fail('INVALID_PORT'); if(process.argv.length>3)fail('USAGE'); const output=resolve(process.argv[2]||'zotero-annotations.csv'); const base='http://127.0.0.1:'+port+'/api/users/0/items'; async function get(suffix){ let r;try{r=await fetch(base+suffix,{method:'GET',redirect:'error',headers:{'Zotero-API-Version':'3',...(serverID?{'Zotero-Server-ID':serverID}:{})},signal:AbortSignal.timeout(30000)});}catch{fail('LOCAL_REQUEST_FAILED');} if(!r.ok)fail('HTTP_'+r.status); const id=r.headers.get('Zotero-Server-ID'); if(serverID!==undefined&&id!==serverID)fail('SERVER_CHANGED');serverID=id; const api=r.headers.get('Zotero-API-Version');if(api&&api!=='3')fail('API_VERSION'); let data;try{data=await r.json();}catch{fail('INVALID_JSON');} return {data,headers:r.headers}; } async function page(start,limit){ const r=await get('?format=json&itemType=annotation&sort=dateAdded&direction=asc&limit='+limit+'&start='+start); const n=r.headers.get('Total-Results');if(!n||!/^\d+$/.test(n)||!Number.isSafeInteger(Number(n)))fail('INVALID_TOTAL'); if(total!==undefined&&total!==Number(n))fail('TOTAL_CHANGED');total=Number(n); const v=r.headers.get('Last-Modified-Version');if(!v||!/^\d+$/.test(v)||!Number.isSafeInteger(Number(v)))fail('INVALID_VERSION');if(version!==undefined&&version!==v)fail('LIBRARY_CHANGED');version=v; if(!Array.isArray(r.data)||r.data.length!==Math.min(limit,Math.max(0,total-start)))fail('PAGE_COUNT_MISMATCH'); return r.data; } const annotations=[],seen=new Set(),cache=new Map(); do {const batch=await page(annotations.length,100);for(const o of batch){item(o);if(o.data.itemType!=='annotation'||!str(o.data.annotationType))fail('INVALID_ANNOTATION');if(seen.has(o.key))fail('DUPLICATE_KEY');seen.add(o.key);annotations.push(o);}} while(total>annotations.length); if(seen.size!==total)fail('COUNT_MISMATCH'); async function parent(k){key(k);if(!cache.has(k)){const o=item((await get('/'+k+'?format=json')).data);if(o.key!==k)fail('PARENT_KEY_MISMATCH');cache.set(k,o);}return cache.get(k);} const headers=['annotationKey','type','text','comment','tagsJSON','pageLabel','attachmentKey','attachmentTitle','sourceKey','sourceTitle','sourceCreatorsJSON','sourceAuthorsJSON','sourceDate','sourceParsedDate','sourceYear','sourceStatus','annotationAuthorName','annotationDateAdded','annotationDateModified']; const rows=[headers];let standalone=0,nontext=0; for(const o of annotations){ const a=o.data,p=await parent(a.parentItem),d=p.data;if(d.itemType!=='attachment')fail('PARENT_NOT_ATTACHMENT'); let source=null;if(d.parentItem)source=await parent(d.parentItem); if(source&&['attachment','annotation','note'].includes(source.data.itemType))fail('SOURCE_NOT_BIBLIOGRAPHIC'); const s=source?.data||{},parsed=str(source?.meta?.parsedDate),year=/^(?!0000)\d{4}(?:-\d{2}(?:-\d{2})?)?$/.test(parsed)?parsed.slice(0,4):''; const tags=array(a.tags),creators=array(s.creators);if(tags.some(t=>!t||typeof t.tag!=='string')||creators.some(c=>!c||typeof c.creatorType!=='string'))fail('INVALID_METADATA'); const textType=['highlight','underline'].includes(a.annotationType);if(!textType)nontext++;if(!source)standalone++; rows.push([o.key,a.annotationType,textType?str(a.annotationText):'',str(a.annotationComment),JSON.stringify(tags),str(a.annotationPageLabel),p.key,str(d.title),source?.key||'',str(s.title),source?JSON.stringify(creators):'',source?JSON.stringify(creators.filter(c=>c.creatorType==='author')):'',str(s.date),parsed,year,source?'bibliographic':'standalone-attachment',str(a.annotationAuthorName),str(a.dateAdded),str(a.dateModified)]); } const check=await page(0,1);if(check.length&&item(check[0]).key!==annotations[0].key)fail('LIBRARY_CHANGED'); const csv=rows.map(row=>row.map(v=>'"'+v.replaceAll('"','""')+'"').join(',')).join('\r\n')+'\r\n'; const pending=output+'.partial-'+randomUUID();handle=await open(pending,'wx',0o600);temporary=pending;await handle.writeFile(csv,'utf8');await handle.sync();await handle.close();handle=null;await link(temporary,output);published=true; console.log('Exported '+annotations.length+' annotation records to '+output);console.log('Standalone rows: '+standalone+'; non-text rows: '+nontext+'.'); } catch(e){console.error((published?'CSV published; reporting failed: ':'Export failed; no new completed CSV was published: ')+(e.code||'UNEXPECTED')+'.');process.exitCode=1;} finally {if(handle)await handle.close().catch(()=>{});if(temporary)await unlink(temporary).catch(e=>{if(e.code!=='ENOENT')console.error('Temporary-file cleanup failed: '+temporary);});}
在终端中进入保存该文件的文件夹,运行下面的语法检查命令。检查成功时通常不会输出内容,而是直接返回命令提示符。它检查的是已保存程序的语法,不会验证能否访问 Zotero,也不会验证文献库数据是否完整。
node --check export_zotero_annotations.mjs
4. 导出到一个新的 CSV 文件名
保持 Zotero 打开且不作改动,在同一工作文件夹中运行以下命令。引号中的文件名是要新建的文件,而不是要更新的已有导出文件。
node export_zotero_annotations.mjs "zotero-annotations.csv"
等待终端显示“Exported”,后面会列出批注记录数和输出路径。它还会报告独立附件行数和非文本行数。这些是说明性统计,不是需要加到导出总数上的额外记录。记下报告的记录数,稍后在表格中核对。
程序会分批请求批注记录,验证响应,并读取每条记录所引用的附件和来源。随后,它会在目标文件旁写入一个临时文件,只有写入完成后才创建最终文件名。程序不会替换已有的目标文件。再次运行时,请换一个名称,例如 zotero-annotations-2.csv。文件名中带有 .partial 的残留文件不是已完成的交付文件。
5. 理解批注列与来源列
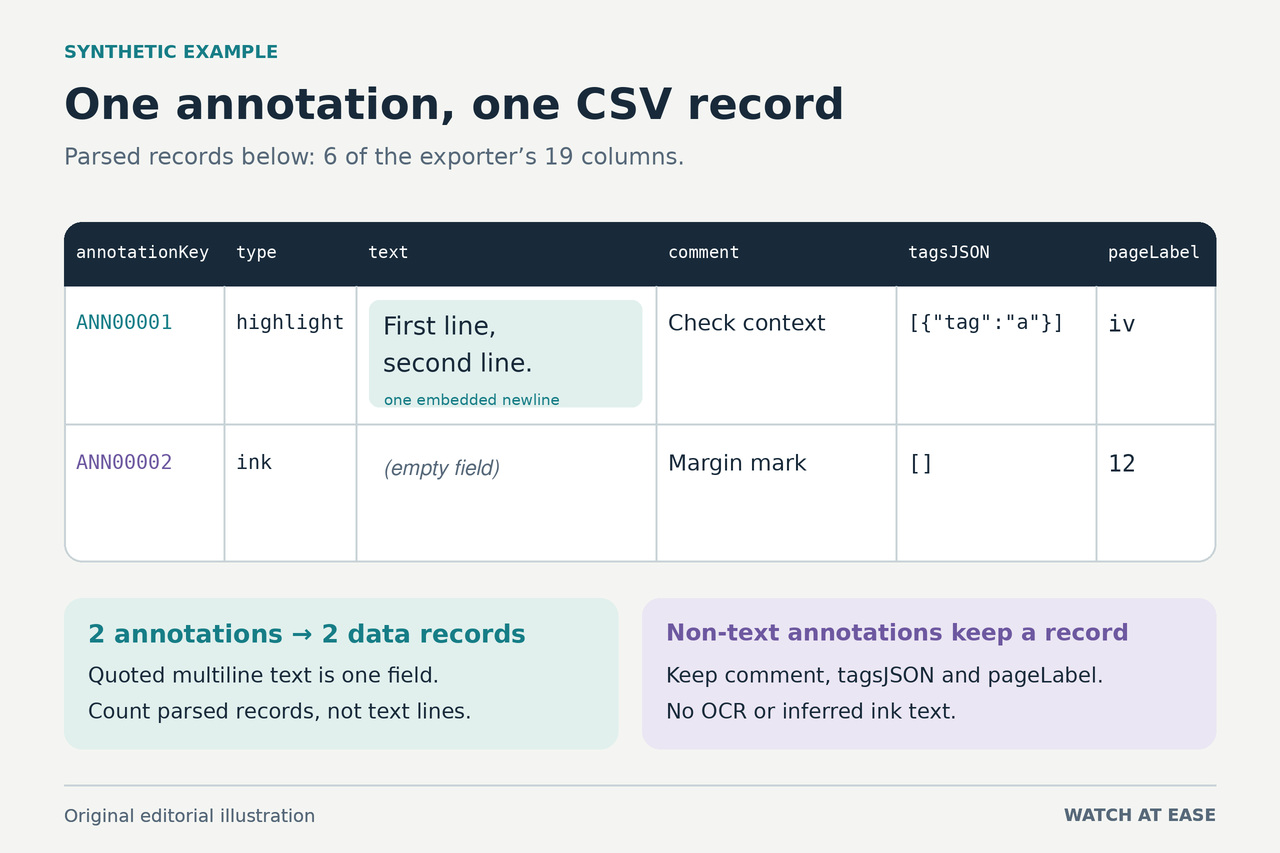
文件共有 19 列。annotationKey 标识批注,type 记录其类型。text 保存高亮和下划线批注的引文,comment 单独保存批注评论。tagsJSON 将批注的标签对象保存为 JSON 文本,保留其结构,不会将其压平成含义可能不明确的逗号分隔标签名。
pageLabel 原样保留 Zotero 中的批注页码标签。不要用附件的实际页面索引替代它,也不要假定标签一定是数字:前置内容或其他文档结构可能采用不同的页码标签。attachmentKey 和 attachmentTitle 标识批注所在的附件。
如果存在书目父条目,sourceKey 和 sourceTitle 会标识它。sourceCreatorsJSON 保留来源文献的结构化创作者列表及其角色;sourceAuthorsJSON 只包含角色为 author 的创作者。程序不会悄悄把编辑者重新标成作者,也不会用批注者的姓名填补空缺的文献作者列表。
sourceDate 保留来源条目的原始日期字符串。Zotero 提供已解析的来源日期时,sourceParsedDate 会保存该值。只有当解析值符合 YYYY、YYYY-MM 或 YYYY-MM-DD 格式,且四位年份不为零时,才会从中提取 sourceYear。这只是一条有限的提取规则,不是日历日期有效性校验;缺失或格式不同的值会保持空白,不会被猜测补全。
存在书目父条目时,sourceStatus 为 bibliographic;不存在时,则为 standalone-attachment。独立附件的记录会保留附件信息,但来源字段留空。最后,annotationAuthorName、annotationDateAdded 和 annotationDateModified 描述的是批注本身。它们都不会被用来替代文献的作者或出版日期。
6. 保留非文本记录,并明确显示缺失的元数据
图像、墨迹、便笺(note)以及高亮或下划线以外的其他类型仍会各占一行,保留已有的评论、标签和标识字段。其 text 列为空。程序不会识别手写内容、将图像区域转成引文,也不会导出图像或墨迹本身。非文本记录数可以提醒你,分析时有多少条记录需要作这种区分。
如果缺少来源作者、出版日期或页码标签,请先在 Zotero 中查看对应记录,再解释该空白的含义。必要时在那里修正来源元数据,等待编辑和同步停止后,再重新导出。不要只为填满表格单元格,就用批注日期替代缺失的出版日期。
成功但返回零条记录的导出文件只有列标题。这表示在当前范围内没有返回符合条件的原生批注记录,并不能证明你的 PDF 从未包含高亮。请重新检查资料是否位于群组文献库、是否只存在于旧笔记中,或是否仍嵌在由外部软件添加批注的文件里。此程序不会转换这些输入。
7. 将 CSV 按文本导入,并核对记录
使用表格软件的文本/CSV 导入流程,不要依赖双击打开。选择 UTF-8 编码、逗号分隔符和双引号文本限定符,并在载入前将所有列设为文本。如果导入对话框提供相关选项,请关闭自动转换或公式解析。如果预览中已经改变了页码标签、日期或引文,请取消导入,再按文本处理方式重新导入。
CSV 会用双引号包住每个字段,将字段内部的双引号写成两个双引号,并使用 CRLF 作为记录分隔符。引文和评论中原有的换行会保留在各自的单元格内。因此,一条记录在文本编辑器中可能占据多个物理行。请将表格解析出的记录数(不含标题行)与终端报告的批注数比较,不要计算原始文件中的文本行数。
将预先选好的例子与 Zotero 对照。确认引文文本、评论、标签、页码标签、附件和书目来源均准确对应。检查多行评论是否仍在同一个单元格中,逗号或引号是否导致多出一列。如果有独立附件记录和非文本记录,也分别检查一条。即使在展示副本中隐藏 JSON 列,也要在原始导出文件中完整保留它们。
将分析结果另存为独立的工作簿或文件。保留原始 CSV 和程序报告的记录数,以便把后续筛选追溯到原始导出。只有记录数和代表性来源关联都与你在 Zotero 中核对的内容一致后,这个文件才适合用于分析或分享。
8. 解决失败原因,不要绕过检查
EEXIST 表示输出文件名已经存在:请另选一个新文件名。遇到 HTTP_403 时,检查 Zotero 的本地通信设置。遇到 LOCAL_REQUEST_FAILED 时,检查 Zotero 是否正在同一台计算机上运行,以及能否通过正常的本地端口访问;超时或被拒绝的重定向也可能产生相同错误码。请修正原因后重新运行,不要把地址改成云端接口。
数量发生变化、条目键重复、文献库版本或服务器身份改变,表示程序无法通过这些检查确认读取结果一致。请停止编辑和同步,确认打开的是目标 Zotero 文献库,再重新运行。父条目缺失、HTTP_404 或父条目类型不符合预期,表示程序无法安全地完成引用记录的关联;导出程序会停止,而不是悄悄丢弃那条批注。
INVALID_TOTAL、INVALID_VERSION、API_VERSION,以及字段无效或数据结构错误,表示响应不符合此程序的预期。请保持文献库完整,并保留诊断错误码以便调查。不要删除验证代码来强行生成一个看似完整的 CSV。遇到文件系统错误时,检查文件夹权限和硬链接支持情况,然后在合适的本地磁盘上使用一个新的目标文件名。
9. 了解程序的测试范围
程序的原写法在 Linux 上使用 Node 24.19.0 和 Python 3.12.14,通过了 28 项合成测试。模拟的本地 API 使用随机选择的回环端口,测试了分两页返回的 101 条记录、恰好 100 条记录、空结果、父条目缺失、响应变化,以及尝试覆盖已有文件等情况。Python 的独立 CSV 读取器检查了输出字段,包括 Unicode、字段内的引号和换行。
针对同一组含 101 条记录的测试数据,原始多行版本与其折叠空白后的形式生成了字节完全相同的 CSV。这些检查没有使用真实的 Zotero 进程、账号、文献库或表格软件界面,也不是 Windows 或 macOS 测试。程序还会在内存中构建整个导出,因此未对大型文献库的处理能力作出承诺。使用 CSV 前,你自己的记录数与来源核对仍是最后一步。 此处展示的代码将两处数值比较的操作数对调,比较含义不变。在额外的 13 个合成测试场景中,使用内存中的 JavaScript 模拟对象运行原写法和展示写法,CSV 字节、消息和操作顺序完全相同。这项对照没有使用 Node,也没有执行真实文件系统或网络操作;未重新运行原来的 28 项 Node/Python 测试。