기술 · 실용 가이드
Zotero 주석을 주석 하나당 한 행으로 CSV 내보내기
기존 Zotero 주석으로 분석용 시트를 만드세요. 인용문, 코멘트, 태그, 페이지 라벨과 출처 메타데이터를 함께 유지하고, 출판 정보와 주석 날짜를 혼동하지 않도록 정리합니다.
Zotero에서 문장에 하이라이트를 표시한 뒤, 분석할 수 있는 스프레드시트가 필요할 때가 있습니다. 주석마다 한 행을 만들고 코멘트, 태그, 인용문의 출처를 식별할 수 있는 정보를 함께 넣는 방식입니다. 주석을 모두 모은 문서는 읽기에는 편리하지만, 레코드를 필터링하고 비교할 수 있는 표와는 결과물이 다릅니다.
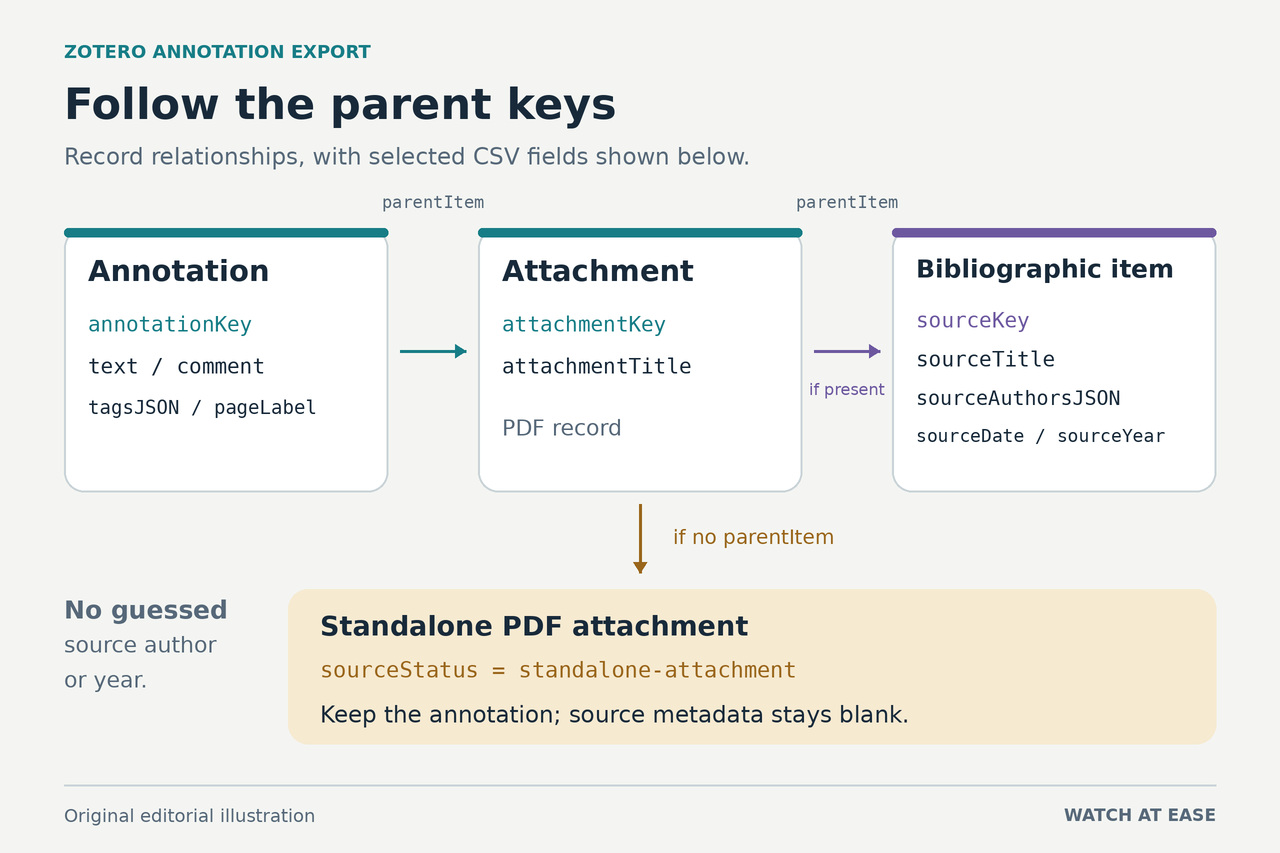
아래 로컬 내보내기 프로그램은 내 라이브러리(My Library)에 이미 저장된 Zotero 자체 주석 레코드를 읽어 새 CSV를 만듭니다. 각 주석의 첨부파일을 찾고, 그 첨부파일에 상위 서지 항목이 있으면 해당 항목도 조회합니다. 노트, Pyzotero, Highlight Collector 같은 도구에도 관련 기능이 있습니다. 이 가이드는 특정 목적에 맞는 내보내기부터 결과 확인까지의 전체 과정을 제공합니다. 예전 Extracted Annotations 노트의 HTML을 변환하는 방법은 아닙니다.
1. 필요한 데이터가 이 내보내기 대상인지 확인하기
연구 자료가 있는 Zotero 데스크톱 앱에서 시작하세요. 이 프로그램은 Zotero가 자체적으로 저장한 주석 항목을 읽습니다. PDF, EPUB, 웹페이지 스냅샷에 연결된 주석이 포함됩니다. 다른 PDF 편집기에서 표시한 내용을 Zotero 자체 주석으로 가져오지 않았다면, 첨부파일을 스캔해서 그 표시를 읽어내지는 않습니다. 일반 노트나 예전 Extracted Annotations HTML을 개별 레코드로 나누는 기능도 없습니다.
대상 범위는 users/0을 통해 로컬에서 접근하는 내 라이브러리의 주석 전체이며, 휴지통 항목은 제외됩니다. Zotero에서 컬렉션이나 PDF 몇 개를 선택해도 내보내기 범위는 줄어들지 않습니다. 그룹 라이브러리의 주석은 이 프로그램의 대상이 아닙니다. 출력된 출처 및 첨부파일 필드로 분석할 자료를 식별하세요. 필터링한 작업용 사본을 만들기 전에, 수정하지 않은 원본 CSV를 보관하세요.
나중에 대조할 주석을 몇 개 골라 두세요. 코멘트가 있는 하이라이트, 태그가 있는 주석, 페이지 라벨을 알아볼 수 있는 주석이 좋습니다. 상위 서지 항목 없이 독립적으로 저장된 첨부파일이 있다면 그것도 포함하세요. 이런 예시를 확인하면 실제로 빠진 레코드와 의도적으로 비어 있는 필드를 구분하는 데 도움이 됩니다.
2. 로컬 읽기를 허용하고 라이브러리 변경 멈추기
Zotero에서 Settings(설정), Advanced(고급)를 차례로 열고 “Allow other applications on this computer to communicate with Zotero”(이 컴퓨터의 다른 애플리케이션이 Zotero와 통신하도록 허용)를 켜세요. Zotero는 실행한 상태로 두세요. Local API는 API 키 없이 읽기 요청을 허용하므로, 이 프로그램에는 zotero.org 클라우드 키나 라이브러리 변경 권한이 필요하지 않습니다.
Zotero와 같은 컴퓨터에서 프로그램을 실행하세요. 프로그램은 127.0.0.1의 기본 로컬 포트인 23119로 읽기 전용 요청을 보냅니다. 이 포트를 포워딩하거나 외부에 공개하거나, 주소를 원격 주소로 바꾸지 마세요. 내보내기 프로그램은 SQLite 데이터베이스를 직접 읽거나 PDF를 열지 않으며, 인용문을 업로드하거나 Zotero에 변경 사항을 기록하지도 않습니다.
진행 중인 동기화가 끝날 때까지 기다린 뒤, 프로그램이 실행되는 동안 편집과 동기화를 멈추세요. 새 동기화를 막기 위해 컴퓨터의 네트워크 연결을 끊어도 됩니다. Local API는 오프라인에서도 작동합니다. 완료될 때까지 주석을 추가하거나 출처 메타데이터를 바꾸거나 Zotero를 다시 시작하지 마세요. 프로그램이 개수, 키, 버전 정보를 확인하더라도 내보내기가 트랜잭션 스냅샷이 되는 것은 아닙니다. 구버전 Zotero의 Local API는 동기화된 버전을 반환하므로, 로컬에서 수정한 뒤에도 그 값이 그대로일 수 있습니다.
3. 전체 프로그램을 일반 텍스트 파일로 저장하기
같은 컴퓨터에 최신 계열의 Node.js LTS 버전을 준비하세요. 터미널을 열고 node --version을 실행해 Node를 사용할 수 있는지 확인하세요. 이 내보내기 프로그램에는 npm이나 pip 패키지를 설치할 필요가 없습니다. 하드 링크를 지원하는 일반 로컬 디스크에 작업 폴더를 만드세요. 네트워크 파일시스템이나 특수한 가상 파일시스템에서도 작동할 것이라고 가정하지 마세요.
다음 문단의 프로그램 전체를 일반 텍스트 편집기에 복사한 뒤, UTF-8 인코딩으로 export_zotero_annotations.mjs라는 이름으로 저장하세요. 직선형 따옴표, 역슬래시, 모든 구두점을 그대로 유지하세요. 실제 파일명이 .mjs.txt가 아니라 .mjs로 끝나는지 확인하세요. 이 페이지에서는 코드가 긴 문단 하나로 보일 수 있습니다. 여러 줄로 된 원본뿐 아니라 공백이 접혀 한 줄로 표시되는 형태도 테스트했습니다.
import {open,link,unlink} from 'node:fs/promises'; import {resolve} from 'node:path'; import {randomUUID} from 'node:crypto'; const fail=c=>{const e=new Error(c);e.code=c;throw e;}; const str=v=>{if(v==null)return '';if(typeof v!=='string')fail('INVALID_FIELD');return v;}; const key=v=>{if(typeof v!=='string'||!/^[A-Z0-9]{8}$/.test(v))fail('INVALID_KEY');return v;}; const item=o=>{if(!o||!o.data||key(o.key)!==key(o.data.key)||!str(o.data.itemType))fail('INVALID_ITEM');return o;}; const array=v=>{if(v==null)return [];if(!Array.isArray(v))fail('INVALID_ARRAY');return v;}; let temporary,handle,serverID,version,total,published=false; try { const port=process.env.ZOTERO_PORT||'23119'; if(!/^\d+$/.test(port)||1>Number(port)||Number(port)>65535)fail('INVALID_PORT'); if(process.argv.length>3)fail('USAGE'); const output=resolve(process.argv[2]||'zotero-annotations.csv'); const base='http://127.0.0.1:'+port+'/api/users/0/items'; async function get(suffix){ let r;try{r=await fetch(base+suffix,{method:'GET',redirect:'error',headers:{'Zotero-API-Version':'3',...(serverID?{'Zotero-Server-ID':serverID}:{})},signal:AbortSignal.timeout(30000)});}catch{fail('LOCAL_REQUEST_FAILED');} if(!r.ok)fail('HTTP_'+r.status); const id=r.headers.get('Zotero-Server-ID'); if(serverID!==undefined&&id!==serverID)fail('SERVER_CHANGED');serverID=id; const api=r.headers.get('Zotero-API-Version');if(api&&api!=='3')fail('API_VERSION'); let data;try{data=await r.json();}catch{fail('INVALID_JSON');} return {data,headers:r.headers}; } async function page(start,limit){ const r=await get('?format=json&itemType=annotation&sort=dateAdded&direction=asc&limit='+limit+'&start='+start); const n=r.headers.get('Total-Results');if(!n||!/^\d+$/.test(n)||!Number.isSafeInteger(Number(n)))fail('INVALID_TOTAL'); if(total!==undefined&&total!==Number(n))fail('TOTAL_CHANGED');total=Number(n); const v=r.headers.get('Last-Modified-Version');if(!v||!/^\d+$/.test(v)||!Number.isSafeInteger(Number(v)))fail('INVALID_VERSION');if(version!==undefined&&version!==v)fail('LIBRARY_CHANGED');version=v; if(!Array.isArray(r.data)||r.data.length!==Math.min(limit,Math.max(0,total-start)))fail('PAGE_COUNT_MISMATCH'); return r.data; } const annotations=[],seen=new Set(),cache=new Map(); do {const batch=await page(annotations.length,100);for(const o of batch){item(o);if(o.data.itemType!=='annotation'||!str(o.data.annotationType))fail('INVALID_ANNOTATION');if(seen.has(o.key))fail('DUPLICATE_KEY');seen.add(o.key);annotations.push(o);}} while(total>annotations.length); if(seen.size!==total)fail('COUNT_MISMATCH'); async function parent(k){key(k);if(!cache.has(k)){const o=item((await get('/'+k+'?format=json')).data);if(o.key!==k)fail('PARENT_KEY_MISMATCH');cache.set(k,o);}return cache.get(k);} const headers=['annotationKey','type','text','comment','tagsJSON','pageLabel','attachmentKey','attachmentTitle','sourceKey','sourceTitle','sourceCreatorsJSON','sourceAuthorsJSON','sourceDate','sourceParsedDate','sourceYear','sourceStatus','annotationAuthorName','annotationDateAdded','annotationDateModified']; const rows=[headers];let standalone=0,nontext=0; for(const o of annotations){ const a=o.data,p=await parent(a.parentItem),d=p.data;if(d.itemType!=='attachment')fail('PARENT_NOT_ATTACHMENT'); let source=null;if(d.parentItem)source=await parent(d.parentItem); if(source&&['attachment','annotation','note'].includes(source.data.itemType))fail('SOURCE_NOT_BIBLIOGRAPHIC'); const s=source?.data||{},parsed=str(source?.meta?.parsedDate),year=/^(?!0000)\d{4}(?:-\d{2}(?:-\d{2})?)?$/.test(parsed)?parsed.slice(0,4):''; const tags=array(a.tags),creators=array(s.creators);if(tags.some(t=>!t||typeof t.tag!=='string')||creators.some(c=>!c||typeof c.creatorType!=='string'))fail('INVALID_METADATA'); const textType=['highlight','underline'].includes(a.annotationType);if(!textType)nontext++;if(!source)standalone++; rows.push([o.key,a.annotationType,textType?str(a.annotationText):'',str(a.annotationComment),JSON.stringify(tags),str(a.annotationPageLabel),p.key,str(d.title),source?.key||'',str(s.title),source?JSON.stringify(creators):'',source?JSON.stringify(creators.filter(c=>c.creatorType==='author')):'',str(s.date),parsed,year,source?'bibliographic':'standalone-attachment',str(a.annotationAuthorName),str(a.dateAdded),str(a.dateModified)]); } const check=await page(0,1);if(check.length&&item(check[0]).key!==annotations[0].key)fail('LIBRARY_CHANGED'); const csv=rows.map(row=>row.map(v=>'"'+v.replaceAll('"','""')+'"').join(',')).join('\r\n')+'\r\n'; const pending=output+'.partial-'+randomUUID();handle=await open(pending,'wx',0o600);temporary=pending;await handle.writeFile(csv,'utf8');await handle.sync();await handle.close();handle=null;await link(temporary,output);published=true; console.log('Exported '+annotations.length+' annotation records to '+output);console.log('Standalone rows: '+standalone+'; non-text rows: '+nontext+'.'); } catch(e){console.error((published?'CSV published; reporting failed: ':'Export failed; no new completed CSV was published: ')+(e.code||'UNEXPECTED')+'.');process.exitCode=1;} finally {if(handle)await handle.close().catch(()=>{});if(temporary)await unlink(temporary).catch(e=>{if(e.code!=='ENOENT')console.error('Temporary-file cleanup failed: '+temporary);});}
파일이 있는 폴더에서 터미널을 열고 아래 구문 검사를 실행하세요. 검사에 성공하면 보통 별도의 출력 없이 명령 프롬프트로 돌아옵니다. 이 검사는 저장한 프로그램의 구문을 확인할 뿐, Zotero에 접근할 수 있는지나 라이브러리 데이터가 완전한지를 확인하지는 않습니다.
node --check export_zotero_annotations.mjs
4. 새 CSV 파일명으로 내보내기
Zotero를 실행해 둔 채 데이터를 변경하지 않는 상태에서, 같은 작업 폴더에서 다음 명령을 실행하세요. 따옴표 안의 파일명은 새로 만들 파일의 이름입니다. 기존 내보내기 파일을 갱신하라는 뜻이 아닙니다.
node export_zotero_annotations.mjs "zotero-annotations.csv"
터미널에 “Exported”와 함께 주석 레코드 수 및 출력 경로가 표시될 때까지 기다리세요. 상위 서지 항목이 없는 독립 첨부파일의 행 수와 비텍스트 행 수도 표시됩니다. 이 수치는 내보낸 레코드를 설명하는 개수이며, 총 레코드 수에 더해야 할 별도 항목이 아닙니다. 스프레드시트를 확인할 때 쓸 수 있도록 표시된 총수를 기록하세요.
프로그램은 주석 레코드를 나누어 요청하고 응답을 검증한 뒤, 참조된 첨부파일과 출처 항목을 각각 조회합니다. 이후 대상 파일과 같은 폴더에 임시 파일을 쓰고, 쓰기가 끝난 다음에만 최종 파일명을 생성합니다. 기존 대상 파일은 바꾸지 않습니다. 다시 실행할 때는 zotero-annotations-2.csv처럼 다른 이름을 사용하세요. 이름에 .partial이 들어간 파일이 남아 있다면 그것은 완성된 전달용 파일이 아닙니다.
5. 주석 열과 출처 열 이해하기
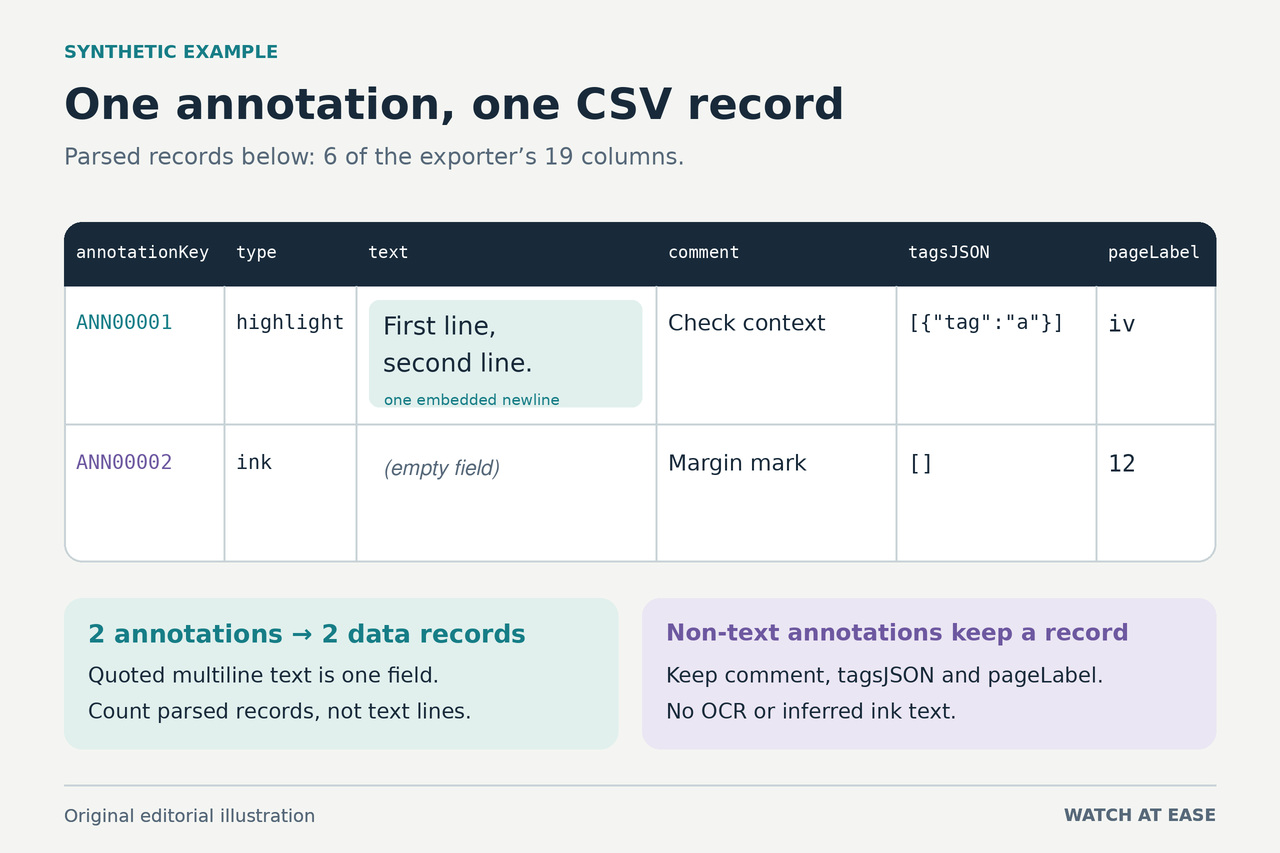
열은 총 19개입니다. annotationKey는 주석을 식별하고, type은 주석 유형을 나타냅니다. text에는 하이라이트와 밑줄 주석의 인용문이 들어가며, comment에는 주석의 코멘트가 별도로 보존됩니다. tagsJSON은 주석의 태그 객체를 JSON 텍스트로 유지합니다. 태그 이름을 쉼표로만 이어 붙여 구분을 모호하게 만드는 대신 원래 구조를 보존하는 방식입니다.
pageLabel은 Zotero의 주석 페이지 라벨을 그대로 보존합니다. 첨부파일의 실제 페이지 인덱스로 대체하거나, 라벨이 반드시 숫자라고 가정하지 마세요. 책의 앞부분이나 다른 문서 구조에서는 별도의 라벨을 사용할 수 있습니다. attachmentKey와 attachmentTitle은 주석이 들어 있는 첨부파일을 식별합니다.
상위 서지 항목이 있으면 sourceKey와 sourceTitle이 그 항목을 식별합니다. sourceCreatorsJSON은 출처 자료의 구조화된 기여자 목록과 각 역할을 유지하고, sourceAuthorsJSON은 역할이 author인 기여자만 포함합니다. 편집자를 임의로 저자로 바꾸지 않으며, 저자 목록이 비어 있다고 해서 주석을 작성한 사람으로 채우지도 않습니다.
sourceDate는 출처 항목의 원래 날짜 문자열을 유지합니다. Zotero가 해석한 출처 날짜를 제공하면 그 값은 sourceParsedDate에 들어갑니다. sourceYear는 해석된 값이 YYYY, YYYY-MM 또는 YYYY-MM-DD 형식과 일치하고 연도가 0000이 아닌 네 자리 수일 때만 가져옵니다. 이는 제한적인 추출 규칙이며 달력상 유효한 날짜인지 검증하는 과정은 아닙니다. 값이 없거나 다른 형식이면 연도를 추측하지 않고 비워 둡니다.
상위 서지 항목이 있으면 sourceStatus는 bibliographic이고, 없으면 standalone-attachment입니다. 독립 첨부파일의 레코드는 첨부파일 정보는 유지하지만 출처 필드는 비워 둡니다. 마지막으로 annotationAuthorName, annotationDateAdded, annotationDateModified는 주석 자체에 관한 정보입니다. 어느 것도 출판물의 저자나 날짜를 대신하는 데 사용하지 않습니다.
6. 비텍스트 레코드와 누락된 메타데이터 구분하기
image, ink, note 등 highlight나 underline이 아닌 유형도 한 행씩 유지되며, 해당 항목에 있는 코멘트, 태그, 식별 필드가 들어갑니다. 이들의 text 열은 비어 있습니다. 프로그램은 손글씨를 인식하거나 이미지 영역을 인용문으로 변환하지 않으며, 이미지나 잉크 데이터 자체도 내보내지 않습니다. 비텍스트 개수는 분석할 때 이런 차이를 고려해야 할 레코드가 몇 개인지 알려 줍니다.
출처 자료의 저자, 출판 날짜 또는 페이지 라벨이 없다면, 빈칸의 의미를 판단하기 전에 Zotero에서 해당 레코드를 살펴보세요. 필요한 경우 Zotero에서 출처 메타데이터를 바로잡고, 편집과 동기화가 멈춘 뒤 새로 내보내세요. 모든 셀을 채우려는 목적으로 누락된 출판 날짜를 주석 날짜로 대체하지 마세요.
0개 레코드를 성공적으로 내보낸 CSV에는 열 머리글만 들어 있습니다. 이는 해당 범위에서 조건에 맞는 Zotero 자체 주석 레코드가 반환되지 않았다는 뜻이지, PDF에 하이라이트가 전혀 없었다는 증거는 아닙니다. 자료가 그룹 라이브러리에 있는지, 예전 노트에만 존재하는지, 외부 프로그램에서 주석을 넣은 파일 안에만 남아 있는지 다시 확인하세요. 이 프로그램은 그런 입력을 변환하지 않습니다.
7. CSV를 텍스트로 가져오고 행 확인하기
파일을 더블클릭해서 여는 데 의존하지 말고, 스프레드시트의 텍스트/CSV 가져오기 기능을 사용하세요. UTF-8 인코딩, 쉼표 구분 기호, 큰따옴표 텍스트 한정자를 선택하고, 불러오기 전에 모든 열을 텍스트(Text)로 설정하세요. 가져오기 대화상자에 자동 변환이나 수식 해석을 끄는 옵션이 있으면 끄세요. 미리보기에서 이미 페이지 라벨, 날짜 또는 인용문이 바뀌었다면 취소한 뒤 텍스트로 처리하도록 설정해 다시 가져오세요.
CSV는 모든 필드를 큰따옴표로 감싸고, 필드 안의 큰따옴표는 두 번 써서 이스케이프하며, 레코드 구분에는 CRLF를 사용합니다. 인용문과 코멘트에 원래 들어 있던 줄바꿈은 해당 셀 안에 남습니다. 따라서 텍스트 편집기에서는 레코드 하나가 여러 줄을 차지할 수 있습니다. 머리글을 제외하고 스프레드시트가 해석한 레코드 수를 터미널에 표시된 주석 수와 비교하세요. 원본 파일의 줄 수를 세면 안 됩니다.
골라 둔 예시를 Zotero와 대조하세요. 인용문 원문, 코멘트, 태그, 페이지 라벨, 첨부파일과 서지 출처가 정확한지 확인하세요. 여러 줄 코멘트가 한 셀에 남아 있고, 쉼표나 따옴표 때문에 열이 추가로 생기지 않았는지도 확인하세요. 독립 첨부파일 레코드와 비텍스트 레코드가 있다면 그것도 검증하세요. 발표용 사본에서 JSON 열을 숨기더라도 보관용 원본에는 그대로 유지하세요.
분석 결과는 별도의 통합 문서나 파일로 저장하세요. 원본 CSV와 기록해 둔 레코드 수를 보관하면, 나중에 필터링한 결과가 원래 내보내기에서 어떻게 나온 것인지 추적할 수 있습니다. 레코드 수와 대표적인 출처 연결이 Zotero에서 확인한 내용과 일치하면 분석이나 공유에 사용할 준비가 된 것입니다.
8. 검사를 우회하지 않고 오류 해결하기
EEXIST는 출력 파일명이 이미 존재한다는 뜻이므로 다른 새 파일명을 선택하세요. HTTP_403이면 Zotero의 로컬 통신 허용 설정을 확인하세요. LOCAL_REQUEST_FAILED이면 같은 컴퓨터에서 Zotero가 실행 중이고 기본 로컬 포트로 접근 가능한지 확인하세요. 시간 초과나 거부된 리디렉션도 같은 코드를 낼 수 있습니다. 주소를 클라우드 엔드포인트로 바꾸지 말고, 원인을 바로잡은 뒤 다시 실행하세요.
개수 변경, 키 중복, 라이브러리 버전 변경 또는 서버 식별 정보 변경은 프로그램이 자체 검사로 일관된 읽기를 확인하지 못했다는 뜻입니다. 편집과 동기화를 멈추고 원하는 Zotero 라이브러리가 열려 있는지 확인한 뒤 새로 실행하세요. 상위 항목 누락, HTTP_404 또는 예상과 다른 상위 항목 유형은 참조된 레코드를 안전하게 연결할 수 없다는 뜻입니다. 이 경우 프로그램은 해당 주석을 조용히 누락시키는 대신 중단합니다.
INVALID_TOTAL, INVALID_VERSION, API_VERSION, 잘못된 필드나 스키마 오류는 응답이 이 프로그램의 예상 조건을 충족하지 못한다는 뜻입니다. 라이브러리는 그대로 보존하고 원인 확인에 쓸 진단 코드를 기록하세요. 완전해 보이는 CSV를 억지로 만들기 위해 검증 코드를 삭제하지 마세요. 파일시스템 오류라면 폴더 권한과 하드 링크 지원 여부를 확인한 뒤, 적절한 로컬 디스크에서 새 대상 파일명을 사용하세요.
9. 제공된 프로그램의 실제 테스트 범위 알아두기
프로그램의 원래 형태는 Linux에서 Node 24.19.0과 Python 3.12.14를 사용한 합성 데이터 테스트 28개를 통과했습니다. 무작위로 선택한 루프백 포트의 모의 Local API로, 두 페이지에 걸친 101개 레코드, 정확히 100개인 경우, 빈 결과, 상위 항목 누락, 응답 변경, 기존 파일 덮어쓰기 시도를 검증했습니다. 별도로 Python CSV 읽기 기능을 사용해 유니코드, 필드 내부 따옴표와 줄바꿈을 포함한 출력 필드를 확인했습니다.
원래 여러 줄 코드와 그 공백을 접은 코드는 동일한 101개 레코드 테스트 데이터에서 바이트 단위로 같은 CSV를 만들었습니다. 이 검증에는 실제 Zotero 프로세스, 계정, 라이브러리 또는 스프레드시트 GUI를 사용하지 않았으며, Windows나 macOS에서 테스트한 것도 아닙니다. 프로그램은 내보낼 데이터를 메모리 안에서 구성하며, 대규모 라이브러리의 처리 용량에 관해서는 검증 결과를 제시하지 않습니다. CSV를 사용하기 전에는 자신의 레코드 수와 출처를 확인하는 마지막 단계가 여전히 필요합니다. 게시된 코드는 두 숫자 비교식의 양쪽 피연산자를 바꾸되 비교의 의미는 유지합니다. 메모리 내 JavaScript 모의 구현을 사용한 추가 합성 사례 13개에서 원래 코드와 게시된 코드의 CSV 바이트, 메시지, 작업 순서가 모두 일치했습니다. 이 비교는 Node나 실제 파일 시스템·네트워크 작업을 사용하지 않았으며, 기존 Node/Python 테스트 28개를 다시 실행한 것은 아닙니다.