テクノロジー · 実用ガイド
Zoteroの注釈を1件につき1行のCSVに書き出す
Zoteroに保存済みの注釈から、分析用の表を作成します。引用文、コメント、タグ、ページラベル、出典の書誌情報をひとまとめにし、出版情報と注釈の日付を区別して保持します。
Zoteroで文章にハイライトを付け、その内容を表計算ソフトで分析したいとします。必要なのは、注釈1件を1行にまとめ、コメント、タグ、引用元を特定できる出典情報を添えた表です。すべての注釈をまとめた文書は読むには便利ですが、レコードを絞り込んだり比較したりできる表とは異なります。
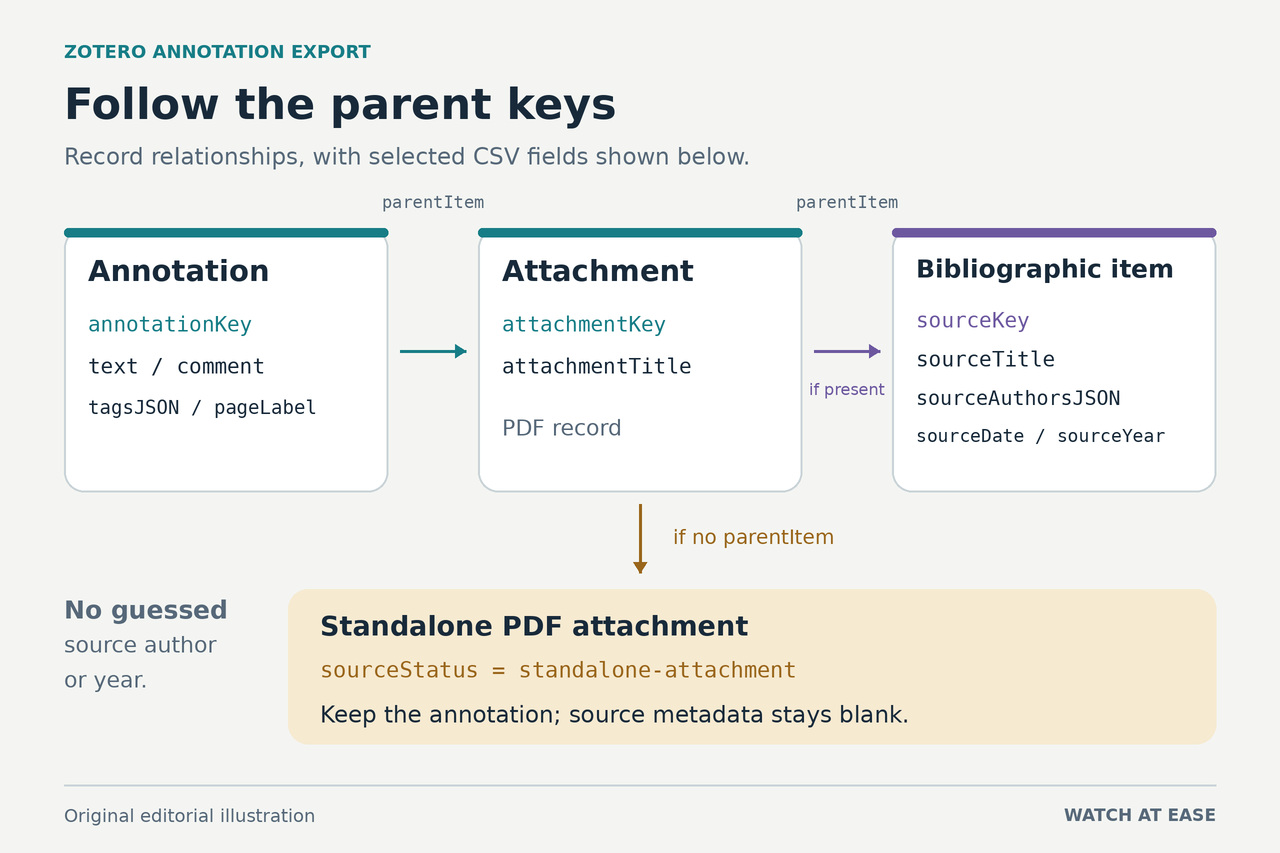
以下のローカル実行用エクスポーターは、My Libraryに保存されているZotero標準の注釈レコードを読み取り、新しいCSVを作成します。各注釈から添付ファイルをたどり、その添付ファイルに書誌情報を持つ親アイテムがあれば、さらにその情報を取得します。ノート、Pyzotero、Highlight Collectorなどにも関連機能はあります。このガイドでは、対象を明確にした書き出しから確認までの手順を示します。旧形式のExtracted AnnotationsノートのHTMLは変換しません。
1. 必要なデータが対象に含まれるか確認する
研究資料を保存しているZoteroのデスクトップアプリで確認を始めます。このプログラムは、PDF、EPUB、ウェブページのスナップショットに付いたものを含め、Zoteroが保存している標準の注釈アイテムを読み取ります。別のPDF編集ソフトで付けたマークがZotero標準の注釈として取り込まれていない場合、添付ファイルを走査してそれらを探すことはしません。また、通常のノートや旧形式のExtracted AnnotationsのHTMLをレコードに分割することもありません。
対象は、users/0を通じてローカルで取得する、My Library内の条件に合うすべての注釈です。ゴミ箱内のものは除きます。Zoteroでコレクションや複数のPDFを選択しても、書き出し範囲は絞られません。グループライブラリの注釈は対象外です。出力された出典と添付ファイルのフィールドを使って分析したい資料を特定し、絞り込み用の作業コピーを作る前に、元のCSVを変更せず保存してください。
後で照合する注釈をいくつか選びます。コメント付きのハイライト、タグ付きの注釈、見覚えのあるページラベルが付いた注釈などです。書誌情報を持つ親アイテムのない独立した添付ファイルがあれば、それも含めます。こうした例を確認すれば、本当にレコードが欠けているのか、仕様どおりフィールドが空欄なのかを区別できます。
2. ローカルでの読み取りを有効にし、ライブラリを変更しない
ZoteroでSettings、Advancedの順に開き、「Allow other applications on this computer to communicate with Zotero」を有効にします。Zoteroは起動したままにしてください。Local APIの読み取りリクエストにはAPIキーが不要です。このプログラムにはzotero.orgのクラウド用キーも、ライブラリを変更するための権限も必要ありません。
プログラムはZoteroと同じコンピューターで実行します。標準のローカルポート23119を使い、127.0.0.1に読み取り専用のリクエストを送ります。このポートを転送したり、外部に公開したり、接続先をリモートアドレスに置き換えたりしないでください。エクスポーターはSQLiteデータベースを直接読み取らず、PDFを開かず、引用文をアップロードせず、Zoteroに変更を書き戻すこともありません。
実行中の同期があれば完了を待ち、書き出しが終わるまで編集と同期を停止しておきます。次の同期が始まらないよう、コンピューターをネットワークから切り離すこともできます。Local APIはオフラインで動作します。完了するまで、注釈の追加、出典メタデータの変更、Zoteroの再起動はしないでください。プログラムは件数、キー、バージョン情報を確認しますが、これによって書き出しがトランザクションスナップショットになるわけではありません。古いZoteroのLocal APIが返す同期済みバージョン番号は、ローカルで編集しても変わらない場合があります。
3. エクスポーター全体をプレーンテキストファイルに保存する
同じコンピューターで、比較的新しいNode.jsのLTS版を使用します。ターミナルを開き、node --versionを実行してNodeが使えることを確認します。このエクスポーターでは、npmやpipによるパッケージのインストールは不要です。ハードリンクに対応した通常のローカルディスク上に作業フォルダーを作成してください。ネットワーク上や特殊な仮想ファイルシステム上でも動くとは限りません。
次の段落にあるプログラム全体をプレーンテキストエディターにコピーし、UTF-8でexport_zotero_annotations.mjsという名前で保存します。半角のまっすぐな引用符、バックスラッシュ、その他すべての記号をそのまま保ってください。拡張子が.mjs.txtではなく、本当に.mjsで終わっていることを確認します。このページではコードが1つの長い段落に見える場合があります。複数行の版に加え、空白や改行をまとめた版もテスト済みです。
import {open,link,unlink} from 'node:fs/promises'; import {resolve} from 'node:path'; import {randomUUID} from 'node:crypto'; const fail=c=>{const e=new Error(c);e.code=c;throw e;}; const str=v=>{if(v==null)return '';if(typeof v!=='string')fail('INVALID_FIELD');return v;}; const key=v=>{if(typeof v!=='string'||!/^[A-Z0-9]{8}$/.test(v))fail('INVALID_KEY');return v;}; const item=o=>{if(!o||!o.data||key(o.key)!==key(o.data.key)||!str(o.data.itemType))fail('INVALID_ITEM');return o;}; const array=v=>{if(v==null)return [];if(!Array.isArray(v))fail('INVALID_ARRAY');return v;}; let temporary,handle,serverID,version,total,published=false; try { const port=process.env.ZOTERO_PORT||'23119'; if(!/^\d+$/.test(port)||1>Number(port)||Number(port)>65535)fail('INVALID_PORT'); if(process.argv.length>3)fail('USAGE'); const output=resolve(process.argv[2]||'zotero-annotations.csv'); const base='http://127.0.0.1:'+port+'/api/users/0/items'; async function get(suffix){ let r;try{r=await fetch(base+suffix,{method:'GET',redirect:'error',headers:{'Zotero-API-Version':'3',...(serverID?{'Zotero-Server-ID':serverID}:{})},signal:AbortSignal.timeout(30000)});}catch{fail('LOCAL_REQUEST_FAILED');} if(!r.ok)fail('HTTP_'+r.status); const id=r.headers.get('Zotero-Server-ID'); if(serverID!==undefined&&id!==serverID)fail('SERVER_CHANGED');serverID=id; const api=r.headers.get('Zotero-API-Version');if(api&&api!=='3')fail('API_VERSION'); let data;try{data=await r.json();}catch{fail('INVALID_JSON');} return {data,headers:r.headers}; } async function page(start,limit){ const r=await get('?format=json&itemType=annotation&sort=dateAdded&direction=asc&limit='+limit+'&start='+start); const n=r.headers.get('Total-Results');if(!n||!/^\d+$/.test(n)||!Number.isSafeInteger(Number(n)))fail('INVALID_TOTAL'); if(total!==undefined&&total!==Number(n))fail('TOTAL_CHANGED');total=Number(n); const v=r.headers.get('Last-Modified-Version');if(!v||!/^\d+$/.test(v)||!Number.isSafeInteger(Number(v)))fail('INVALID_VERSION');if(version!==undefined&&version!==v)fail('LIBRARY_CHANGED');version=v; if(!Array.isArray(r.data)||r.data.length!==Math.min(limit,Math.max(0,total-start)))fail('PAGE_COUNT_MISMATCH'); return r.data; } const annotations=[],seen=new Set(),cache=new Map(); do {const batch=await page(annotations.length,100);for(const o of batch){item(o);if(o.data.itemType!=='annotation'||!str(o.data.annotationType))fail('INVALID_ANNOTATION');if(seen.has(o.key))fail('DUPLICATE_KEY');seen.add(o.key);annotations.push(o);}} while(total>annotations.length); if(seen.size!==total)fail('COUNT_MISMATCH'); async function parent(k){key(k);if(!cache.has(k)){const o=item((await get('/'+k+'?format=json')).data);if(o.key!==k)fail('PARENT_KEY_MISMATCH');cache.set(k,o);}return cache.get(k);} const headers=['annotationKey','type','text','comment','tagsJSON','pageLabel','attachmentKey','attachmentTitle','sourceKey','sourceTitle','sourceCreatorsJSON','sourceAuthorsJSON','sourceDate','sourceParsedDate','sourceYear','sourceStatus','annotationAuthorName','annotationDateAdded','annotationDateModified']; const rows=[headers];let standalone=0,nontext=0; for(const o of annotations){ const a=o.data,p=await parent(a.parentItem),d=p.data;if(d.itemType!=='attachment')fail('PARENT_NOT_ATTACHMENT'); let source=null;if(d.parentItem)source=await parent(d.parentItem); if(source&&['attachment','annotation','note'].includes(source.data.itemType))fail('SOURCE_NOT_BIBLIOGRAPHIC'); const s=source?.data||{},parsed=str(source?.meta?.parsedDate),year=/^(?!0000)\d{4}(?:-\d{2}(?:-\d{2})?)?$/.test(parsed)?parsed.slice(0,4):''; const tags=array(a.tags),creators=array(s.creators);if(tags.some(t=>!t||typeof t.tag!=='string')||creators.some(c=>!c||typeof c.creatorType!=='string'))fail('INVALID_METADATA'); const textType=['highlight','underline'].includes(a.annotationType);if(!textType)nontext++;if(!source)standalone++; rows.push([o.key,a.annotationType,textType?str(a.annotationText):'',str(a.annotationComment),JSON.stringify(tags),str(a.annotationPageLabel),p.key,str(d.title),source?.key||'',str(s.title),source?JSON.stringify(creators):'',source?JSON.stringify(creators.filter(c=>c.creatorType==='author')):'',str(s.date),parsed,year,source?'bibliographic':'standalone-attachment',str(a.annotationAuthorName),str(a.dateAdded),str(a.dateModified)]); } const check=await page(0,1);if(check.length&&item(check[0]).key!==annotations[0].key)fail('LIBRARY_CHANGED'); const csv=rows.map(row=>row.map(v=>'"'+v.replaceAll('"','""')+'"').join(',')).join('\r\n')+'\r\n'; const pending=output+'.partial-'+randomUUID();handle=await open(pending,'wx',0o600);temporary=pending;await handle.writeFile(csv,'utf8');await handle.sync();await handle.close();handle=null;await link(temporary,output);published=true; console.log('Exported '+annotations.length+' annotation records to '+output);console.log('Standalone rows: '+standalone+'; non-text rows: '+nontext+'.'); } catch(e){console.error((published?'CSV published; reporting failed: ':'Export failed; no new completed CSV was published: ')+(e.code||'UNEXPECTED')+'.');process.exitCode=1;} finally {if(handle)await handle.close().catch(()=>{});if(temporary)await unlink(temporary).catch(e=>{if(e.code!=='ENOENT')console.error('Temporary-file cleanup failed: '+temporary);});}
ファイルを保存したフォルダーでターミナルを開き、以下の構文チェックを実行します。問題がなければ、通常は何も表示せずプロンプトに戻ります。このチェックが確認するのは保存したプログラムの構文です。Zoteroに接続できるか、ライブラリのデータがすべて取得できるかを確認するものではありません。
node --check export_zotero_annotations.mjs
4. 新しいファイル名でCSVに書き出す
Zoteroを起動したまま内容を変更せず、同じ作業フォルダーで次のコマンドを実行します。引用符で囲んだファイル名は、新しく作成するファイルの名前です。既存の書き出しファイルを更新するための指定ではありません。
node export_zotero_annotations.mjs "zotero-annotations.csv"
ターミナルに「Exported」と表示され、その後に注釈レコード数と出力先のパスが示されるまで待ちます。独立した添付ファイルに属する行数と、非テキストの行数も表示されます。これらは内訳を示す件数であり、書き出し総数に加える追加レコードではありません。表計算ソフトで確認するため、表示された件数を控えてください。
プログラムは注釈レコードを複数のバッチに分けて取得し、応答を検証して、参照先の添付ファイルと出典を読み取ります。その後、出力先と同じフォルダーに一時ファイルを書き込み、書き込みが完了してから最終ファイル名を作成します。既存の出力ファイルは置き換えません。再度実行する場合は、zotero-annotations-2.csvなど、別の名前を使ってください。名前に.partialを含むファイルが残っていても、それは完成した成果物ではありません。
5. 注釈と出典の各列を理解する
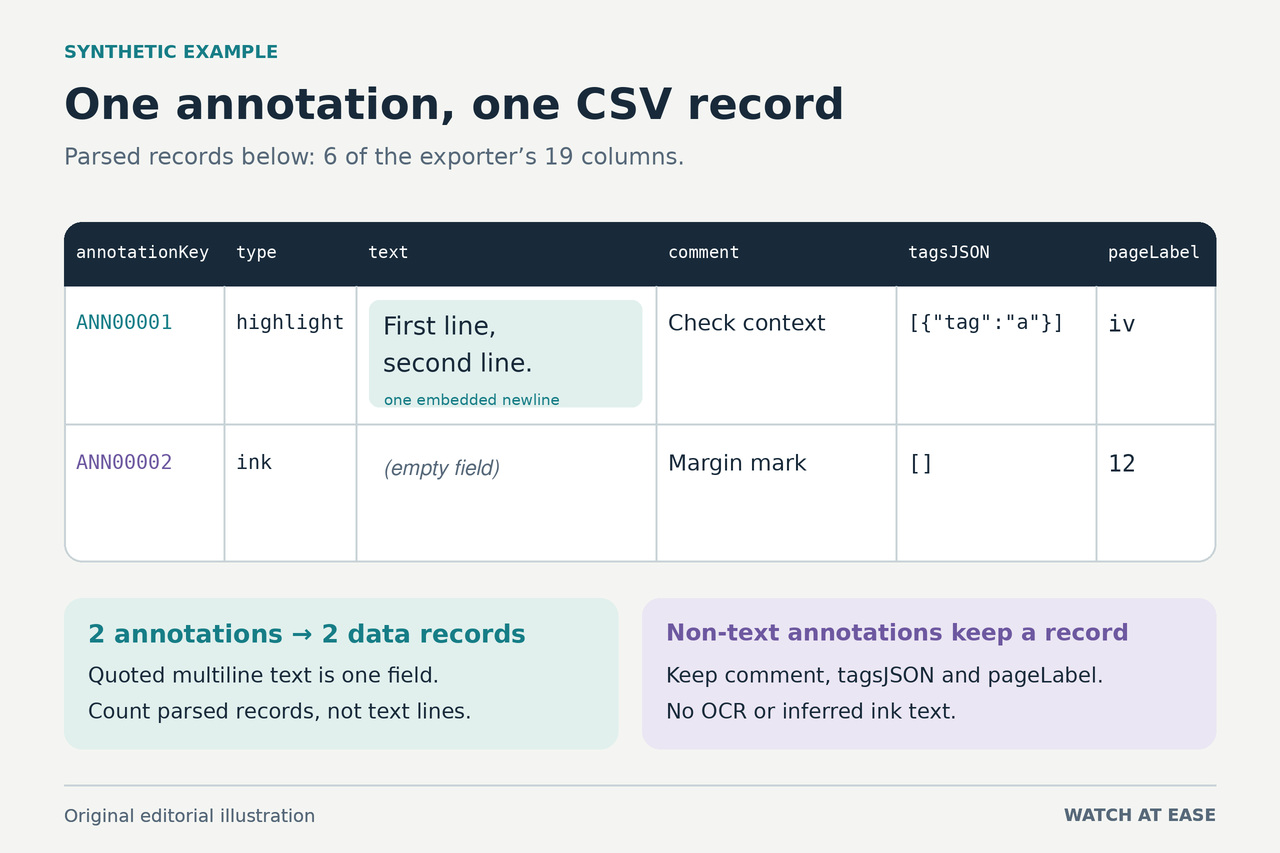
列は19個あります。annotationKeyは注釈を識別し、typeはその種類を示します。textにはハイライトと下線の対象文章が入り、commentには注釈のコメントを別に保持します。tagsJSONは注釈のタグオブジェクトをJSONテキストとして保存します。区切りが曖昧になる可能性のあるカンマ区切りのタグ名に置き換えず、構造を保持します。
pageLabelは、Zoteroの注釈に付いているページラベルをそのまま保持します。添付ファイル内の物理的なページ順の番号に置き換えたり、ラベルが必ず数値だと考えたりしないでください。前付けなど、文書の構成によって異なるラベルが使われることがあります。attachmentKeyとattachmentTitleは、その注釈を含む添付ファイルを識別します。
sourceKeyとsourceTitleは、書誌情報を持つ親アイテムがある場合に、そのアイテムを識別します。sourceCreatorsJSONは、出典の作成者リストと役割を構造化されたまま保持します。sourceAuthorsJSONに含まれるのは、役割がauthorである作成者だけです。編者を黙って著者として扱ったり、著者リストが空の場合に注釈を付けた人の名前で補ったりすることはありません。
sourceDateは、出典アイテムの元の日付文字列を保持します。Zoteroが解析済みの出典日付を返す場合は、sourceParsedDateに入ります。sourceYearは、解析済みの値がYYYY、YYYY-MM、YYYY-MM-DDのいずれかに一致し、4桁の年がゼロでない場合に限って取り出します。これは限定的な抽出ルールであり、暦の上で正しい日付かどうかを検証するものではありません。値がない場合や形式が異なる場合は、推測せず空欄にします。
sourceStatusは、書誌情報を持つ親アイテムがあればbibliographic、なければstandalone-attachmentになります。独立した添付ファイルのレコードでは、添付ファイル情報は保持し、出典フィールドは空欄にします。最後のannotationAuthorName、annotationDateAdded、annotationDateModifiedは、注釈そのものについての情報です。いずれも出版物の著者や日付の代わりには使いません。
6. 非テキストのレコードと不足しているメタデータを把握する
画像、インク、ノートなど、ハイライトや下線以外の種類にも、利用できるコメント、タグ、識別情報を含む行を作成します。text列は空欄です。プログラムは手書き文字を認識せず、画像領域を引用文に変換せず、画像やインクそのものも書き出しません。非テキストの件数は、分析時にこの違いを考慮すべきレコードが何件あるかを示します。
出典の著者、出版日、ページラベルが欠けている場合は、空欄の意味を判断する前にZoteroで対応するレコードを確認します。必要に応じてZotero側の出典メタデータを修正し、編集と同期が停止してから改めて書き出してください。表のすべてのセルを埋めるためだけに、不明な出版日を注釈の日付で置き換えないでください。
0件の書き出しが正常に完了した場合、CSVには列の見出しだけが入ります。これは、この対象範囲で条件に合うZotero標準の注釈レコードが返されなかったことを意味します。PDFに一度もハイライトが付けられていなかった証明にはなりません。資料がグループライブラリにないか、古いノートにしか残っていないか、外部で注釈を付けたファイルに埋め込まれたままではないかを確認してください。このプログラムは、そうした入力を変換しません。
7. CSVを文字列として取り込み、レコードを確認する
ファイルをダブルクリックして開くことに任せず、表計算ソフトのText/CSV取り込み機能を使います。文字コードはUTF-8、区切り文字はカンマ、テキストを囲む文字は二重引用符を選び、読み込む前にすべての列を文字列(Text)に設定します。取り込み画面に自動変換や数式としての解釈を無効にする項目があれば、無効にしてください。プレビューの時点でページラベル、日付、引用文が変わっていたら、キャンセルして文字列として取り込み直します。
CSVではすべてのフィールドを引用符で囲み、フィールド内の引用符は2つ重ね、レコードの区切りにはCRLFを使います。引用文やコメントに含まれる元の改行は、セルの中に残ります。そのため、テキストエディター上では1レコードが複数の物理行にまたがることがあります。見出しを除いた、表計算ソフトが読み取ったレコード数をターミナルの注釈件数と照合してください。元のファイルの行数は数えません。
選んでおいた例をZoteroと照合します。引用文、コメント、タグ、ページラベル、添付ファイル、出典の書誌情報が正確か確認してください。複数行のコメントが1つのセルに収まり、カンマや引用符によって余分な列ができていないことも確認します。独立した添付ファイルのレコードや非テキストのレコードがあれば、それらも確認してください。提示用のコピーでJSON列を非表示にする場合も、元の書き出しファイルではそのまま保持します。
分析結果は別のブックまたはファイルに保存します。後で絞り込んだ結果を元の書き出しまで追跡できるよう、オリジナルのCSVと表示された件数を残してください。レコード数と、代表例の出典への対応関係がZoteroで確認した内容と一致したら、分析や共有に使う準備ができたと判断できます。
8. チェックを省略せずにエラーを解決する
EEXISTは出力ファイル名がすでに存在することを意味します。別の新しいファイル名を選んでください。HTTP_403の場合は、Zoteroのローカル通信設定を確認します。LOCAL_REQUEST_FAILEDの場合は、Zoteroが同じコンピューターで起動し、通常のローカルポートで接続できることを確認してください。タイムアウトやリダイレクトの拒否でも同じコードになることがあります。接続先をクラウドのエンドポイントに変更するのではなく、原因を解消して再実行します。
件数の変化、キーの重複、ライブラリのバージョンやサーバー識別情報の変化が検出された場合、プログラムのチェックでは一貫した読み取りを確認できなかったことを意味します。編集と同期を停止し、意図したZoteroライブラリが開いていることを確認してから、最初から実行し直してください。親アイテムの欠落、HTTP_404、想定外の親アイテムの種類は、参照先レコードを安全に結び付けられなかったことを意味します。エクスポーターは、その注釈を黙って除外せずに停止します。
INVALID_TOTAL、INVALID_VERSION、API_VERSION、不正なフィールドやスキーマのエラーは、応答がこのプログラムの想定を満たしていないことを意味します。ライブラリはそのまま保持し、調査のために診断コードを控えてください。完全に見えるCSVを無理に作るために、検証用のコード行を削除しないでください。ファイルシステムのエラーでは、フォルダーの権限とハードリンクへの対応を確認し、適切なローカルディスク上の新しい出力先を使います。
9. 提供プログラムのテスト範囲を理解する
このプログラムの元の形式は、Linux上のNode 24.19.0とPython 3.12.14で、合成データを使った28件のテストに合格しました。ランダムに選んだループバックポート上の模擬Local APIを使い、2ページにまたがる101レコード、ちょうど100レコード、空の結果、親アイテムの欠落、応答の変化、既存ファイルを上書きしようとするケースを確認しました。Pythonの独立したCSVリーダーで、Unicode、フィールド内の引用符や改行を含む出力フィールドを検証しています。
同じ101レコードのテスト用データに対し、元の複数行版と、その空白や改行をまとめた版は、バイト単位で同一のCSVを出力しました。これらの確認では、実際のZoteroプロセス、アカウント、ライブラリ、表計算ソフトのGUIは使用していません。WindowsやmacOSでのテストでもありません。また、プログラムは書き出しデータをメモリ上に組み立てます。大規模なライブラリを処理できる容量は検証していません。CSVを使用する前の最終確認は、ご自身のデータのレコード数と出典を照合することです。 掲載コードでは、意味を変えずに2か所の数値比較の左右を入れ替えています。メモリ上のJavaScriptの模擬実装を使った追加の13ケースで、元の書き方と掲載版のCSVバイト列、メッセージ、操作順序がすべて一致しました。この比較ではNodeも実際のファイルシステムやネットワークも使用しておらず、元の28件のNode/Pythonテストは再実行していません。