テクノロジー · 実用ガイド
Trakt にインポートした映画の誤った視聴日を修正する
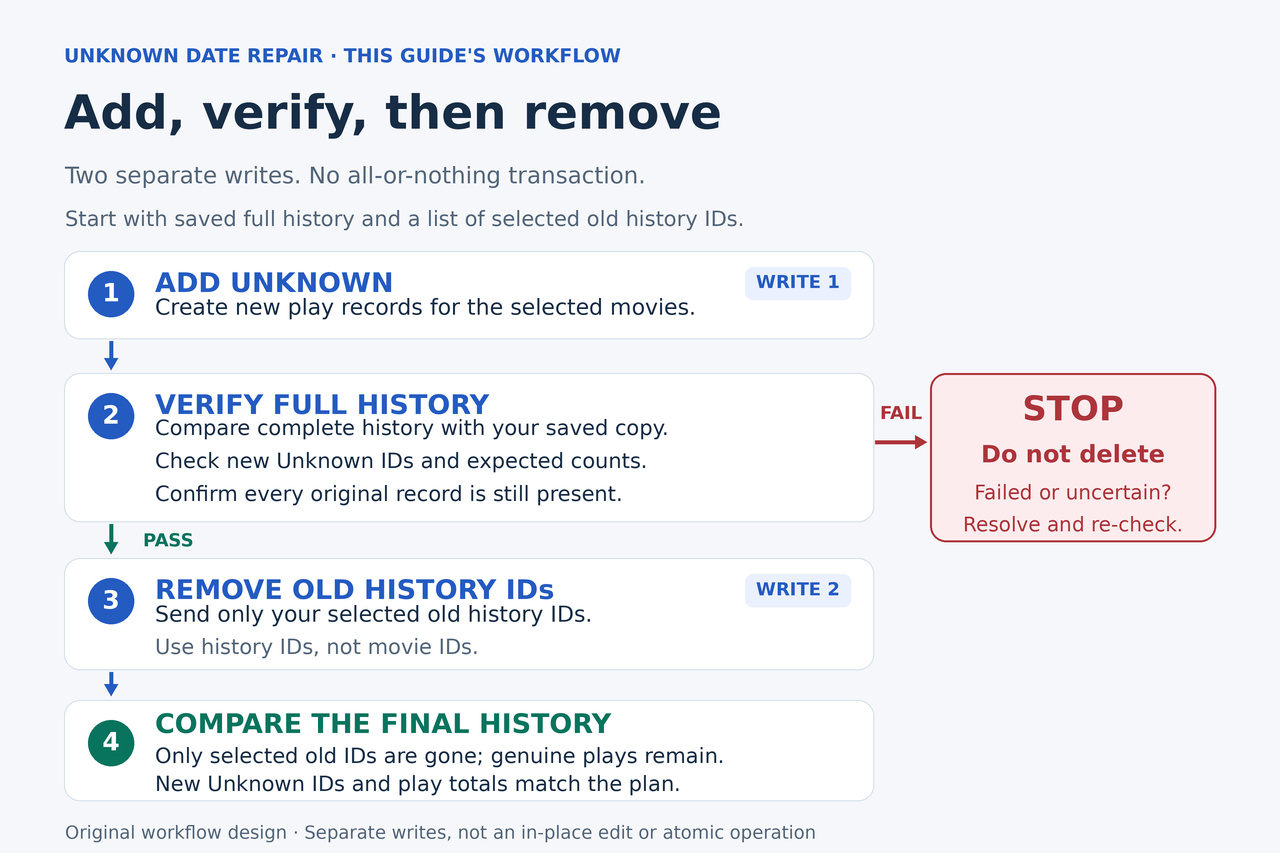
視聴済みの状態を保ちながら、選んだ誤った日付を Unknown(日付不明)に置き換えます。まず対象のインポートを正確に特定して取り消せるか確認し、それができなければ視聴記録を個別に確認して、置き換え後の記録を検証してから古い記録を削除します。
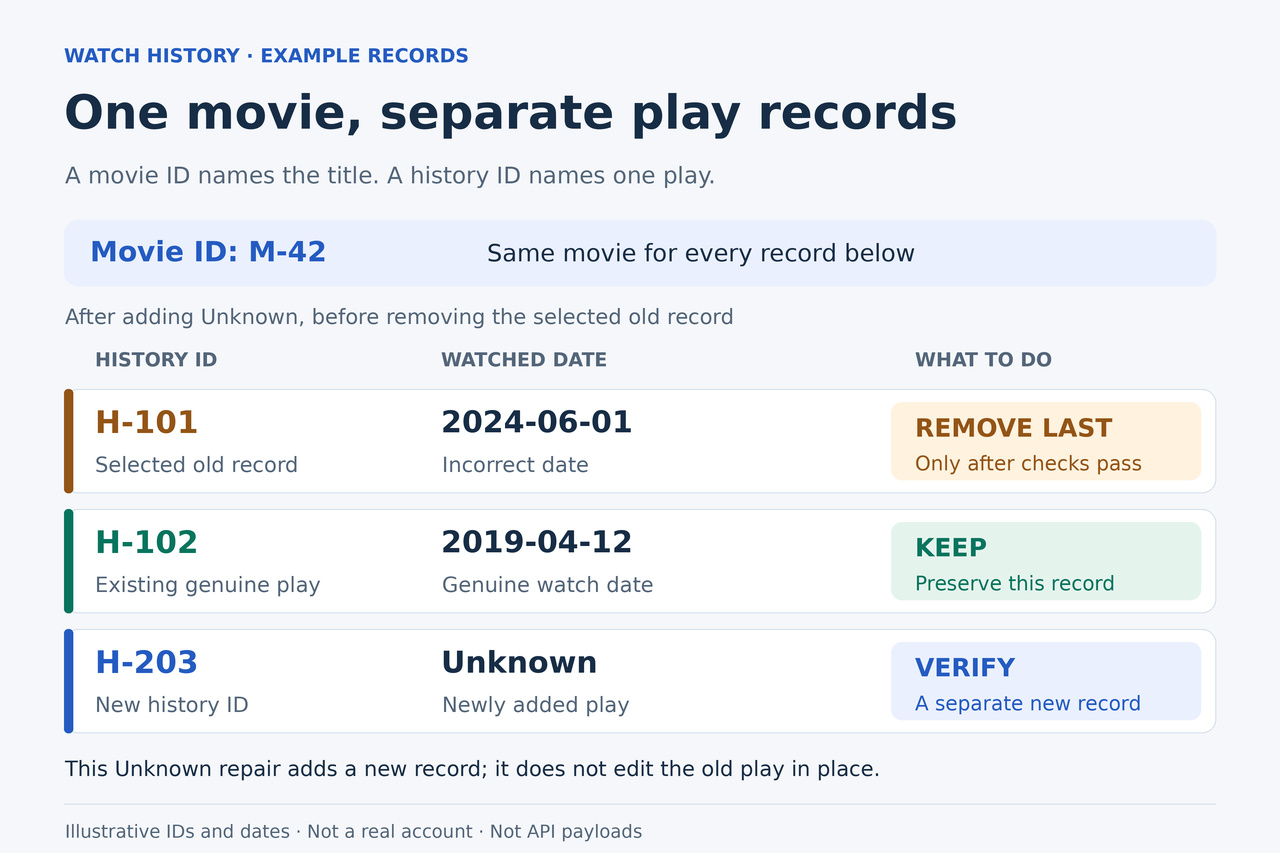
過去に IMDb や Letterboxd からインポートしたために、映画をすべて同じ日に観たようになっている場合、Trakt の Unknown(日付不明)を使えば、視聴日を作り上げることなく、観たという事実を残せます。Unknown の視聴記録は総視聴回数には含まれますが、日付に基づく統計からは除外されます。Unknown を追加するだけでは、誤った日付の古い視聴記録は消えません。
最初に、取り消したいインポートを正確に特定できる取り消し方法があるか確認します。一部の記録だけを修正する場合に備え、このガイドではローカルで使う Python 補助ツールの全コードを用意しています。誤った視聴記録を選び、置き換え用の Unknown を追加し、結果を検証してから、選択した元の履歴 ID だけを削除します。補助ツールはデータを読み取り、ファイルを準備します。アカウントを変更する 2 つの処理は別々のコマンドで行い、内容を確認したうえで自分で実行します。
どの日付が実際に誤っているか判断する
元のインポート用データを、新たに取得した Trakt のバックアップと一緒に保管します。日付が集中していれば候補を見つける手がかりになりますが、その日の視聴記録がすべて間違っている証拠にはなりません。映画、元データの記録、自分の記憶を照合してください。本当にその日に観た記録は修正対象から外します。
Letterboxd では、ある時点で映画を観たとマークすることと、特定の視聴を Diary(ダイアリー)に記録することを区別しています。元ファイルの Date 列が、そのまま視聴日を意味するとは限りません。信頼できるダイアリーの日付がある場合は、日付を指定して修正するために残してください。今回のバッチは、本当の視聴日が分からない記録だけを対象にします。
1 つの計画で選ぶ誤った視聴記録は、映画ごとに最大 1 件にします。正しい日付が付いた再視聴の記録は残してください。選択した映画にすでに Unknown の視聴記録がある場合は停止し、それぞれの記録が何を表すのかを判断します。この補助ツールは、そのような記録を統合しません。また、日付不明の複数の再視聴を別々に表せると保証するものでもありません。
対象のインポートだけを特定して取り消せるか確認する
Trakt の資料には、インポート同期の一覧を取得する GET /users/syncs/import、1 件を確認する GET /users/syncs/ID、取り消す DELETE /users/syncs/ID が記載されています。sync ID はインポート処理を識別する ID であり、映画 ID でも履歴 ID でもありません。古いインポートを探す際は、返されたすべてのページを確認してください。
この代替方法を使うのは、その記録から不要なインポートを確実に特定でき、インポート全体を取り消したい場合だけです。取り消しでは、インポートされた視聴履歴、評価、一時停止中の項目、Watchlist、コレクションが元に戻されることがあります。日付が同じ、件数が似ているというだけでは、同じインポートだとは確認できません。取得できた記録からバッチを特定できなければ、そのままにして、対象を選んで修正する手順を使います。
過去のファイルインポートすべてに特定可能な同期記録がある、あるいは現在の画面に取り消しボタンがあるとは考えないでください。確認済みのバッチを取り消した場合は、結果を再取得し、元データから修正した入力を用意して、作品の照合結果と選択したデータの種類をプレビューし、再インポートの結果を検証します。その後に一部の記録を選んで修正する計画を作る場合は、取り消し後の新しい基準データから始めてください。
アクセス権、バックアップ、非公開の作業フォルダーを用意する
Bash と Python 3.10 以降、curl 7.76.0 以降を使います。利用許可のある自分の Trakt アプリでアクセス権を取得し、下記リンク先の最新の公式手順に従って自分のアカウントを認証してください。アプリ登録には、確認済みの GitHub 連携と空きアプリ枠が必要です。実際のアカウント条件や承認上の制限が適用されます。この記事は、固定の無料枠があることや、すべての利用者に VIP が必要であることを前提にはしていません。
補助ツールを使う前に、Trakt の必須ヘッダーと OAuth の資料に従って、リクエストヘッダーを保存するローカルファイルを用意します。Authorization、trakt-api-key、trakt-api-version、Content-Type、User-Agent の各フィールドを 1 行ずつ記載し、API バージョンは 2、コンテンツの種類は JSON にします。自分が認証を受けた値を使い、このファイルは非公開で保管し、内容をこのウェブサイトに貼り付けないでください。補助ツールは、この準備済みファイルを取り込みます。アプリ登録や認証の取得を代行するものではありません。
現在の OAuth ホストは auth.trakt.tv です。以下のデータ操作コマンドは api.trakt.tv を使います。デバイス認証を使う場合は、返されたポーリング間隔と有効期限に従ってください。バッチの途中では、同じ有効な認証情報ファイルを使い続けます。保存したスナップショットは、そのファイルと結び付けられています。途中でアクセス権が失効したりファイルが変わったりした場合は停止し、バッチのファイルを保管してください。この補助ツールは、途中まで進めたバッチを新しい認証情報へ移行しません。
書き込みの前に、アカウントをエクスポートします。現在の JSON ZIP では、個々の視聴記録は watched-history.json または番号付きの watched-history-N.json に入っています。watched-movies.json は集計データです。エクスポート結果と、存在する場合は _errors.json を確認してください。ZIP をダウンロードできても、内容が一部しか取得されていない場合があります。使えるバックアップとして扱う前に、必要な情報に影響するエラーを解消しましょう。
スクロブラーによる視聴状況の自動記録と自動インポートを一時停止し、検証が終わるまで、ほかの履歴、評価、Watchlist の編集も避けます。このバッチ用に新しい空のローカルフォルダーを作り、そこで Bash を開いてください。公式エクスポートは別に保管します。ページ分割されたデータの取得は、アカウントの状態を一度に固定して取得する仕組みではありません。ほかの書き込みを停止して全ページを確認すれば誤りは減らせますが、API を一括で完了するトランザクションに変えることはできません。
補助ツールを配置し、完全な基準データを読み取る
末尾の「ローカル用補助ツールの全コード」には、ソースファイルを書き出すコマンドが 1 つ、完全な形で掲載されています。そのコマンド全体を、空の作業フォルダーで開いた Bash にコピーしてください。ローカルに trakt_repair.py を作成するだけで、API リクエストは行わず、既存ファイルの上書きも拒否します。実行する前に、作成された読み取り可能な Python ファイルを開いて確認しましょう。ファイル内のコメント、確認メッセージ、コマンドは、どの言語版でも英語のままです。
公式手順に従って用意した非公開のヘッダーファイルを使い、補助ツールを初期化します。次のコマンド内のファイルパスの例を、実際のローカルパスに置き換えてください。空白を含むパスは引用符で囲みます。以降のコマンドも、すべて同じ作業フォルダーで実行してください。取り込んだ認証情報と作業データは、trakt-repair 内の非公開ファイルとして保存されます。
python3 trakt_repair.py init trakt-headers.txt
基準データを読み取ります。このコマンドが行うのは、映画の視聴履歴、映画の評価、映画の Watchlist に対する認証付き GET リクエストだけです。レスポンスの生バイト列、ページ分割のメタデータ、すべてを結合した完全な JSON ファイルを保存します。
python3 trakt_repair.py fetch before
完全なスナップショットが取得できたと表示された場合にだけ先へ進みます。収集処理は、返されたページ数、実際に適用された取得件数の上限、総項目数を使い、最後に先頭ページをもう一度確認します。ページ分割情報の欠落、件数の足りないページ、ID の重複、想定外の映画データ構造、または取得中に確認された変更があると、そのスナップショットは使用不可のままになります。無理に通すために INCOMPLETE を削除してはいけません。読み取りエラーを解消したら、新しいスナップショット名で取得し直し、後のプレビューと計画作成コマンドでもその名前を使ってください。
完全な基準データから確認用 CSV を作ります。Python は元の大きな整数 ID をそのまま保持します。確認用ファイルでは h:、m:、t:、at: という接頭辞を使い、ID、タイトル、タイムスタンプを表計算ソフトで文字列として扱えるようにしています。
python3 trakt_repair.py preview before
誤った視聴記録を選び、計画を確認する
trakt-repair/before-review.csv を開きます。自分で日付が誤っていると確認した視聴記録だけ、choose 列に正確に YES と記入し、UTF-8 CSV として保存してください。それ以外のセルと接頭辞は一切変えません。記載されているタイムスタンプは API の値です。Trakt の画面に表示される Today は、異なる表示用タイムゾーンを反映している場合があります。計画を作成するとき、補助ツールは選択済み CSV のコピーを別途保存します。
python3 trakt_repair.py plan before trakt-repair/before-review.csv
計画作成処理では、選択した各履歴 ID を生の基準データと照合し、映画、タイトル、元のタイムスタンプを確認します。同じ映画を重複して選んでいたり、選択した映画にすでに Unknown があったりすると拒否します。置き換え案を表示し、正確に YES と入力しなければ計画を保存しません。Trakt は、タイムスタンプの分単位への正規化と、項目と時刻を組み合わせた重複排除を告知しています。秒の値を変えても、日付不明の再視聴を別々に残す方法にはなりません。
選択した映画が標準の Watchlist にある場合、計画はその映画 ID を表示し、Watchlist からの削除を受け入れるか別途確認します。Trakt では、視聴済みとマークすると、その項目が Watchlist から削除されることがあります。確認した資料には、Unknown を例外とする記述はありません。この結果を受け入れる場合にだけ、YES, REMOVE FROM WATCHLIST と入力してください。受け入れない場合は停止し、それらの作品を除外して再確認します。検証対象は Watchlist に含まれる作品であり、メモ、順位、元の追加日が維持されるかどうかは確認しません。
テキストエディターで trakt-repair/plan.json と trakt-repair/add.json を確認します。追加リクエストでは映画 ID を使い、watched_at に文字列 unknown をそのまま設定します。null に置き換えたり、値を省略したり、架空の古い日付を使ったりしないでください。この時点では削除リクエストはまだありません。まず日付が誤っていると確認できた 1 件で試し、最終検証に合格したら、より大きなバッチのために新しい空の作業フォルダーを別に作って基準データを取得し直します。既存の計画は、意図的に上書きできない設計です。
Unknown を追加し、置き換え用の記録を検証する
次のコマンドが、最初のアカウント変更です。add.json を確認してから、1 回だけ実行してください。レスポンス本文とヘッダーは保存します。各書き込みコマンドは未使用のレスポンス保存ファイル名を必要とし、暗黙の curl 設定を無効にしており、自動リトライやリダイレクト追従のオプションもありません。レスポンスファイルがすでにあるために拒否された場合は、保存済みの状態を確認してください。ファイルを削除して書き込みを繰り返す理由にはなりません。
test ! -e trakt-repair/add-response.json && test ! -e trakt-repair/add-response-headers.txt && curl -q --fail-with-body --silent --show-error --request POST --header @trakt-repair/auth.headers --data-binary @trakt-repair/add.json --dump-header trakt-repair/add-response-headers.txt --output trakt-repair/add-response.json --write-out 'HTTP %{http_code}\n' https://api.trakt.tv/sync/history
リクエストから応答が返ったら、エラーや結果のはっきりしない応答だった場合も含めて、新しい完全なスナップショットを取得し、中間検証を実行します。追加件数や HTTP の成功結果だけでは、現在どの履歴 ID が存在するかは確認できません。
python3 trakt_repair.py fetch after-add
python3 trakt_repair.py verify-add after-add
この検証では、選択した映画ごとに新しい Unknown の履歴 ID がちょうど 1 つ必要です。同時に、元からある映画の全視聴記録が残り、映画、分単位に正規化したタイムスタンプ、action が同じでなければなりません。映画の評価と評価日時も一致する必要があります。Watchlist では、計画で受け入れた削除だけが許され、追加や無関係な作品の削除があれば停止します。
再取得したデータでは、Unknown は UTC の正確な時点 1970-01-01T00:00:00Z を表します。末尾が .000Z となる同等の表記も、同じ時点を意味します。補助ツールは解析した時点同士を比較し、日付全体や年だけでは比較しません。リクエストでは引き続き、文字列 unknown をそのまま使います。検証済みの新しい ID は、選択した元の ID とは別に保存します。
中間検証に合格した場合にだけ、trakt-repair/add-verified.json と trakt-repair/remove.json が作成されます。後者を確認してください。最上位の ids 配列には、選択した元の履歴 ID だけが入っていなければなりません。movies 配列では削除範囲が広くなるため、置き換えてはいけません。新しい Unknown の ID を、このリクエストに含めてはいけません。
一時的に、選択した映画ごとに視聴記録が 1 件増えます。古い記録を削除する前に置き換え用の記録を検証するので、その映画の視聴記録が意図的に 0 件になる時間を避けられます。ただし、これはあくまで別々の API 書き込み 2 回であり、アカウント側への影響が生じる可能性があります。既存の記録の日付をその場で編集する処理ではありません。
古い ID だけを削除し、完了を検証する
中間検証に合格し、remove.json を確認してから、アカウントを変更する 2 つ目のコマンドを実行します。deleted と not_found の情報も含め、レスポンスを保管してください。
test ! -e trakt-repair/remove-response.json && test ! -e trakt-repair/remove-response-headers.txt && curl -q --fail-with-body --silent --show-error --request POST --header @trakt-repair/auth.headers --data-binary @trakt-repair/remove.json --dump-header trakt-repair/remove-response-headers.txt --output trakt-repair/remove-response.json --write-out 'HTTP %{http_code}\n' https://api.trakt.tv/sync/history/remove
新しい完全なスナップショットを取得し、最終結果を検証します。
python3 trakt_repair.py fetch final
python3 trakt_repair.py verify-final final
成功した状態とは、元の映画の視聴履歴から選択した古い ID を除き、先ほど検証した特定の新しい Unknown ID を加えた状態です。選択していない元の視聴記録と置き換え用の各記録は、映画、正規化後のタイムスタンプ、action が期待どおりでなければなりません。映画の評価は変わらず、映画の Watchlist に含まれる作品は追加処理後のスナップショットと一致する必要があります。合計件数が一致するだけでは合格しません。
これらの条件を満たすと、補助ツールは final-verified-final.json を書き出します。選択した視聴記録 1 件につき 1 件を置き換えるため、映画の総視聴回数は基準データの合計に戻り、正しい日付の再視聴記録は残ります。別途、修正した映画をいくつか Trakt で開いて目視確認してください。視聴済みの状態と Unknown の視聴記録が残り、選択した誤った日付は表示されなくなっているはずです。Unknown は日付に基づくグラフから除外される想定です。
元データ、公式エクスポート、生のスナップショット、選択済み CSV、計画、リクエスト、レスポンス、検証ファイルは非公開で保管します。置き換え後の記録には新しい履歴 ID が付きます。削除した視聴記録の元のスクロブルやチェックインの同一性は、この処理では維持されません。最終結果を受け入れてから、一時停止したインポートを再開してください。
読み取りや追加が止まったら、保存済みの段階を保持する
読み取りが失敗した場合、完全な基準データや結果を確認できたことにはなりません。HTTP エラーでは、補助ツールはレスポンスのステータス、関連するレスポンスヘッダー、本文を、タイムスタンプ付きの get-error ファイルに保存します。そこにリクエスト用の認証情報は保存しません。スナップショットは INCOMPLETE のままです。報告された問題を解消し、新しいスナップショット名を選んでください。失敗時の証拠を上書きしてはいけません。
追加したはずの記録が一部しか確認できない場合、verify-add は新しい Unknown ID と不足している映画を示す add-incomplete レポートを書き出します。remove.json は作成しません。追加リクエスト全体を再送したり、元の記録を削除したりしないでください。処理中のリクエストが完了してから、後の状態を新しい名前のスナップショットとして取得し、その名前で verify-add を実行します。期待どおりの結果がすべて確認できれば、検証済みの段階から続けます。
この補助ツールは、追加できなかった分を自動で追加するリクエストを生成しません。結果が一部だけのままなら、レポートを残してその修正作業を停止するか、新たに確認したあとで下記の放棄手順を使ってください。予期しない新しい視聴記録、元の記録の欠落、評価の変更、受け入れていない Watchlist の変更があれば調査が必要です。無理に合格させるために、管理ファイルを書き換えたり検証を取り除いたりしてはいけません。
Trakt が公表している上限は、認証付きの書き込みが 1 秒あたり 1 回、認証付き GET リクエストが 5 分あたり 500 回です。429 レスポンスでは Retry-After に従ってください。ほかのアプリも同じアカウントの利用枠を共有する場合があります。認証、アプリの承認、アカウントの上限、不正なデータは、それぞれ異なるエラーです。403、420、422、426 のすべてがトークンの交換で解決するわけではありません。また、この補助ツールは進行中のバッチを既存の認証情報ファイルに結び付けています。
削除が一部だけなら、残っている選択済み ID だけを再試行する
削除の応答から結果がはっきりしない場合は、まず新しいスナップショットを取得し、verify-final を実行します。残すべき記録がすべて正しく、選択した元の ID の一部だけが残っている場合、補助ツールはその ID だけを含む remaining-remove ファイルを作成します。完了とは報告せず、停止します。件数が合わない問題を、ある映画の全視聴記録を削除して解決することはありません。
次の例が使えるのは、verify-final final により trakt-repair/remaining-remove-final.json が作成された場合だけです。使う前に、そのファイル自体を確認してください。スナップショットに別の名前を使った場合は、補助ツールが実際に報告した remaining-remove ファイル名と、新しいレスポンス保存ファイル名を使います。
test ! -e trakt-repair/remove-retry-response.json && test ! -e trakt-repair/remove-retry-response-headers.txt && curl -q --fail-with-body --silent --show-error --request POST --header @trakt-repair/auth.headers --data-binary @trakt-repair/remaining-remove-final.json --dump-header trakt-repair/remove-retry-response-headers.txt --output trakt-repair/remove-retry-response.json --write-out 'HTTP %{http_code}\n' https://api.trakt.tv/sync/history/remove
その後、さらに新しいスナップショットを取得して、同じ最終条件を検証します。削除の復旧作業で、追加処理を繰り返してはいけません。
python3 trakt_repair.py fetch final-2
python3 trakt_repair.py verify-final final-2
任意:元の記録を削除する前に、追加した Unknown を取り消す
この分岐を使うのは、元の視聴記録がすべて残っているうちに、追加処理を取り消して作業を放棄する場合だけです。処理中のリクエストが完了するのを待ち、ほかの書き込みは一時停止したままにします。補助ツールは、新しい視聴記録が選択した各映画につき最大 1 件の Unknown だけであり、元の履歴と評価がそのまま残っていることを確認する必要があります。受け入れた Watchlist からの削除は残る場合があります。これはアカウント全体を元に戻す処理ではありません。
python3 trakt_repair.py fetch undo-check
python3 trakt_repair.py prepare-undo-add undo-check
補助ツールが undo-add-undo-check.json を生成した場合にだけ、その内容を確認し、新たに追加した Unknown の履歴 ID だけが含まれ、元の ID は決して含まれていないことを確かめます。次のコマンドは、新たに追加した視聴記録を明示的に削除します。補助ツールが拒否した場合は、削除範囲を広げたリクエストを自作せず、ファイルを保管して原因を調べてください。
test ! -e trakt-repair/undo-add-response.json && test ! -e trakt-repair/undo-add-response-headers.txt && curl -q --fail-with-body --silent --show-error --request POST --header @trakt-repair/auth.headers --data-binary @trakt-repair/undo-add-undo-check.json --dump-header trakt-repair/undo-add-response-headers.txt --output trakt-repair/undo-add-response.json --write-out 'HTTP %{http_code}\n' https://api.trakt.tv/sync/history/remove
もう一度読み取り、元の映画の視聴履歴と評価が存在することを検証します。以前に受け入れた Watchlist からの削除があれば、別途確認してください。
python3 trakt_repair.py fetch undone
python3 trakt_repair.py verify-undo undone
放棄したバッチは、その時点で作業を終了したものとして扱ってください。古い add.json や remove.json を後から実行してはいけません。やり直す場合は、新しい空の作業フォルダーと新しい基準データが必要です。スナップショットから何が起きたか正確に確認できない場合は、残っている記録を保護し、削除する ID を推測するのではなく、機密情報を伏せた計画を使って支援を求めてください。
ローカル用補助ツールの全コード
次の段落のコマンド全体を、1 つの Bash コマンドとしてコピーしてください。これは読み取り可能なソースファイルを書き出すだけで、補助ツールの実行も Trakt への接続も行いません。その後 trakt_repair.py を開いて確認し、「補助ツールを配置し、完全な基準データを読み取る」に戻ってください。半角の引用符とバックスラッシュは変えず、このコマンドは翻訳しないでください。
python3 -c 'from pathlib import Path; import hashlib,sys; p=Path("trakt_repair.py"); source="#!/usr/bin/env python3\n\"\"\"Movie-history repair helper: local files and authenticated GET requests only.\n\nThis program NEVER sends POST, DELETE or PUT requests. Inspect its generated\nJSON, then use separate explicit curl commands. Python 3.10+; Bash examples.\nAPI response contracts were checked against the Trakt authors'"'"' published code.\nNo live account or device was used to test this helper. Pause other imports,\nscrobblers and history edits until the final check. Pagination is not atomic.\n\"\"\"\nimport argparse\nimport csv\nimport datetime as dt\nimport hashlib\nimport io\nimport json\nimport os\nfrom pathlib import Path\nimport re\nimport sys\nimport time\nimport urllib.error\nimport urllib.parse\nimport urllib.request\n\nROOT = Path(\"trakt-repair\")\nAPI = \"https://api.trakt.tv\"\nENDPOINTS = {\"history\": \"/users/me/history/movies\", \"ratings\": \"/users/me/ratings/movies\", \"watchlist\": \"/users/me/watchlist/movies/rank\"}\nEPOCH = dt.datetime(1970, 1, 1, tzinfo=dt.timezone.utc)\nLAST_GET = 0.0\n\n\ndef check(ok, why):\n if not ok:\n raise ValueError(why)\n\n\ndef sha(data):\n return hashlib.sha256(data).hexdigest()\n\n\ndef encoded(value):\n return (json.dumps(value, ensure_ascii=False, indent=2) + \"\\n\").encode(\"utf-8\")\n\n\ndef read_json(path):\n return json.loads(path.read_bytes())\n\n\ndef write_new(path, data):\n with path.open(\"xb\") as f:\n f.write(data)\n\n\ndef write_same(path, data):\n if path.exists():\n check(path.read_bytes() == data, \"Existing output differs; it will not be overwritten: \" + str(path))\n else:\n write_new(path, data)\n\n\ndef now():\n return dt.datetime.now(dt.timezone.utc).isoformat()\n\n\ndef number(v):\n return type(v) is int and 0 < v <= 9223372036854775807\n\n\ndef date(v):\n check(isinstance(v, str), \"Missing or non-string timestamp; null is not Unknown.\")\n d = dt.datetime.fromisoformat(v.replace(\"Z\", \"+00:00\"))\n check(d.tzinfo is not None, \"Timestamp has no timezone.\")\n return d.astimezone(dt.timezone.utc)\n\n\ndef mid(row):\n check(isinstance(row, dict) and row.get(\"type\") == \"movie\", \"Unexpected non-movie row.\")\n m = row.get(\"movie\")\n check(isinstance(m, dict) and isinstance(m.get(\"ids\"), dict), \"Missing/null movie: stop, do not skip it.\")\n i = m[\"ids\"].get(\"trakt\")\n check(number(i), \"Invalid Trakt movie ID.\")\n return i\n\n\ndef validate(kind, rows):\n check(isinstance(rows, list), \"Expected a JSON array.\")\n seen = set()\n for r in rows:\n movie = mid(r)\n if kind == \"history\":\n key = r.get(\"id\")\n check(number(key), \"Invalid history ID; require an exact positive int64.\")\n date(r.get(\"watched_at\"))\n check(isinstance(r.get(\"action\"), str) and bool(r[\"action\"]), \"Missing history action.\")\n else:\n key = movie\n if kind == \"ratings\":\n check(type(r.get(\"rating\")) is int and 1 <= r[\"rating\"] <= 10, \"Invalid rating.\")\n date(r.get(\"rated_at\"))\n elif kind == \"watchlist\":\n date(r.get(\"listed_at\"))\n else:\n raise ValueError(\"Unexpected dataset.\")\n check(key not in seen, \"Duplicate ID: incomplete or changing snapshot.\")\n seen.add(key)\n return rows\n\n\ndef signature(r):\n return (mid(r), date(r[\"watched_at\"]).replace(second=0, microsecond=0).isoformat(), r[\"action\"])\n\n\ndef hist(rows):\n return {r[\"id\"]: signature(r) for r in rows}\n\n\ndef ratings(rows):\n return {mid(r): (r[\"rating\"], date(r[\"rated_at\"]).isoformat()) for r in rows}\n\n\ndef watchlist(rows):\n return {mid(r) for r in rows}\n\n\ndef label(value):\n check(bool(re.fullmatch(r\"[a-z][a-z0-9_-]{0,40}\", value)), \"Use a short lowercase snapshot name, for example before or after-add.\")\n return value\n\n\ndef parse_headers(raw):\n text = raw.decode(\"ascii\")\n check(\"\\r\" not in text.replace(\"\\r\\n\", \"\"), \"Use LF or CRLF header lines, not a bare carriage return.\")\n lines = text.replace(\"\\r\\n\", \"\\n\").split(\"\\n\")\n if lines and lines[-1] == \"\":\n lines.pop()\n check(lines and all(lines), \"Empty header lines are not accepted.\")\n headers = {}\n for line in lines:\n check(not any(ord(c) < 32 or ord(c) == 127 for c in line), \"Folded lines and control characters are not accepted.\")\n name, separator, value = line.partition(\":\")\n check(separator and re.fullmatch(r\"[A-Za-z0-9-]+\", name), \"Malformed local header file; use one complete header per line.\")\n key = name.lower()\n check(key not in headers, \"Duplicate header name in local file.\")\n value = value.strip(\" \")\n check(value and not any(ord(c) < 32 or ord(c) == 127 for c in value), \"Header values must be nonempty and contain no control characters.\")\n headers[key] = value\n check(set(headers) == {\"authorization\", \"trakt-api-key\", \"trakt-api-version\", \"content-type\", \"user-agent\"}, \"The local file must contain exactly the five header names listed in this guide and Trakt'"'"'s authentication reference.\")\n check(headers[\"trakt-api-version\"] == \"2\", \"The API version header must be 2.\")\n # The reader prepares all values using the official authentication reference.\n # This helper does not create, infer, inspect a scheme, or refresh credentials.\n return headers\n\n\ndef auth():\n raw = (ROOT / \"auth.headers\").read_bytes()\n return parse_headers(raw), sha(raw)\n\n\ndef init(headers_file):\n raw = Path(headers_file).expanduser().read_bytes()\n parse_headers(raw)\n ROOT.mkdir(exist_ok=True, mode=0o700)\n check(not (ROOT / \"auth.headers\").exists(), \"Credentials already exist; do not change accounts within a repair batch.\")\n ROOT.chmod(0o700)\n write_new(ROOT / \"auth.headers\", raw)\n (ROOT / \"auth.headers\").chmod(0o600)\n print(\"Imported your existing complete header file byte-for-byte into a private local working directory. No authentication value was created or displayed. Keep both local copies private; do not share this directory.\")\n\n\ndef get(path, headers):\n global LAST_GET\n delay = 0.65 - (time.monotonic() - LAST_GET)\n if delay > 0:\n time.sleep(delay)\n LAST_GET = time.monotonic()\n request = urllib.request.Request(API + path, headers=headers, method=\"GET\")\n # No retry and no redirect: do not forward credentials to another location.\n class NoRedirect(urllib.request.HTTPRedirectHandler):\n def redirect_request(self, req, fp, code, msg, response_headers, newurl):\n return None\n try:\n with urllib.request.build_opener(NoRedirect).open(request, timeout=45) as response:\n check(response.status == 200, \"GET did not return HTTP 200.\")\n return response.read(), {k.lower(): v for k, v in response.headers.items()}\n except urllib.error.HTTPError as exc:\n body = exc.read()\n public_headers = {k.lower(): v for k, v in exc.headers.items() if k.lower() in (\"retry-after\", \"date\", \"content-type\", \"x-request-id\") or k.lower().startswith(\"x-ratelimit\")}\n stem = \"get-error-\" + dt.datetime.now(dt.timezone.utc).strftime(\"%Y%m%dT%H%M%S%fZ\")\n write_new(ROOT / (stem + \"-body.bin\"), body)\n write_new(ROOT / (stem + \".json\"), encoded({\"method\": \"GET\", \"path\": path, \"status\": exc.code, \"response_headers\": public_headers, \"response_body\": stem + \"-body.bin\"}))\n retry = public_headers.get(\"retry-after\", \"not supplied\")\n raise ValueError(\"GET HTTP \" + str(exc.code) + \"; Retry-After: \" + retry + \". Saved response metadata/body at \" + str(ROOT / stem) + \". Snapshot stays INCOMPLETE. No automatic retry.\") from None\n\n\ndef page_meta(headers, page):\n keys = (\"page\", \"page-count\", \"item-count\", \"limit\")\n check(all(\"x-pagination-\" + k in headers for k in keys), \"Pagination headers missing: completeness is unproved, so stop.\")\n d = {k: int(headers[\"x-pagination-\" + k]) for k in keys}\n check(d[\"page\"] == page and d[\"limit\"] > 0 and d[\"item-count\"] >= 0, \"Invalid pagination metadata.\")\n if d[\"item-count\"] == 0:\n check(d[\"page-count\"] in (0, 1) and page == 1, \"Invalid empty-list pagination.\")\n else:\n check(d[\"page-count\"] == (d[\"item-count\"] + d[\"limit\"] - 1) // d[\"limit\"], \"Inconsistent page count.\")\n return d\n\n\ndef collect(kind, endpoint, destination, headers, fetcher=get):\n rawdir = destination / (kind + \"-raw\")\n rawdir.mkdir()\n all_rows, pages, stamp, first = [], [], None, None\n p, limit = 1, 100\n while True:\n path = endpoint + \"?\" + urllib.parse.urlencode({\"page\": p, \"limit\": limit})\n body, response_headers = fetcher(path, headers)\n name = \"page-%04d.json\" % p\n write_new(rawdir / name, body)\n meta = page_meta(response_headers, p)\n current = (meta[\"page-count\"], meta[\"item-count\"], meta[\"limit\"])\n stamp = current if stamp is None else stamp\n check(stamp == current, \"Dataset changed during pagination.\")\n rows = validate(kind, json.loads(body))\n count = max(0, min(meta[\"limit\"], meta[\"item-count\"] - (p - 1) * meta[\"limit\"]))\n check(len(rows) == count, \"Short page: the snapshot is incomplete.\")\n first = rows if first is None else first\n all_rows.extend(rows)\n pages.append({\"file\": name, \"sha256\": sha(body), \"pagination\": meta})\n if p >= max(1, meta[\"page-count\"]):\n break\n p, limit = p + 1, meta[\"limit\"]\n validate(kind, all_rows)\n check(len(all_rows) == stamp[1], \"Wrong total row count.\")\n body, response_headers = fetcher(endpoint + \"?\" + urllib.parse.urlencode({\"page\": 1, \"limit\": stamp[2]}), headers)\n write_new(rawdir / \"first-page-recheck.json\", body)\n final_meta = page_meta(response_headers, 1)\n check(tuple(final_meta[k] for k in (\"page-count\", \"item-count\", \"limit\")) == stamp and validate(kind, json.loads(body)) == first, \"First page or pagination changed: pause other writers and fetch again using a NEW snapshot name.\")\n data = encoded(all_rows)\n write_new(destination / (kind + \".json\"), data)\n return {\"endpoint\": endpoint, \"total\": len(all_rows), \"pages\": pages, \"first_page_recheck_sha256\": sha(body), \"sha256\": sha(data)}\n\n\ndef fetch(name):\n name = label(name)\n headers, auth_hash = auth()\n destination = ROOT / name\n destination.mkdir()\n write_new(destination / \"INCOMPLETE\", b\"Do not use this snapshot until manifest.json is complete.\\n\")\n manifest = {\"version\": 1, \"started_at\": now(), \"auth_sha256\": auth_hash, \"datasets\": {}}\n for kind, endpoint in ENDPOINTS.items():\n print(\"Fetching \" + kind + \"...\")\n manifest[\"datasets\"][kind] = collect(kind, endpoint, destination, headers)\n manifest.update({\"finished_at\": now(), \"complete\": True})\n write_new(destination / \"manifest.json\", encoded(manifest))\n (destination / \"INCOMPLETE\").unlink()\n print(\"Complete read-only snapshot: \" + str(destination) + \". Raw JSON and pagination metadata retained.\")\n\n\ndef snapshot(name):\n destination = ROOT / label(name)\n check(not (destination / \"INCOMPLETE\").exists(), \"Incomplete snapshot; no plan may use it.\")\n manifest_path = destination / \"manifest.json\"\n manifest = read_json(manifest_path)\n check(manifest.get(\"complete\") is True and manifest.get(\"version\") == 1, \"Invalid snapshot manifest.\")\n check(manifest[\"auth_sha256\"] == auth()[1], \"Credentials changed since this snapshot; use one account/token per batch.\")\n result = {\"name\": name, \"manifest_sha256\": sha(manifest_path.read_bytes())}\n for kind, endpoint in ENDPOINTS.items():\n metadata = manifest[\"datasets\"][kind]\n check(metadata[\"endpoint\"] == endpoint, \"Wrong source endpoint.\")\n body = (destination / (kind + \".json\")).read_bytes()\n check(sha(body) == metadata[\"sha256\"], \"Snapshot file was changed.\")\n rows = validate(kind, json.loads(body))\n check(len(rows) == metadata[\"total\"], \"Snapshot row count mismatch.\")\n raw_rows = []\n for page in metadata[\"pages\"]:\n raw = (destination / (kind + \"-raw\") / page[\"file\"]).read_bytes()\n check(sha(raw) == page[\"sha256\"], \"Raw page was changed.\")\n raw_rows.extend(json.loads(raw))\n check(raw_rows == rows, \"Combined snapshot differs from raw responses.\")\n raw = (destination / (kind + \"-raw\") / \"first-page-recheck.json\").read_bytes()\n check(sha(raw) == metadata[\"first_page_recheck_sha256\"], \"Raw recheck was changed.\")\n result[kind] = rows\n return result\n\n\ndef preview(name):\n s = snapshot(name)\n check(s[\"history\"], \"No movie history to repair.\")\n out = io.StringIO(newline=\"\")\n writer = csv.writer(out)\n writer.writerow([\"choose\", \"history_id\", \"movie_id\", \"title\", \"year\", \"watched_at\", \"unknown\"])\n for r in s[\"history\"]:\n m = r[\"movie\"]\n writer.writerow([\"\", \"h:\" + str(r[\"id\"]), \"m:\" + str(mid(r)), \"t:\" + str(m.get(\"title\", \"\")), m.get(\"year\"), \"at:\" + r[\"watched_at\"], \"YES\" if date(r[\"watched_at\"]) == EPOCH else \"NO\"])\n path = ROOT / (name + \"-review.csv\")\n write_new(path, (\"\\ufeff\" + out.getvalue()).encode(\"utf-8\"))\n print(\"Review \" + str(path) + \". Put exact YES only in choose for plays you personally identify as false dates. Leave all other cells unchanged. h:, m:, t:, at: keep spreadsheet cells as text.\")\n\n\ndef select(s, path):\n raw = path.read_bytes()\n choices = list(csv.DictReader(io.StringIO(raw.decode(\"utf-8-sig\"))))\n check(choices and all(c.get(\"choose\") in (\"\", \"YES\") for c in choices), \"choose must be blank or exact YES.\")\n by_id = {\"h:\" + str(r[\"id\"]): r for r in s[\"history\"]}\n unknown = {mid(r) for r in s[\"history\"] if date(r[\"watched_at\"]) == EPOCH}\n selected = []\n for c in choices:\n if c[\"choose\"] != \"YES\":\n continue\n r = by_id.get(c.get(\"history_id\"))\n check(r is not None, \"Selected history ID is missing or changed; retain h:.\")\n check(c.get(\"movie_id\") == \"m:\" + str(mid(r)), \"Movie/history mismatch; retain m:.\")\n check(c.get(\"title\") == \"t:\" + str(r[\"movie\"].get(\"title\", \"\")) and c.get(\"watched_at\") == \"at:\" + r[\"watched_at\"], \"Selected title/date cell was changed; recheck the CSV.\")\n check(mid(r) not in unknown, \"Selected movie already has an Unknown play; this workflow stops.\")\n selected.append(r)\n check(selected and len({mid(r) for r in selected}) == len(selected), \"Select exactly one false play per selected movie, and at least one movie.\")\n return selected, sha(raw)\n\n\ndef plan(name, review):\n check(not (ROOT / \"plan.json\").exists() and not (ROOT / \"add.json\").exists(), \"This working directory already has a plan; do not overwrite a repair batch.\")\n s = snapshot(name)\n selected, selection_hash = select(s, Path(review))\n for r in selected:\n print(json.dumps({\"history_id\": \"h:\" + str(r[\"id\"]), \"movie_id\": \"m:\" + str(mid(r)), \"title\": r[\"movie\"].get(\"title\"), \"old_date\": r[\"watched_at\"], \"new_date\": \"Unknown\"}, ensure_ascii=False))\n affected = watchlist(s[\"watchlist\"]) & {mid(r) for r in selected}\n accepted = False\n if affected:\n print(\"These selected movie IDs are on your Watchlist and marking watched may remove them: \" + \", \".join(\"m:\" + str(i) for i in sorted(affected)))\n check(input(\"Accept those Watchlist removals? Type YES, REMOVE FROM WATCHLIST: \") == \"YES, REMOVE FROM WATCHLIST\", \"Watchlist removal not accepted; no plan written.\")\n accepted = True\n check(input(\"Confirm only the selected false-date plays above. Type YES: \") == \"YES\", \"No plan written.\")\n review_bytes = Path(review).read_bytes()\n check(sha(review_bytes) == selection_hash, \"The selected CSV changed during confirmation; no plan written.\")\n addition = {\"movies\": [{\"ids\": {\"trakt\": mid(r)}, \"watched_at\": \"unknown\"} for r in selected]}\n p = {\"version\": 1, \"created_at\": now(), \"before\": name, \"before_manifest_sha256\": s[\"manifest_sha256\"], \"auth_sha256\": auth()[1], \"selection_sha256\": selection_hash, \"selected_history_ids\": [r[\"id\"] for r in selected], \"watchlist_accepted\": accepted, \"add_sha256\": sha(encoded(addition))}\n write_new(ROOT / \"selected-review.csv\", review_bytes)\n write_new(ROOT / \"plan.json\", encoded(p))\n write_new(ROOT / \"add.json\", encoded(addition))\n print(\"Created plan.json and add.json. No API change made. No old-play removal file exists yet. Inspect both files before the separate ADD request.\")\n\n\ndef load_plan():\n p = read_json(ROOT / \"plan.json\")\n check(p.get(\"version\") == 1 and p[\"auth_sha256\"] == auth()[1], \"Plan/authentication mismatch.\")\n s = snapshot(p[\"before\"])\n check(p[\"before_manifest_sha256\"] == s[\"manifest_sha256\"], \"The plan'"'"'s baseline was changed.\")\n by_id = {r[\"id\"]: r for r in s[\"history\"]}\n ids = p[\"selected_history_ids\"]\n check(isinstance(ids, list) and ids and all(number(i) and i in by_id for i in ids), \"Invalid selected history IDs.\")\n selected = [by_id[i] for i in ids]\n saved_selection = ROOT / \"selected-review.csv\"\n check(sha(saved_selection.read_bytes()) == p[\"selection_sha256\"], \"Saved selected CSV changed.\")\n selected_again, selection_hash = select(s, saved_selection)\n check([r[\"id\"] for r in selected_again] == ids, \"Plan history IDs differ from the exact saved CSV selection.\")\n wanted = {mid(r) for r in selected}\n check(len(wanted) == len(selected), \"More than one selected play per movie.\")\n check(not any(mid(r) in wanted and date(r[\"watched_at\"]) == EPOCH for r in s[\"history\"]), \"Baseline contains a preexisting Unknown for a selected movie.\")\n check(not watchlist(s[\"watchlist\"]) & wanted or p[\"watchlist_accepted\"] is True, \"Watchlist acceptance is absent.\")\n addition = {\"movies\": [{\"ids\": {\"trakt\": mid(r)}, \"watched_at\": \"unknown\"} for r in selected]}\n check(sha((ROOT / \"add.json\").read_bytes()) == p[\"add_sha256\"] == sha(encoded(addition)), \"ADD request differs from the bound plan.\")\n return p, s, selected, sha((ROOT / \"plan.json\").read_bytes())\n\n\ndef common(before, current, wanted, accepted):\n check(ratings(before[\"ratings\"]) == ratings(current[\"ratings\"]), \"Movie ratings or rating timestamps changed; stop.\")\n old_w, new_w = watchlist(before[\"watchlist\"]), watchlist(current[\"watchlist\"])\n allowed = old_w & wanted if accepted else set()\n check(new_w <= old_w and old_w - new_w <= allowed, \"Unexpected movie Watchlist membership change; stop.\")\n\n\ndef added_state(p, before, selected, current):\n check(current[\"name\"] != before[\"name\"], \"Use a NEW snapshot taken after the ADD request.\")\n old, new = hist(before[\"history\"]), hist(current[\"history\"])\n wanted = {mid(r) for r in selected}\n check(set(old) <= set(new) and all(new[i] == old[i] for i in old), \"An original play is missing or changed; no removal request generated.\")\n common(before, current, wanted, p[\"watchlist_accepted\"])\n added = [r for r in current[\"history\"] if r[\"id\"] not in old]\n added_m = {mid(r) for r in added}\n check(added_m <= wanted and len(added_m) == len(added) and all(date(r[\"watched_at\"]) == EPOCH for r in added), \"Unexpected new plays or duplicate Unknowns; no removal request generated.\")\n return added, wanted\n\n\ndef verify_add(name):\n p, before, selected, plan_hash = load_plan()\n current = snapshot(name)\n added, wanted = added_state(p, before, selected, current)\n added_m = {mid(r) for r in added}\n if added_m != wanted:\n report = {\"plan_sha256\": plan_hash, \"snapshot\": name, \"snapshot_manifest_sha256\": current[\"manifest_sha256\"], \"new_unknown_ids\": [r[\"id\"] for r in added], \"missing_movie_ids\": sorted(wanted - added_m)}\n write_new(ROOT / (\"add-incomplete-\" + name + \".json\"), encoded(report))\n raise ValueError(\"ADD is only partly observed (or no new play is observed). Original plays remain. Do NOT resend ADD and do NOT remove originals. Keep this report; fetch a later NEW snapshot and re-run verify-add. To abandon the attempt after requests have settled, use prepare-undo-add on a fresh snapshot. Watchlist removals are not restored by undoing new plays.\")\n removal = {\"ids\": [r[\"id\"] for r in selected]}\n certificate = {\"plan_sha256\": plan_hash, \"after_add\": name, \"after_add_manifest_sha256\": current[\"manifest_sha256\"], \"unknown_plays\": added, \"remove_sha256\": sha(encoded(removal))}\n certificate_path = ROOT / \"add-verified.json\"\n if certificate_path.exists():\n saved = read_json(certificate_path)\n check(all(saved.get(k) == v for k, v in certificate.items()), \"Existing ADD certificate belongs to different evidence; do not overwrite it.\")\n else:\n check(not (ROOT / \"remove.json\").exists(), \"An unbound REMOVE file already exists; stop.\")\n certificate[\"verified_at\"] = now()\n write_new(certificate_path, encoded(certificate))\n write_same(ROOT / \"remove.json\", encoded(removal))\n print(\"ADD verified: every original play remains unchanged to its movie/date-minute/action, ratings are unchanged, and each target has exactly one new Unknown. Created remove.json containing only selected ORIGINAL history IDs. Inspect it before the separate REMOVE request.\")\n\n\ndef verify_final(name):\n p, before, selected, plan_hash = load_plan()\n certificate = read_json(ROOT / \"add-verified.json\")\n check(certificate[\"plan_sha256\"] == plan_hash, \"ADD verification is bound to a different plan.\")\n after_add = snapshot(certificate[\"after_add\"])\n check(certificate[\"after_add_manifest_sha256\"] == after_add[\"manifest_sha256\"], \"Verified ADD snapshot changed.\")\n actual_added, wanted = added_state(p, before, selected, after_add)\n check({mid(r) for r in actual_added} == wanted and certificate[\"unknown_plays\"] == actual_added, \"ADD certificate does not match the bound raw snapshot.\")\n removal = {\"ids\": [r[\"id\"] for r in selected]}\n check(sha((ROOT / \"remove.json\").read_bytes()) == certificate[\"remove_sha256\"] == sha(encoded(removal)), \"REMOVE request changed.\")\n current = snapshot(name)\n check(name not in (before[\"name\"], after_add[\"name\"]), \"Use a NEW snapshot taken after the REMOVE request.\")\n removed = {r[\"id\"] for r in selected}\n unknown = certificate[\"unknown_plays\"]\n validate(\"history\", unknown)\n expected = {i: sig for i, sig in hist(before[\"history\"]).items() if i not in removed}\n expected.update(hist(unknown))\n actual = hist(current[\"history\"])\n allowed_originals = {r[\"id\"]: signature(r) for r in selected}\n check(set(expected) <= set(actual) and all(actual[i] == expected[i] for i in expected), \"A retained or newly verified play is missing/changed; stop.\")\n remaining = set(actual) - set(expected)\n check(remaining <= removed and all(actual[i] == allowed_originals[i] for i in remaining), \"Unexpected final history change; stop.\")\n check(ratings(before[\"ratings\"]) == ratings(current[\"ratings\"]), \"Movie ratings or rating timestamps changed; stop.\")\n check(watchlist(after_add[\"watchlist\"]) == watchlist(current[\"watchlist\"]), \"Movie Watchlist membership changed during removal; stop.\")\n if remaining:\n path = ROOT / (\"remaining-remove-\" + name + \".json\")\n write_new(path, encoded({\"ids\": sorted(remaining)}))\n raise ValueError(\"REMOVE is incomplete. Fresh snapshot confirms only these selected original IDs remain; \" + str(path) + \" contains ONLY those IDs. Inspect it before any explicit retry of REMOVE; never resend ADD. Then fetch and verify a NEW final snapshot.\")\n report = {\"plan_sha256\": plan_hash, \"final_snapshot\": name, \"final_manifest_sha256\": current[\"manifest_sha256\"], \"verified_at\": now(), \"condition\": \"H0 minus S plus verified U; movie ratings unchanged; Watchlist membership unchanged since verified ADD\"}\n write_new(ROOT / (\"final-verified-\" + name + \".json\"), encoded(report))\n print(\"FINAL VERIFIED: original history minus only selected false-date plays plus their verified Unknown replacements. Existing real rewatches retained; movie ratings unchanged. Watchlist acceptance, if any, still applies.\")\n\n\ndef prepare_undo(name):\n p, before, selected, plan_hash = load_plan()\n current = snapshot(name)\n added, wanted = added_state(p, before, selected, current)\n check(added, \"No new Unknown plays observed to undo. Do not issue an empty removal request.\")\n payload = {\"ids\": [r[\"id\"] for r in added]}\n path = ROOT / (\"undo-add-\" + name + \".json\")\n write_new(path, encoded(payload))\n report = {\"plan_sha256\": plan_hash, \"snapshot\": name, \"snapshot_manifest_sha256\": current[\"manifest_sha256\"], \"payload_sha256\": sha(encoded(payload)), \"new_unknown_ids\": payload[\"ids\"]}\n write_new(ROOT / (\"undo-plan-\" + name + \".json\"), encoded(report))\n print(\"Optional abandonment request: \" + str(path) + \" removes ONLY new Unknown plays verified against the baseline. All original plays still exist. Inspect it, then use a separate explicit REMOVE request. This does not restore removed Watchlist membership. Afterward fetch a NEW snapshot and run verify-undo.\")\n\n\ndef verify_undo(name):\n p, before, selected, plan_hash = load_plan()\n current = snapshot(name)\n check(name != before[\"name\"], \"Use a NEW snapshot after the undo request.\")\n check(hist(before[\"history\"]) == hist(current[\"history\"]), \"History is not restored to the original IDs/movie/date-minute/action; stop.\")\n common(before, current, {mid(r) for r in selected}, p[\"watchlist_accepted\"])\n report = {\"plan_sha256\": plan_hash, \"snapshot\": name, \"snapshot_manifest_sha256\": current[\"manifest_sha256\"], \"verified_at\": now(), \"condition\": \"Original movie history and ratings restored; accepted Watchlist removals may remain\"}\n write_new(ROOT / (\"undo-verified-\" + name + \".json\"), encoded(report))\n print(\"UNDO VERIFIED: original movie history and ratings are present. Accepted Watchlist removals may remain. Abandon this batch; do not run its old add.json or remove.json. Use a fresh working directory for any later attempt.\")\n\n\ndef main():\n os.umask(0o077)\n parser = argparse.ArgumentParser(description=__doc__)\n sub = parser.add_subparsers(dest=\"command\", required=True)\n sub.add_parser(\"init\").add_argument(\"headers_file\")\n for command in (\"fetch\", \"preview\", \"verify-add\", \"verify-final\", \"prepare-undo-add\", \"verify-undo\"):\n sub.add_parser(command).add_argument(\"snapshot\")\n p = sub.add_parser(\"plan\")\n p.add_argument(\"snapshot\")\n p.add_argument(\"review_csv\")\n args = parser.parse_args()\n try:\n if args.command == \"init\":\n init(args.headers_file)\n elif args.command == \"fetch\":\n fetch(args.snapshot)\n elif args.command == \"preview\":\n preview(args.snapshot)\n elif args.command == \"plan\":\n plan(args.snapshot, args.review_csv)\n elif args.command == \"verify-add\":\n verify_add(args.snapshot)\n elif args.command == \"verify-final\":\n verify_final(args.snapshot)\n elif args.command == \"prepare-undo-add\":\n prepare_undo(args.snapshot)\n elif args.command == \"verify-undo\":\n verify_undo(args.snapshot)\n except (ValueError, KeyError, TypeError, OSError, csv.Error, urllib.error.HTTPError, urllib.error.URLError) as exc:\n print(\"STOP: \" + str(exc) + \"\\nNo mutation request was sent by this helper. Preserve existing files; do not overwrite snapshots or blindly repeat a POST.\", file=sys.stderr)\n raise SystemExit(2)\n\n\nif __name__ == \"__main__\":\n main()\n"; p.open("x",encoding="utf-8",newline="").write(source); hashlib.sha256(p.read_bytes()).hexdigest()=='"'"'21c8f1a918bd1b8d818476f57b2f7cab9ccfa56504da40fc1c586325d8aa2ded'"'"' or sys.exit("STOP: source SHA mismatch"); print("Complete source written locally. SHA-256: 21c8f1a918bd1b8d818476f57b2f7cab9ccfa56504da40fc1c586325d8aa2ded. Open and inspect trakt_repair.py before running it. No API request made.")'
ソースを書き出すコマンドは、作成したファイルの SHA-256 を表示します。この版で確認済みのソースの SHA-256 は 21c8f1a918bd1b8d818476f57b2f7cab9ccfa56504da40fc1c586325d8aa2ded です。表示された値が異なる場合は停止し、新しい空の作業フォルダーにコマンド全体をコピーし直してください。