Tecnología · GUÍA PRÁCTICA
Corrige fechas de visionado erróneas en películas importadas a Trakt
Conserva las películas marcadas como vistas y sustituye las fechas falsas seleccionadas por Unknown (fecha desconocida). Comprueba primero si puedes deshacer la importación exacta; si no, revisa cada visionado y verifica la sustitución antes de eliminar el registro anterior.
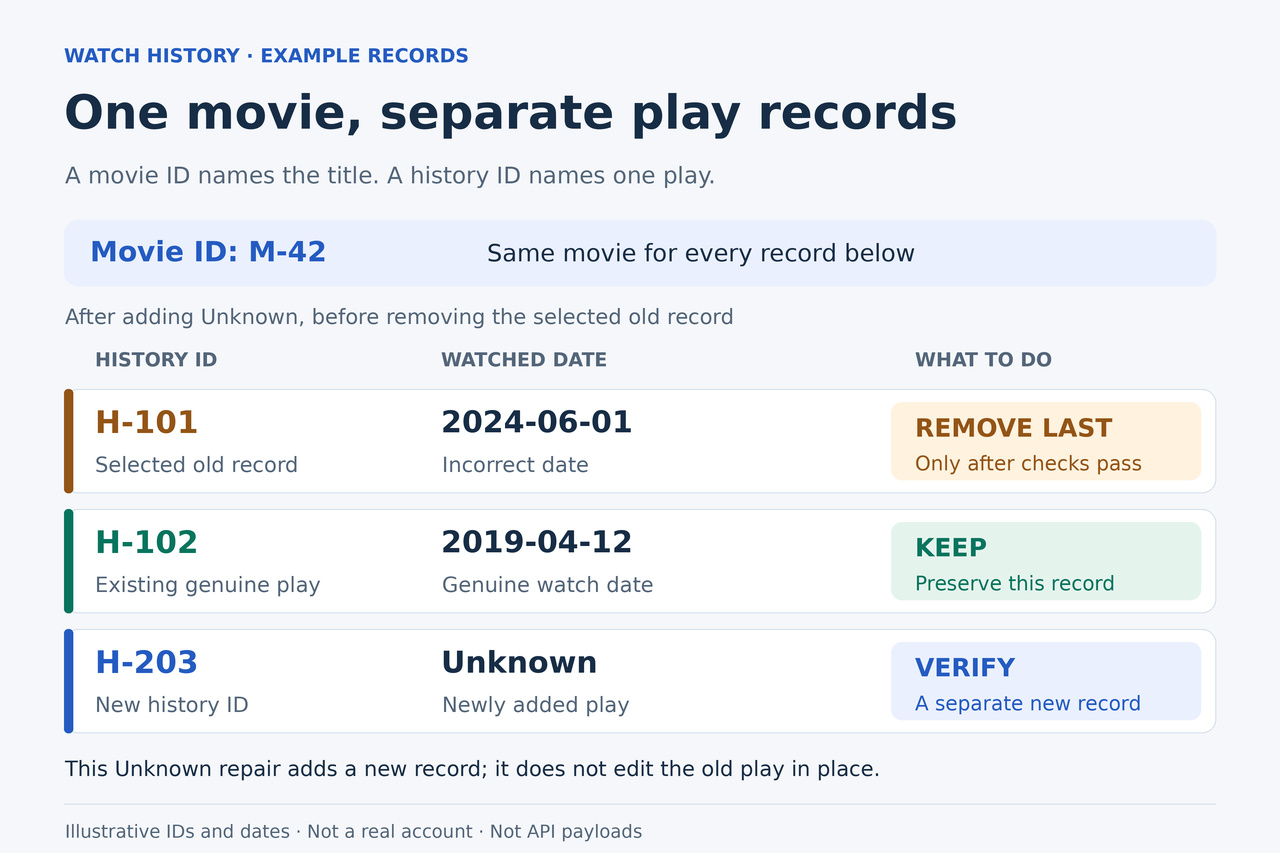
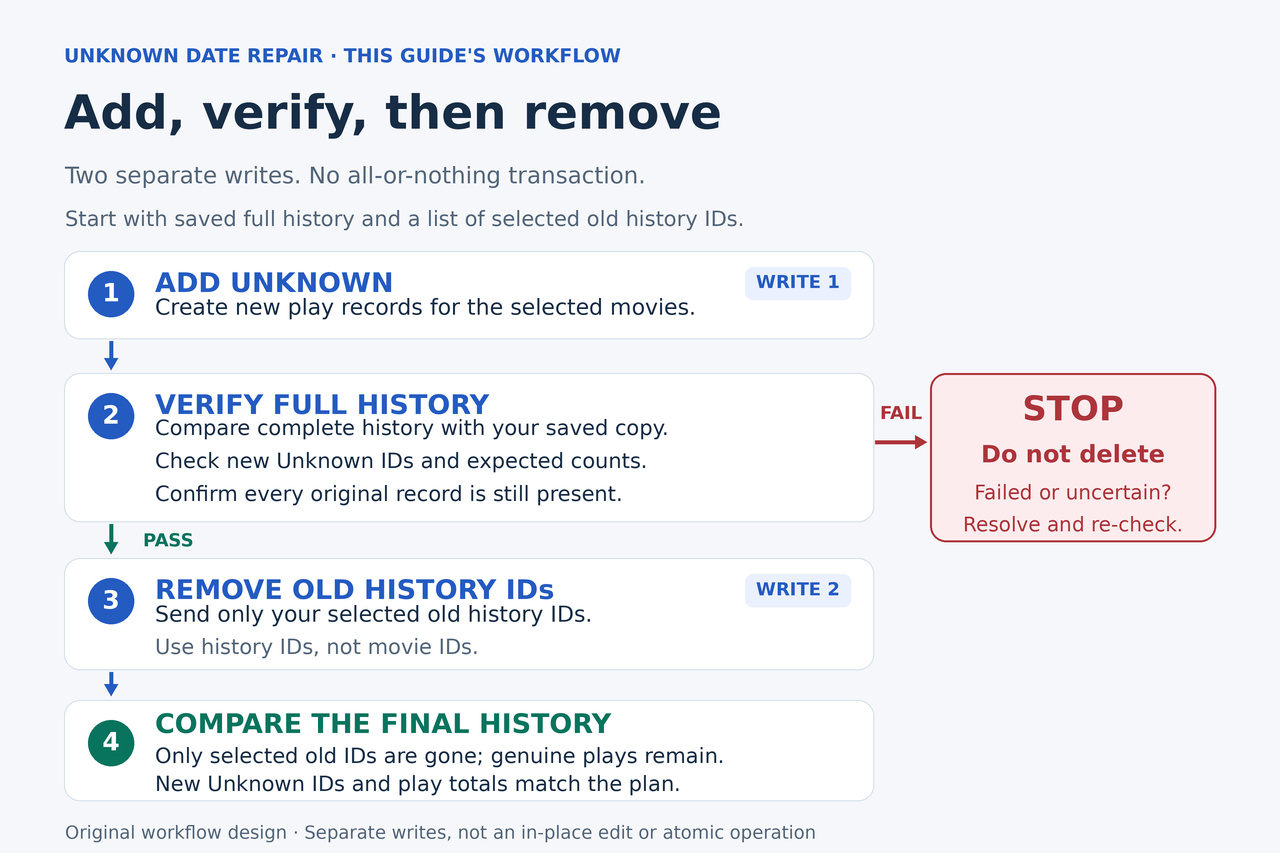
Si una antigua importación de IMDb o Letterboxd hizo que pareciera que viste todas las películas el mismo día, la fecha Unknown («desconocida») de Trakt permite conservar el hecho de que las has visto sin inventar una fecha de visionado. Los visionados con fecha Unknown cuentan para el total de visionados, pero se excluyen de las estadísticas basadas en fechas. Añadir Unknown por sí solo no elimina el visionado anterior con la fecha falsa.
Comprueba primero si existe una opción para deshacer la importación no deseada que permita identificarla con exactitud. Para una corrección selectiva, esta guía incluye una herramienta local completa en Python: seleccionas los visionados con fechas falsas, añades sus sustitutos con fecha Unknown, verificas el resultado y solo entonces eliminas los history IDs originales seleccionados. La herramienta lee datos y prepara archivos; los dos cambios en la cuenta son comandos independientes que debes revisar y ejecutar tú.
Determina qué fechas son realmente falsas
Conserva la importación original junto con una copia de seguridad reciente de Trakt. Un grupo de fechas puede ayudarte a identificar posibles errores, pero no demuestra que todos los visionados de ese día sean incorrectos. Comprueba la película, el registro de origen y lo que recuerdas. Excluye de la corrección los visionados reales de ese mismo día.
Letterboxd distingue entre marcar una película como vista en algún momento y registrar un visionado concreto en el Diario (Diary). La columna Date de un archivo de origen no es necesariamente una fecha de visionado. Conserva una fecha fiable del diario para una corrección con fecha; este lote está destinado específicamente a visionados cuya fecha real se desconoce.
Selecciona como máximo un visionado con fecha falsa por película en cada plan. Conserva los visionados repetidos con fechas correctas. Si una película seleccionada ya tiene un visionado con fecha Unknown, detente y determina qué representan los registros. Esta herramienta no fusiona esos registros ni promete representar por separado varios visionados repetidos sin fecha.
Comprueba si puedes deshacer la importación exacta
Trakt documenta GET /users/syncs/import para enumerar las sincronizaciones de importación, GET /users/syncs/ID para consultar una y DELETE /users/syncs/ID para deshacerla. Un sync ID identifica una operación de importación; no es ni un movie ID ni un history ID. Lee todas las páginas devueltas cuando busques una importación antigua.
Usa esta alternativa solo si el registro identifica de forma fiable la importación no deseada y quieres revertirla por completo. Deshacerla puede revertir el historial, las valoraciones, los elementos en pausa, la Watchlist (lista de pendientes) y la colección importados. Que coincida el día o que el recuento sea parecido no basta para identificarla. Si el registro disponible no permite identificar el lote, déjalo intacto y usa el procedimiento selectivo.
No des por hecho que toda importación antigua de un archivo tenga un registro de sincronización identificable o un botón para deshacerla en tu interfaz actual. Si deshaces un lote verificado, vuelve a leer los resultados, prepara los datos corregidos a partir del origen, revisa la vista previa de las coincidencias y de los tipos de datos seleccionados, y verifica la nueva importación. Cualquier plan selectivo posterior debe partir de una instantánea inicial nueva tomada después de deshacer la importación.
Prepara el acceso, las copias de seguridad y una carpeta de trabajo privada
Usa Bash con Python 3.10 o posterior y curl 7.76.0 o posterior. Obtén acceso mediante tu propia aplicación de Trakt cuyo uso esté permitido y autoriza tu propia cuenta siguiendo las instrucciones oficiales vigentes enlazadas más abajo. Para registrar una aplicación se necesita una conexión verificada con GitHub y un cupo disponible para una aplicación; se aplican los límites reales de la cuenta y de aprobación. Este artículo no presupone una cuota gratuita fija ni un requisito universal de suscripción VIP.
Antes de usar la herramienta, prepara un archivo local de cabeceras de solicitud siguiendo la documentación de Trakt sobre cabeceras obligatorias y OAuth. Debe contener los campos Authorization, trakt-api-key, trakt-api-version, Content-Type y User-Agent, uno por línea; usa la versión 2 de la API y el tipo de contenido JSON. Usa tus propios valores autorizados, mantén el archivo privado y no pegues su contenido en este sitio web. La herramienta importa ese archivo existente; no registra una aplicación ni genera una autorización por ti.
El servidor actual de OAuth es auth.trakt.tv; los comandos de datos que aparecen a continuación usan api.trakt.tv. Si utilizas la autorización de dispositivos, respeta el intervalo de consulta y el plazo de caducidad que se devuelvan. Conserva el mismo archivo de credenciales válido durante todo el lote: las instantáneas guardadas están vinculadas a él. Si el acceso caduca o el archivo cambia a mitad del proceso, detente y conserva los archivos del lote; esta herramienta no migra un lote parcialmente completado a credenciales nuevas.
Exporta tu cuenta antes de realizar cambios. En el ZIP de JSON actual, los visionados individuales se encuentran en watched-history.json o en archivos numerados watched-history-N.json. El archivo watched-movies.json contiene datos agregados. Revisa el resultado de la exportación y _errors.json, si existe; un ZIP descargado puede estar incompleto. Resuelve los fallos que afecten a la información que necesitas antes de considerarlo una copia de seguridad utilizable.
Pausa las herramientas de scrobbling y las importaciones automáticas, y evita otros cambios en el historial, las valoraciones o la Watchlist hasta que termine la verificación. Crea una carpeta local nueva y vacía para este lote y abre Bash en ella. Guarda la exportación oficial por separado. La paginación no proporciona una instantánea atómica de la cuenta; pausar otros procesos que realizan cambios y comprobar todas las páginas reduce los errores, pero no convierte la API en una transacción atómica.
Instala la herramienta y lee una instantánea inicial completa
La sección Herramienta local completa, al final, contiene un comando completo que escribe el código fuente. Copia ese comando entero en Bash dentro de tu carpeta de trabajo vacía. Crea trakt_repair.py localmente, no realiza ninguna solicitud a la API y se niega a sobrescribir un archivo existente. Abre el archivo Python legible que se haya creado antes de ejecutarlo. Sus comentarios, mensajes y comandos permanecen en inglés en todas las ediciones del artículo.
Inicializa la herramienta con el archivo privado de cabeceras que preparaste siguiendo las instrucciones oficiales. Sustituye la ruta de ejemplo de este comando por la ruta local real; ponla entre comillas si contiene espacios. Ejecuta todos los comandos posteriores desde esta misma carpeta de trabajo. Las credenciales importadas y los datos de trabajo se guardan como archivos privados dentro de trakt-repair.
python3 trakt_repair.py init trakt-headers.txt
Lee la instantánea inicial. Este comando solo realiza solicitudes GET autenticadas para consultar el historial de películas, las valoraciones de películas y la Watchlist de películas. Conserva los bytes originales de las respuestas, los metadatos de paginación y los archivos JSON completos con los datos combinados.
python3 trakt_repair.py fetch before
Continúa solo cuando se indique que la instantánea está completa. La herramienta de recopilación usa el número de páginas devuelto, el límite efectivo y el número de elementos, y después vuelve a comprobar la primera página. Si falta información de paginación, una página contiene menos elementos de los esperados, hay IDs duplicados, un objeto de película tiene una estructura inesperada o se observa un cambio, la instantánea queda inutilizable. No elimines INCOMPLETE para forzar la continuación. Tras resolver un fallo de lectura, descarga los datos con un nombre de instantánea nuevo y usa ese nombre en los comandos posteriores de vista previa y creación del plan.
Crea el CSV de revisión a partir de la instantánea inicial completa. Python conserva los IDs enteros grandes originales; el archivo de revisión usa los prefijos h:, m:, t: y at: para mantener los identificadores, los títulos y las marcas de tiempo como texto en la hoja de cálculo.
python3 trakt_repair.py preview before
Selecciona los visionados con fechas falsas y revisa el plan
Abre trakt-repair/before-review.csv. Escribe exactamente YES en la columna choose solo para los visionados cuyas fechas hayas confirmado personalmente que son falsas; después, guarda el archivo como CSV UTF-8. No cambies ninguna otra celda ni ningún prefijo. Las marcas de tiempo son las de la API; una etiqueta Today («Hoy») en la interfaz de Trakt puede reflejar otra zona horaria de visualización. La herramienta guarda otra copia del CSV con tu selección cuando se crea el plan.
python3 trakt_repair.py plan before trakt-repair/before-review.csv
El plan coteja cada history ID seleccionado con la instantánea inicial sin procesar y verifica la película, el título y la marca de tiempo original. Rechaza la selección de varios visionados de una misma película y cualquier película seleccionada que ya tenga un visionado con fecha Unknown. Muestra las sustituciones propuestas y exige que escribas exactamente YES antes de guardar el plan. Trakt ha anunciado la normalización de marcas de tiempo al minuto y la eliminación de duplicados según el elemento y la marca de tiempo; cambiar los segundos no sirve para conservar por separado visionados repetidos sin fecha.
Si las películas seleccionadas están en tu Watchlist integrada, el plan muestra sus movie IDs y pregunta por separado si aceptas que se eliminen de esa lista. Trakt puede eliminar un elemento de esa lista al marcarlo como visto; las fuentes consultadas no establecen ninguna excepción para Unknown. Escribe YES, REMOVE FROM WATCHLIST solo si aceptas ese resultado. De lo contrario, detente, excluye esos títulos y vuelve a revisar. Las comprobaciones cubren la pertenencia a la Watchlist, no la conservación de sus notas, su posición ni su fecha original de incorporación.
Revisa trakt-repair/plan.json y trakt-repair/add.json en un editor de texto. La adición usa movie IDs y establece watched_at en la cadena literal unknown. No la sustituyas por null, no omitas el valor ni uses una fecha antigua inventada. Todavía no existe ninguna solicitud de eliminación. Empieza con un único visionado cuya fecha falsa hayas confirmado; una vez superada la comprobación final, crea una nueva carpeta de trabajo principal vacía y obtén una instantánea inicial nueva para un lote mayor. Por diseño, los planes existentes no se sobrescriben.
Añade Unknown y verifica las sustituciones
El siguiente comando realiza el primer cambio en la cuenta. Tras revisar add.json, ejecútalo una sola vez. Conserva el cuerpo y las cabeceras de la respuesta. Cada comando de escritura requiere nombres de archivo de respuesta que no se hayan usado, desactiva la configuración oculta de curl y no incluye ninguna opción de reintento automático ni de redirección. Si se rechaza la ejecución porque ya existe un archivo de respuesta, debes revisar el estado guardado, no eliminar el archivo y repetir la escritura.
test ! -e trakt-repair/add-response.json && test ! -e trakt-repair/add-response-headers.txt && curl -q --fail-with-body --silent --show-error --request POST --header @trakt-repair/auth.headers --data-binary @trakt-repair/add.json --dump-header trakt-repair/add-response-headers.txt --output trakt-repair/add-response.json --write-out 'HTTP %{http_code}\n' https://api.trakt.tv/sync/history
Cuando la ejecución del comando haya terminado, incluso con un error o un resultado incierto, lee una instantánea nueva completa y ejecuta la comprobación intermedia. Un recuento de elementos añadidos o un resultado HTTP satisfactorio no determina qué IDs de visionado existen ahora.
python3 trakt_repair.py fetch after-add
python3 trakt_repair.py verify-add after-add
La comprobación exige exactamente un history ID nuevo con fecha Unknown por cada película seleccionada, mientras que todos los visionados originales de películas deben conservar la misma película, la marca de tiempo normalizada al minuto y la acción. Las valoraciones de películas y sus marcas de tiempo deben coincidir. Solo se permiten las eliminaciones de la Watchlist aceptadas en el plan; cualquier incorporación o pérdida ajena a ellas detiene el proceso.
Al volver a leer los datos, Unknown corresponde al instante UTC exacto 1970-01-01T00:00:00Z; una representación equivalente con .000Z indica el mismo instante. La herramienta compara los instantes interpretados, no una fecha o un año completos. Las solicitudes siguen usando la cadena literal unknown. Los nuevos IDs verificados se guardan por separado de los IDs originales seleccionados.
Solo una comprobación intermedia superada crea trakt-repair/add-verified.json y trakt-repair/remove.json. Revisa este último: su array ids de nivel superior debe contener únicamente tus history IDs originales seleccionados. Un array movies tendría un alcance de eliminación mayor y no debe sustituirlo. Los nuevos IDs con fecha Unknown no deben aparecer en esta solicitud.
Temporalmente hay un visionado adicional por cada película seleccionada. El procedimiento verifica la sustitución antes de eliminar el registro anterior, evitando crear deliberadamente un intervalo sin ningún visionado. Siguen siendo dos escrituras independientes en la API, con posibles efectos secundarios en la cuenta; no constituyen una edición de la fecha en el registro original.
Elimina solo los IDs anteriores y verifica la finalización
Ejecuta este segundo comando que modifica la cuenta solo después de superar la comprobación intermedia y de revisar remove.json. Conserva la respuesta, incluida la información de deleted y not_found.
test ! -e trakt-repair/remove-response.json && test ! -e trakt-repair/remove-response-headers.txt && curl -q --fail-with-body --silent --show-error --request POST --header @trakt-repair/auth.headers --data-binary @trakt-repair/remove.json --dump-header trakt-repair/remove-response-headers.txt --output trakt-repair/remove-response.json --write-out 'HTTP %{http_code}\n' https://api.trakt.tv/sync/history/remove
Lee una instantánea nueva completa y comprueba el resultado final:
python3 trakt_repair.py fetch final
python3 trakt_repair.py verify-final final
El resultado correcto es el historial original de películas menos los IDs anteriores seleccionados, más los nuevos IDs concretos con fecha Unknown verificados antes. Cada visionado original no seleccionado y cada sustituto deben conservar la película, la marca de tiempo normalizada y la acción previstas. Las valoraciones de películas deben permanecer sin cambios, y la pertenencia de las películas a la Watchlist debe coincidir con la instantánea tomada después de la adición. Un total coincidente por sí solo no permite superar la comprobación.
La herramienta escribe final-verified-final.json cuando se cumplen estas condiciones. Al haber un sustituto por cada visionado seleccionado, el número de visionados de películas vuelve al total de la instantánea inicial y se conservan los visionados repetidos con fechas reales. Abre varias películas corregidas en Trakt como comprobación visual independiente: deben seguir marcadas como vistas con un visionado de fecha Unknown, mientras que las fechas falsas seleccionadas ya no deben aparecer. Unknown está concebido para quedar excluido de los gráficos basados en fechas.
Conserva de forma privada la fuente original, la exportación oficial, las instantáneas sin procesar, el CSV seleccionado, el plan, las solicitudes, las respuestas y los archivos de verificación. El sustituto tiene un history ID nuevo; el proceso no conserva la identidad original de scrobble o check-in del visionado eliminado. Reanuda las importaciones pausadas solo después de aceptar el resultado final.
Si se detiene una lectura o una adición, conserva la etapa guardada
Una lectura fallida no establece una instantánea inicial ni un resultado completos. Ante errores HTTP, la herramienta guarda el estado de la respuesta, sus cabeceras pertinentes y su cuerpo en archivos get-error con marca de tiempo; no guarda allí las credenciales de la solicitud. La instantánea sigue marcada como INCOMPLETE. Resuelve el problema indicado y después elige un nombre de instantánea nuevo. Nunca sobrescribas los datos del fallo.
Si solo se observa una parte de la adición, verify-add escribe un informe add-incomplete que identifica los nuevos IDs con fecha Unknown y las películas que faltan. No crea remove.json. No vuelvas a enviar la adición completa ni elimines los originales. Cuando la solicitud pendiente haya terminado de procesarse, descarga una instantánea posterior con un nombre nuevo y ejecuta verify-add con ese nombre. Si entonces aparece el resultado completo esperado, continúa desde la etapa verificada.
Esta herramienta no genera automáticamente una solicitud para las adiciones que faltan. Si el resultado sigue siendo parcial, conserva el informe y detén ese intento de corrección, o utiliza la alternativa de abandono que se explica más abajo después de una comprobación nueva. Los visionados nuevos inesperados, los originales ausentes, las valoraciones modificadas o los cambios no aceptados en la Watchlist requieren investigación; no edites los manifiestos ni elimines comprobaciones para forzar la aceptación.
Trakt documenta una escritura autenticada por segundo y 500 solicitudes GET autenticadas por cada cinco minutos. Respeta Retry-After en las respuestas 429; otras aplicaciones pueden compartir los límites de la cuenta. La autenticación, la aprobación de la aplicación, los límites de la cuenta y los datos no válidos son errores distintos. Sustituir un token no resuelve todas las respuestas 403, 420, 422 o 426, y esta herramienta vincula un lote activo a su archivo de credenciales existente.
Si la eliminación es parcial, reintenta solo los IDs seleccionados restantes
Tras una respuesta de eliminación incierta, descarga primero una instantánea nueva y ejecuta verify-final. Si todos los registros conservados son correctos y solo quedan algunos de los IDs originales seleccionados, la herramienta crea un archivo remaining-remove que contiene únicamente esos IDs. Se detiene en lugar de informar de que el proceso ha terminado. Nunca resuelve una discrepancia de recuentos eliminando todos los visionados de una película.
El siguiente ejemplo solo se aplica cuando verify-final final haya creado trakt-repair/remaining-remove-final.json. Revisa ese archivo exacto antes de usarlo. Si tu instantánea tiene otro nombre, utiliza el nombre de archivo remaining-remove que haya indicado realmente la herramienta y nombres nuevos para los archivos de respuesta.
test ! -e trakt-repair/remove-retry-response.json && test ! -e trakt-repair/remove-retry-response-headers.txt && curl -q --fail-with-body --silent --show-error --request POST --header @trakt-repair/auth.headers --data-binary @trakt-repair/remaining-remove-final.json --dump-header trakt-repair/remove-retry-response-headers.txt --output trakt-repair/remove-retry-response.json --write-out 'HTTP %{http_code}\n' https://api.trakt.tv/sync/history/remove
Después, toma otra instantánea nueva y comprueba las mismas condiciones finales. No repitas la adición como parte de la recuperación de una eliminación.
python3 trakt_repair.py fetch final-2
python3 trakt_repair.py verify-final final-2
Opcional: deshaz la adición de visionados con fecha Unknown antes de eliminar los originales
Usa esta alternativa solo para abandonar una adición mientras sigan existiendo todos los visionados originales. Deja que terminen de procesarse las solicitudes pendientes y mantén pausados los demás procesos que realizan cambios. La herramienta debe establecer que los únicos visionados nuevos son, como máximo, uno con fecha Unknown por cada película seleccionada, y que el historial original y las valoraciones siguen intactos. Las eliminaciones aceptadas de la Watchlist pueden mantenerse; esto no revierte por completo la cuenta a su estado anterior.
python3 trakt_repair.py fetch undo-check
python3 trakt_repair.py prepare-undo-add undo-check
Solo si la herramienta genera undo-add-undo-check.json, revísalo y confirma que contiene los history IDs de los visionados con fecha Unknown recién añadidos, nunca los IDs originales. El siguiente comando elimina expresamente esos visionados nuevos. Si la herramienta se niega a continuar, conserva los archivos e investiga en lugar de construir una solicitud de alcance mayor.
test ! -e trakt-repair/undo-add-response.json && test ! -e trakt-repair/undo-add-response-headers.txt && curl -q --fail-with-body --silent --show-error --request POST --header @trakt-repair/auth.headers --data-binary @trakt-repair/undo-add-undo-check.json --dump-header trakt-repair/undo-add-response-headers.txt --output trakt-repair/undo-add-response.json --write-out 'HTTP %{http_code}\n' https://api.trakt.tv/sync/history/remove
Vuelve a leer los datos y verifica que estén presentes el historial original de películas y las valoraciones. Revisa por separado cualquier pérdida de la Watchlist que hayas aceptado anteriormente.
python3 trakt_repair.py fetch undone
python3 trakt_repair.py verify-undo undone
Da por cerrado este lote después de abandonarlo. No ejecutes más adelante sus antiguos add.json ni remove.json. Cualquier intento nuevo requiere una carpeta de trabajo nueva y vacía y una instantánea inicial nueva. Si las instantáneas no permiten establecer exactamente qué ocurrió, conserva los registros restantes y solicita ayuda con un plan del que hayas eliminado los datos sensibles, en lugar de adivinar qué IDs debes eliminar.
Herramienta local completa
Copia el comando completo del siguiente párrafo como un único comando de Bash. Solo escribe el archivo de código fuente legible, sin ejecutar la herramienta ni contactar con Trakt. Después, abre trakt_repair.py y vuelve a la sección Instala la herramienta y lee una instantánea inicial completa. Mantén sin cambios las comillas rectas y las barras invertidas; no traduzcas este comando.
python3 -c 'from pathlib import Path; import hashlib,sys; p=Path("trakt_repair.py"); source="#!/usr/bin/env python3\n\"\"\"Movie-history repair helper: local files and authenticated GET requests only.\n\nThis program NEVER sends POST, DELETE or PUT requests. Inspect its generated\nJSON, then use separate explicit curl commands. Python 3.10+; Bash examples.\nAPI response contracts were checked against the Trakt authors'"'"' published code.\nNo live account or device was used to test this helper. Pause other imports,\nscrobblers and history edits until the final check. Pagination is not atomic.\n\"\"\"\nimport argparse\nimport csv\nimport datetime as dt\nimport hashlib\nimport io\nimport json\nimport os\nfrom pathlib import Path\nimport re\nimport sys\nimport time\nimport urllib.error\nimport urllib.parse\nimport urllib.request\n\nROOT = Path(\"trakt-repair\")\nAPI = \"https://api.trakt.tv\"\nENDPOINTS = {\"history\": \"/users/me/history/movies\", \"ratings\": \"/users/me/ratings/movies\", \"watchlist\": \"/users/me/watchlist/movies/rank\"}\nEPOCH = dt.datetime(1970, 1, 1, tzinfo=dt.timezone.utc)\nLAST_GET = 0.0\n\n\ndef check(ok, why):\n if not ok:\n raise ValueError(why)\n\n\ndef sha(data):\n return hashlib.sha256(data).hexdigest()\n\n\ndef encoded(value):\n return (json.dumps(value, ensure_ascii=False, indent=2) + \"\\n\").encode(\"utf-8\")\n\n\ndef read_json(path):\n return json.loads(path.read_bytes())\n\n\ndef write_new(path, data):\n with path.open(\"xb\") as f:\n f.write(data)\n\n\ndef write_same(path, data):\n if path.exists():\n check(path.read_bytes() == data, \"Existing output differs; it will not be overwritten: \" + str(path))\n else:\n write_new(path, data)\n\n\ndef now():\n return dt.datetime.now(dt.timezone.utc).isoformat()\n\n\ndef number(v):\n return type(v) is int and 0 < v <= 9223372036854775807\n\n\ndef date(v):\n check(isinstance(v, str), \"Missing or non-string timestamp; null is not Unknown.\")\n d = dt.datetime.fromisoformat(v.replace(\"Z\", \"+00:00\"))\n check(d.tzinfo is not None, \"Timestamp has no timezone.\")\n return d.astimezone(dt.timezone.utc)\n\n\ndef mid(row):\n check(isinstance(row, dict) and row.get(\"type\") == \"movie\", \"Unexpected non-movie row.\")\n m = row.get(\"movie\")\n check(isinstance(m, dict) and isinstance(m.get(\"ids\"), dict), \"Missing/null movie: stop, do not skip it.\")\n i = m[\"ids\"].get(\"trakt\")\n check(number(i), \"Invalid Trakt movie ID.\")\n return i\n\n\ndef validate(kind, rows):\n check(isinstance(rows, list), \"Expected a JSON array.\")\n seen = set()\n for r in rows:\n movie = mid(r)\n if kind == \"history\":\n key = r.get(\"id\")\n check(number(key), \"Invalid history ID; require an exact positive int64.\")\n date(r.get(\"watched_at\"))\n check(isinstance(r.get(\"action\"), str) and bool(r[\"action\"]), \"Missing history action.\")\n else:\n key = movie\n if kind == \"ratings\":\n check(type(r.get(\"rating\")) is int and 1 <= r[\"rating\"] <= 10, \"Invalid rating.\")\n date(r.get(\"rated_at\"))\n elif kind == \"watchlist\":\n date(r.get(\"listed_at\"))\n else:\n raise ValueError(\"Unexpected dataset.\")\n check(key not in seen, \"Duplicate ID: incomplete or changing snapshot.\")\n seen.add(key)\n return rows\n\n\ndef signature(r):\n return (mid(r), date(r[\"watched_at\"]).replace(second=0, microsecond=0).isoformat(), r[\"action\"])\n\n\ndef hist(rows):\n return {r[\"id\"]: signature(r) for r in rows}\n\n\ndef ratings(rows):\n return {mid(r): (r[\"rating\"], date(r[\"rated_at\"]).isoformat()) for r in rows}\n\n\ndef watchlist(rows):\n return {mid(r) for r in rows}\n\n\ndef label(value):\n check(bool(re.fullmatch(r\"[a-z][a-z0-9_-]{0,40}\", value)), \"Use a short lowercase snapshot name, for example before or after-add.\")\n return value\n\n\ndef parse_headers(raw):\n text = raw.decode(\"ascii\")\n check(\"\\r\" not in text.replace(\"\\r\\n\", \"\"), \"Use LF or CRLF header lines, not a bare carriage return.\")\n lines = text.replace(\"\\r\\n\", \"\\n\").split(\"\\n\")\n if lines and lines[-1] == \"\":\n lines.pop()\n check(lines and all(lines), \"Empty header lines are not accepted.\")\n headers = {}\n for line in lines:\n check(not any(ord(c) < 32 or ord(c) == 127 for c in line), \"Folded lines and control characters are not accepted.\")\n name, separator, value = line.partition(\":\")\n check(separator and re.fullmatch(r\"[A-Za-z0-9-]+\", name), \"Malformed local header file; use one complete header per line.\")\n key = name.lower()\n check(key not in headers, \"Duplicate header name in local file.\")\n value = value.strip(\" \")\n check(value and not any(ord(c) < 32 or ord(c) == 127 for c in value), \"Header values must be nonempty and contain no control characters.\")\n headers[key] = value\n check(set(headers) == {\"authorization\", \"trakt-api-key\", \"trakt-api-version\", \"content-type\", \"user-agent\"}, \"The local file must contain exactly the five header names listed in this guide and Trakt'"'"'s authentication reference.\")\n check(headers[\"trakt-api-version\"] == \"2\", \"The API version header must be 2.\")\n # The reader prepares all values using the official authentication reference.\n # This helper does not create, infer, inspect a scheme, or refresh credentials.\n return headers\n\n\ndef auth():\n raw = (ROOT / \"auth.headers\").read_bytes()\n return parse_headers(raw), sha(raw)\n\n\ndef init(headers_file):\n raw = Path(headers_file).expanduser().read_bytes()\n parse_headers(raw)\n ROOT.mkdir(exist_ok=True, mode=0o700)\n check(not (ROOT / \"auth.headers\").exists(), \"Credentials already exist; do not change accounts within a repair batch.\")\n ROOT.chmod(0o700)\n write_new(ROOT / \"auth.headers\", raw)\n (ROOT / \"auth.headers\").chmod(0o600)\n print(\"Imported your existing complete header file byte-for-byte into a private local working directory. No authentication value was created or displayed. Keep both local copies private; do not share this directory.\")\n\n\ndef get(path, headers):\n global LAST_GET\n delay = 0.65 - (time.monotonic() - LAST_GET)\n if delay > 0:\n time.sleep(delay)\n LAST_GET = time.monotonic()\n request = urllib.request.Request(API + path, headers=headers, method=\"GET\")\n # No retry and no redirect: do not forward credentials to another location.\n class NoRedirect(urllib.request.HTTPRedirectHandler):\n def redirect_request(self, req, fp, code, msg, response_headers, newurl):\n return None\n try:\n with urllib.request.build_opener(NoRedirect).open(request, timeout=45) as response:\n check(response.status == 200, \"GET did not return HTTP 200.\")\n return response.read(), {k.lower(): v for k, v in response.headers.items()}\n except urllib.error.HTTPError as exc:\n body = exc.read()\n public_headers = {k.lower(): v for k, v in exc.headers.items() if k.lower() in (\"retry-after\", \"date\", \"content-type\", \"x-request-id\") or k.lower().startswith(\"x-ratelimit\")}\n stem = \"get-error-\" + dt.datetime.now(dt.timezone.utc).strftime(\"%Y%m%dT%H%M%S%fZ\")\n write_new(ROOT / (stem + \"-body.bin\"), body)\n write_new(ROOT / (stem + \".json\"), encoded({\"method\": \"GET\", \"path\": path, \"status\": exc.code, \"response_headers\": public_headers, \"response_body\": stem + \"-body.bin\"}))\n retry = public_headers.get(\"retry-after\", \"not supplied\")\n raise ValueError(\"GET HTTP \" + str(exc.code) + \"; Retry-After: \" + retry + \". Saved response metadata/body at \" + str(ROOT / stem) + \". Snapshot stays INCOMPLETE. No automatic retry.\") from None\n\n\ndef page_meta(headers, page):\n keys = (\"page\", \"page-count\", \"item-count\", \"limit\")\n check(all(\"x-pagination-\" + k in headers for k in keys), \"Pagination headers missing: completeness is unproved, so stop.\")\n d = {k: int(headers[\"x-pagination-\" + k]) for k in keys}\n check(d[\"page\"] == page and d[\"limit\"] > 0 and d[\"item-count\"] >= 0, \"Invalid pagination metadata.\")\n if d[\"item-count\"] == 0:\n check(d[\"page-count\"] in (0, 1) and page == 1, \"Invalid empty-list pagination.\")\n else:\n check(d[\"page-count\"] == (d[\"item-count\"] + d[\"limit\"] - 1) // d[\"limit\"], \"Inconsistent page count.\")\n return d\n\n\ndef collect(kind, endpoint, destination, headers, fetcher=get):\n rawdir = destination / (kind + \"-raw\")\n rawdir.mkdir()\n all_rows, pages, stamp, first = [], [], None, None\n p, limit = 1, 100\n while True:\n path = endpoint + \"?\" + urllib.parse.urlencode({\"page\": p, \"limit\": limit})\n body, response_headers = fetcher(path, headers)\n name = \"page-%04d.json\" % p\n write_new(rawdir / name, body)\n meta = page_meta(response_headers, p)\n current = (meta[\"page-count\"], meta[\"item-count\"], meta[\"limit\"])\n stamp = current if stamp is None else stamp\n check(stamp == current, \"Dataset changed during pagination.\")\n rows = validate(kind, json.loads(body))\n count = max(0, min(meta[\"limit\"], meta[\"item-count\"] - (p - 1) * meta[\"limit\"]))\n check(len(rows) == count, \"Short page: the snapshot is incomplete.\")\n first = rows if first is None else first\n all_rows.extend(rows)\n pages.append({\"file\": name, \"sha256\": sha(body), \"pagination\": meta})\n if p >= max(1, meta[\"page-count\"]):\n break\n p, limit = p + 1, meta[\"limit\"]\n validate(kind, all_rows)\n check(len(all_rows) == stamp[1], \"Wrong total row count.\")\n body, response_headers = fetcher(endpoint + \"?\" + urllib.parse.urlencode({\"page\": 1, \"limit\": stamp[2]}), headers)\n write_new(rawdir / \"first-page-recheck.json\", body)\n final_meta = page_meta(response_headers, 1)\n check(tuple(final_meta[k] for k in (\"page-count\", \"item-count\", \"limit\")) == stamp and validate(kind, json.loads(body)) == first, \"First page or pagination changed: pause other writers and fetch again using a NEW snapshot name.\")\n data = encoded(all_rows)\n write_new(destination / (kind + \".json\"), data)\n return {\"endpoint\": endpoint, \"total\": len(all_rows), \"pages\": pages, \"first_page_recheck_sha256\": sha(body), \"sha256\": sha(data)}\n\n\ndef fetch(name):\n name = label(name)\n headers, auth_hash = auth()\n destination = ROOT / name\n destination.mkdir()\n write_new(destination / \"INCOMPLETE\", b\"Do not use this snapshot until manifest.json is complete.\\n\")\n manifest = {\"version\": 1, \"started_at\": now(), \"auth_sha256\": auth_hash, \"datasets\": {}}\n for kind, endpoint in ENDPOINTS.items():\n print(\"Fetching \" + kind + \"...\")\n manifest[\"datasets\"][kind] = collect(kind, endpoint, destination, headers)\n manifest.update({\"finished_at\": now(), \"complete\": True})\n write_new(destination / \"manifest.json\", encoded(manifest))\n (destination / \"INCOMPLETE\").unlink()\n print(\"Complete read-only snapshot: \" + str(destination) + \". Raw JSON and pagination metadata retained.\")\n\n\ndef snapshot(name):\n destination = ROOT / label(name)\n check(not (destination / \"INCOMPLETE\").exists(), \"Incomplete snapshot; no plan may use it.\")\n manifest_path = destination / \"manifest.json\"\n manifest = read_json(manifest_path)\n check(manifest.get(\"complete\") is True and manifest.get(\"version\") == 1, \"Invalid snapshot manifest.\")\n check(manifest[\"auth_sha256\"] == auth()[1], \"Credentials changed since this snapshot; use one account/token per batch.\")\n result = {\"name\": name, \"manifest_sha256\": sha(manifest_path.read_bytes())}\n for kind, endpoint in ENDPOINTS.items():\n metadata = manifest[\"datasets\"][kind]\n check(metadata[\"endpoint\"] == endpoint, \"Wrong source endpoint.\")\n body = (destination / (kind + \".json\")).read_bytes()\n check(sha(body) == metadata[\"sha256\"], \"Snapshot file was changed.\")\n rows = validate(kind, json.loads(body))\n check(len(rows) == metadata[\"total\"], \"Snapshot row count mismatch.\")\n raw_rows = []\n for page in metadata[\"pages\"]:\n raw = (destination / (kind + \"-raw\") / page[\"file\"]).read_bytes()\n check(sha(raw) == page[\"sha256\"], \"Raw page was changed.\")\n raw_rows.extend(json.loads(raw))\n check(raw_rows == rows, \"Combined snapshot differs from raw responses.\")\n raw = (destination / (kind + \"-raw\") / \"first-page-recheck.json\").read_bytes()\n check(sha(raw) == metadata[\"first_page_recheck_sha256\"], \"Raw recheck was changed.\")\n result[kind] = rows\n return result\n\n\ndef preview(name):\n s = snapshot(name)\n check(s[\"history\"], \"No movie history to repair.\")\n out = io.StringIO(newline=\"\")\n writer = csv.writer(out)\n writer.writerow([\"choose\", \"history_id\", \"movie_id\", \"title\", \"year\", \"watched_at\", \"unknown\"])\n for r in s[\"history\"]:\n m = r[\"movie\"]\n writer.writerow([\"\", \"h:\" + str(r[\"id\"]), \"m:\" + str(mid(r)), \"t:\" + str(m.get(\"title\", \"\")), m.get(\"year\"), \"at:\" + r[\"watched_at\"], \"YES\" if date(r[\"watched_at\"]) == EPOCH else \"NO\"])\n path = ROOT / (name + \"-review.csv\")\n write_new(path, (\"\\ufeff\" + out.getvalue()).encode(\"utf-8\"))\n print(\"Review \" + str(path) + \". Put exact YES only in choose for plays you personally identify as false dates. Leave all other cells unchanged. h:, m:, t:, at: keep spreadsheet cells as text.\")\n\n\ndef select(s, path):\n raw = path.read_bytes()\n choices = list(csv.DictReader(io.StringIO(raw.decode(\"utf-8-sig\"))))\n check(choices and all(c.get(\"choose\") in (\"\", \"YES\") for c in choices), \"choose must be blank or exact YES.\")\n by_id = {\"h:\" + str(r[\"id\"]): r for r in s[\"history\"]}\n unknown = {mid(r) for r in s[\"history\"] if date(r[\"watched_at\"]) == EPOCH}\n selected = []\n for c in choices:\n if c[\"choose\"] != \"YES\":\n continue\n r = by_id.get(c.get(\"history_id\"))\n check(r is not None, \"Selected history ID is missing or changed; retain h:.\")\n check(c.get(\"movie_id\") == \"m:\" + str(mid(r)), \"Movie/history mismatch; retain m:.\")\n check(c.get(\"title\") == \"t:\" + str(r[\"movie\"].get(\"title\", \"\")) and c.get(\"watched_at\") == \"at:\" + r[\"watched_at\"], \"Selected title/date cell was changed; recheck the CSV.\")\n check(mid(r) not in unknown, \"Selected movie already has an Unknown play; this workflow stops.\")\n selected.append(r)\n check(selected and len({mid(r) for r in selected}) == len(selected), \"Select exactly one false play per selected movie, and at least one movie.\")\n return selected, sha(raw)\n\n\ndef plan(name, review):\n check(not (ROOT / \"plan.json\").exists() and not (ROOT / \"add.json\").exists(), \"This working directory already has a plan; do not overwrite a repair batch.\")\n s = snapshot(name)\n selected, selection_hash = select(s, Path(review))\n for r in selected:\n print(json.dumps({\"history_id\": \"h:\" + str(r[\"id\"]), \"movie_id\": \"m:\" + str(mid(r)), \"title\": r[\"movie\"].get(\"title\"), \"old_date\": r[\"watched_at\"], \"new_date\": \"Unknown\"}, ensure_ascii=False))\n affected = watchlist(s[\"watchlist\"]) & {mid(r) for r in selected}\n accepted = False\n if affected:\n print(\"These selected movie IDs are on your Watchlist and marking watched may remove them: \" + \", \".join(\"m:\" + str(i) for i in sorted(affected)))\n check(input(\"Accept those Watchlist removals? Type YES, REMOVE FROM WATCHLIST: \") == \"YES, REMOVE FROM WATCHLIST\", \"Watchlist removal not accepted; no plan written.\")\n accepted = True\n check(input(\"Confirm only the selected false-date plays above. Type YES: \") == \"YES\", \"No plan written.\")\n review_bytes = Path(review).read_bytes()\n check(sha(review_bytes) == selection_hash, \"The selected CSV changed during confirmation; no plan written.\")\n addition = {\"movies\": [{\"ids\": {\"trakt\": mid(r)}, \"watched_at\": \"unknown\"} for r in selected]}\n p = {\"version\": 1, \"created_at\": now(), \"before\": name, \"before_manifest_sha256\": s[\"manifest_sha256\"], \"auth_sha256\": auth()[1], \"selection_sha256\": selection_hash, \"selected_history_ids\": [r[\"id\"] for r in selected], \"watchlist_accepted\": accepted, \"add_sha256\": sha(encoded(addition))}\n write_new(ROOT / \"selected-review.csv\", review_bytes)\n write_new(ROOT / \"plan.json\", encoded(p))\n write_new(ROOT / \"add.json\", encoded(addition))\n print(\"Created plan.json and add.json. No API change made. No old-play removal file exists yet. Inspect both files before the separate ADD request.\")\n\n\ndef load_plan():\n p = read_json(ROOT / \"plan.json\")\n check(p.get(\"version\") == 1 and p[\"auth_sha256\"] == auth()[1], \"Plan/authentication mismatch.\")\n s = snapshot(p[\"before\"])\n check(p[\"before_manifest_sha256\"] == s[\"manifest_sha256\"], \"The plan'"'"'s baseline was changed.\")\n by_id = {r[\"id\"]: r for r in s[\"history\"]}\n ids = p[\"selected_history_ids\"]\n check(isinstance(ids, list) and ids and all(number(i) and i in by_id for i in ids), \"Invalid selected history IDs.\")\n selected = [by_id[i] for i in ids]\n saved_selection = ROOT / \"selected-review.csv\"\n check(sha(saved_selection.read_bytes()) == p[\"selection_sha256\"], \"Saved selected CSV changed.\")\n selected_again, selection_hash = select(s, saved_selection)\n check([r[\"id\"] for r in selected_again] == ids, \"Plan history IDs differ from the exact saved CSV selection.\")\n wanted = {mid(r) for r in selected}\n check(len(wanted) == len(selected), \"More than one selected play per movie.\")\n check(not any(mid(r) in wanted and date(r[\"watched_at\"]) == EPOCH for r in s[\"history\"]), \"Baseline contains a preexisting Unknown for a selected movie.\")\n check(not watchlist(s[\"watchlist\"]) & wanted or p[\"watchlist_accepted\"] is True, \"Watchlist acceptance is absent.\")\n addition = {\"movies\": [{\"ids\": {\"trakt\": mid(r)}, \"watched_at\": \"unknown\"} for r in selected]}\n check(sha((ROOT / \"add.json\").read_bytes()) == p[\"add_sha256\"] == sha(encoded(addition)), \"ADD request differs from the bound plan.\")\n return p, s, selected, sha((ROOT / \"plan.json\").read_bytes())\n\n\ndef common(before, current, wanted, accepted):\n check(ratings(before[\"ratings\"]) == ratings(current[\"ratings\"]), \"Movie ratings or rating timestamps changed; stop.\")\n old_w, new_w = watchlist(before[\"watchlist\"]), watchlist(current[\"watchlist\"])\n allowed = old_w & wanted if accepted else set()\n check(new_w <= old_w and old_w - new_w <= allowed, \"Unexpected movie Watchlist membership change; stop.\")\n\n\ndef added_state(p, before, selected, current):\n check(current[\"name\"] != before[\"name\"], \"Use a NEW snapshot taken after the ADD request.\")\n old, new = hist(before[\"history\"]), hist(current[\"history\"])\n wanted = {mid(r) for r in selected}\n check(set(old) <= set(new) and all(new[i] == old[i] for i in old), \"An original play is missing or changed; no removal request generated.\")\n common(before, current, wanted, p[\"watchlist_accepted\"])\n added = [r for r in current[\"history\"] if r[\"id\"] not in old]\n added_m = {mid(r) for r in added}\n check(added_m <= wanted and len(added_m) == len(added) and all(date(r[\"watched_at\"]) == EPOCH for r in added), \"Unexpected new plays or duplicate Unknowns; no removal request generated.\")\n return added, wanted\n\n\ndef verify_add(name):\n p, before, selected, plan_hash = load_plan()\n current = snapshot(name)\n added, wanted = added_state(p, before, selected, current)\n added_m = {mid(r) for r in added}\n if added_m != wanted:\n report = {\"plan_sha256\": plan_hash, \"snapshot\": name, \"snapshot_manifest_sha256\": current[\"manifest_sha256\"], \"new_unknown_ids\": [r[\"id\"] for r in added], \"missing_movie_ids\": sorted(wanted - added_m)}\n write_new(ROOT / (\"add-incomplete-\" + name + \".json\"), encoded(report))\n raise ValueError(\"ADD is only partly observed (or no new play is observed). Original plays remain. Do NOT resend ADD and do NOT remove originals. Keep this report; fetch a later NEW snapshot and re-run verify-add. To abandon the attempt after requests have settled, use prepare-undo-add on a fresh snapshot. Watchlist removals are not restored by undoing new plays.\")\n removal = {\"ids\": [r[\"id\"] for r in selected]}\n certificate = {\"plan_sha256\": plan_hash, \"after_add\": name, \"after_add_manifest_sha256\": current[\"manifest_sha256\"], \"unknown_plays\": added, \"remove_sha256\": sha(encoded(removal))}\n certificate_path = ROOT / \"add-verified.json\"\n if certificate_path.exists():\n saved = read_json(certificate_path)\n check(all(saved.get(k) == v for k, v in certificate.items()), \"Existing ADD certificate belongs to different evidence; do not overwrite it.\")\n else:\n check(not (ROOT / \"remove.json\").exists(), \"An unbound REMOVE file already exists; stop.\")\n certificate[\"verified_at\"] = now()\n write_new(certificate_path, encoded(certificate))\n write_same(ROOT / \"remove.json\", encoded(removal))\n print(\"ADD verified: every original play remains unchanged to its movie/date-minute/action, ratings are unchanged, and each target has exactly one new Unknown. Created remove.json containing only selected ORIGINAL history IDs. Inspect it before the separate REMOVE request.\")\n\n\ndef verify_final(name):\n p, before, selected, plan_hash = load_plan()\n certificate = read_json(ROOT / \"add-verified.json\")\n check(certificate[\"plan_sha256\"] == plan_hash, \"ADD verification is bound to a different plan.\")\n after_add = snapshot(certificate[\"after_add\"])\n check(certificate[\"after_add_manifest_sha256\"] == after_add[\"manifest_sha256\"], \"Verified ADD snapshot changed.\")\n actual_added, wanted = added_state(p, before, selected, after_add)\n check({mid(r) for r in actual_added} == wanted and certificate[\"unknown_plays\"] == actual_added, \"ADD certificate does not match the bound raw snapshot.\")\n removal = {\"ids\": [r[\"id\"] for r in selected]}\n check(sha((ROOT / \"remove.json\").read_bytes()) == certificate[\"remove_sha256\"] == sha(encoded(removal)), \"REMOVE request changed.\")\n current = snapshot(name)\n check(name not in (before[\"name\"], after_add[\"name\"]), \"Use a NEW snapshot taken after the REMOVE request.\")\n removed = {r[\"id\"] for r in selected}\n unknown = certificate[\"unknown_plays\"]\n validate(\"history\", unknown)\n expected = {i: sig for i, sig in hist(before[\"history\"]).items() if i not in removed}\n expected.update(hist(unknown))\n actual = hist(current[\"history\"])\n allowed_originals = {r[\"id\"]: signature(r) for r in selected}\n check(set(expected) <= set(actual) and all(actual[i] == expected[i] for i in expected), \"A retained or newly verified play is missing/changed; stop.\")\n remaining = set(actual) - set(expected)\n check(remaining <= removed and all(actual[i] == allowed_originals[i] for i in remaining), \"Unexpected final history change; stop.\")\n check(ratings(before[\"ratings\"]) == ratings(current[\"ratings\"]), \"Movie ratings or rating timestamps changed; stop.\")\n check(watchlist(after_add[\"watchlist\"]) == watchlist(current[\"watchlist\"]), \"Movie Watchlist membership changed during removal; stop.\")\n if remaining:\n path = ROOT / (\"remaining-remove-\" + name + \".json\")\n write_new(path, encoded({\"ids\": sorted(remaining)}))\n raise ValueError(\"REMOVE is incomplete. Fresh snapshot confirms only these selected original IDs remain; \" + str(path) + \" contains ONLY those IDs. Inspect it before any explicit retry of REMOVE; never resend ADD. Then fetch and verify a NEW final snapshot.\")\n report = {\"plan_sha256\": plan_hash, \"final_snapshot\": name, \"final_manifest_sha256\": current[\"manifest_sha256\"], \"verified_at\": now(), \"condition\": \"H0 minus S plus verified U; movie ratings unchanged; Watchlist membership unchanged since verified ADD\"}\n write_new(ROOT / (\"final-verified-\" + name + \".json\"), encoded(report))\n print(\"FINAL VERIFIED: original history minus only selected false-date plays plus their verified Unknown replacements. Existing real rewatches retained; movie ratings unchanged. Watchlist acceptance, if any, still applies.\")\n\n\ndef prepare_undo(name):\n p, before, selected, plan_hash = load_plan()\n current = snapshot(name)\n added, wanted = added_state(p, before, selected, current)\n check(added, \"No new Unknown plays observed to undo. Do not issue an empty removal request.\")\n payload = {\"ids\": [r[\"id\"] for r in added]}\n path = ROOT / (\"undo-add-\" + name + \".json\")\n write_new(path, encoded(payload))\n report = {\"plan_sha256\": plan_hash, \"snapshot\": name, \"snapshot_manifest_sha256\": current[\"manifest_sha256\"], \"payload_sha256\": sha(encoded(payload)), \"new_unknown_ids\": payload[\"ids\"]}\n write_new(ROOT / (\"undo-plan-\" + name + \".json\"), encoded(report))\n print(\"Optional abandonment request: \" + str(path) + \" removes ONLY new Unknown plays verified against the baseline. All original plays still exist. Inspect it, then use a separate explicit REMOVE request. This does not restore removed Watchlist membership. Afterward fetch a NEW snapshot and run verify-undo.\")\n\n\ndef verify_undo(name):\n p, before, selected, plan_hash = load_plan()\n current = snapshot(name)\n check(name != before[\"name\"], \"Use a NEW snapshot after the undo request.\")\n check(hist(before[\"history\"]) == hist(current[\"history\"]), \"History is not restored to the original IDs/movie/date-minute/action; stop.\")\n common(before, current, {mid(r) for r in selected}, p[\"watchlist_accepted\"])\n report = {\"plan_sha256\": plan_hash, \"snapshot\": name, \"snapshot_manifest_sha256\": current[\"manifest_sha256\"], \"verified_at\": now(), \"condition\": \"Original movie history and ratings restored; accepted Watchlist removals may remain\"}\n write_new(ROOT / (\"undo-verified-\" + name + \".json\"), encoded(report))\n print(\"UNDO VERIFIED: original movie history and ratings are present. Accepted Watchlist removals may remain. Abandon this batch; do not run its old add.json or remove.json. Use a fresh working directory for any later attempt.\")\n\n\ndef main():\n os.umask(0o077)\n parser = argparse.ArgumentParser(description=__doc__)\n sub = parser.add_subparsers(dest=\"command\", required=True)\n sub.add_parser(\"init\").add_argument(\"headers_file\")\n for command in (\"fetch\", \"preview\", \"verify-add\", \"verify-final\", \"prepare-undo-add\", \"verify-undo\"):\n sub.add_parser(command).add_argument(\"snapshot\")\n p = sub.add_parser(\"plan\")\n p.add_argument(\"snapshot\")\n p.add_argument(\"review_csv\")\n args = parser.parse_args()\n try:\n if args.command == \"init\":\n init(args.headers_file)\n elif args.command == \"fetch\":\n fetch(args.snapshot)\n elif args.command == \"preview\":\n preview(args.snapshot)\n elif args.command == \"plan\":\n plan(args.snapshot, args.review_csv)\n elif args.command == \"verify-add\":\n verify_add(args.snapshot)\n elif args.command == \"verify-final\":\n verify_final(args.snapshot)\n elif args.command == \"prepare-undo-add\":\n prepare_undo(args.snapshot)\n elif args.command == \"verify-undo\":\n verify_undo(args.snapshot)\n except (ValueError, KeyError, TypeError, OSError, csv.Error, urllib.error.HTTPError, urllib.error.URLError) as exc:\n print(\"STOP: \" + str(exc) + \"\\nNo mutation request was sent by this helper. Preserve existing files; do not overwrite snapshots or blindly repeat a POST.\", file=sys.stderr)\n raise SystemExit(2)\n\n\nif __name__ == \"__main__\":\n main()\n"; p.open("x",encoding="utf-8",newline="").write(source); hashlib.sha256(p.read_bytes()).hexdigest()=='"'"'21c8f1a918bd1b8d818476f57b2f7cab9ccfa56504da40fc1c586325d8aa2ded'"'"' or sys.exit("STOP: source SHA mismatch"); print("Complete source written locally. SHA-256: 21c8f1a918bd1b8d818476f57b2f7cab9ccfa56504da40fc1c586325d8aa2ded. Open and inspect trakt_repair.py before running it. No API request made.")'
El comando que escribe el código fuente muestra el SHA-256 del archivo creado. El SHA-256 del código fuente revisado para esta edición es 21c8f1a918bd1b8d818476f57b2f7cab9ccfa56504da40fc1c586325d8aa2ded. Si el valor mostrado es distinto, detente y vuelve a copiar el comando completo en una carpeta de trabajo nueva y vacía.