科技 · 实用指南
下载的tar.gz提示“非gzip格式”?先核对HTTP解码与保存字节
下载成功可能保存的是网页、已解码的tar或gzip文件。保留响应,确认字节层和预期内容,再调整解包参数。
.tar.gz文件名不能证明curl实际保存了什么。它可能是登录页、经HTTP解码后的普通tar、压缩包或损坏数据。gzip报错只说明当前步骤遇到格式不匹配,不能单凭这一句确定原因。
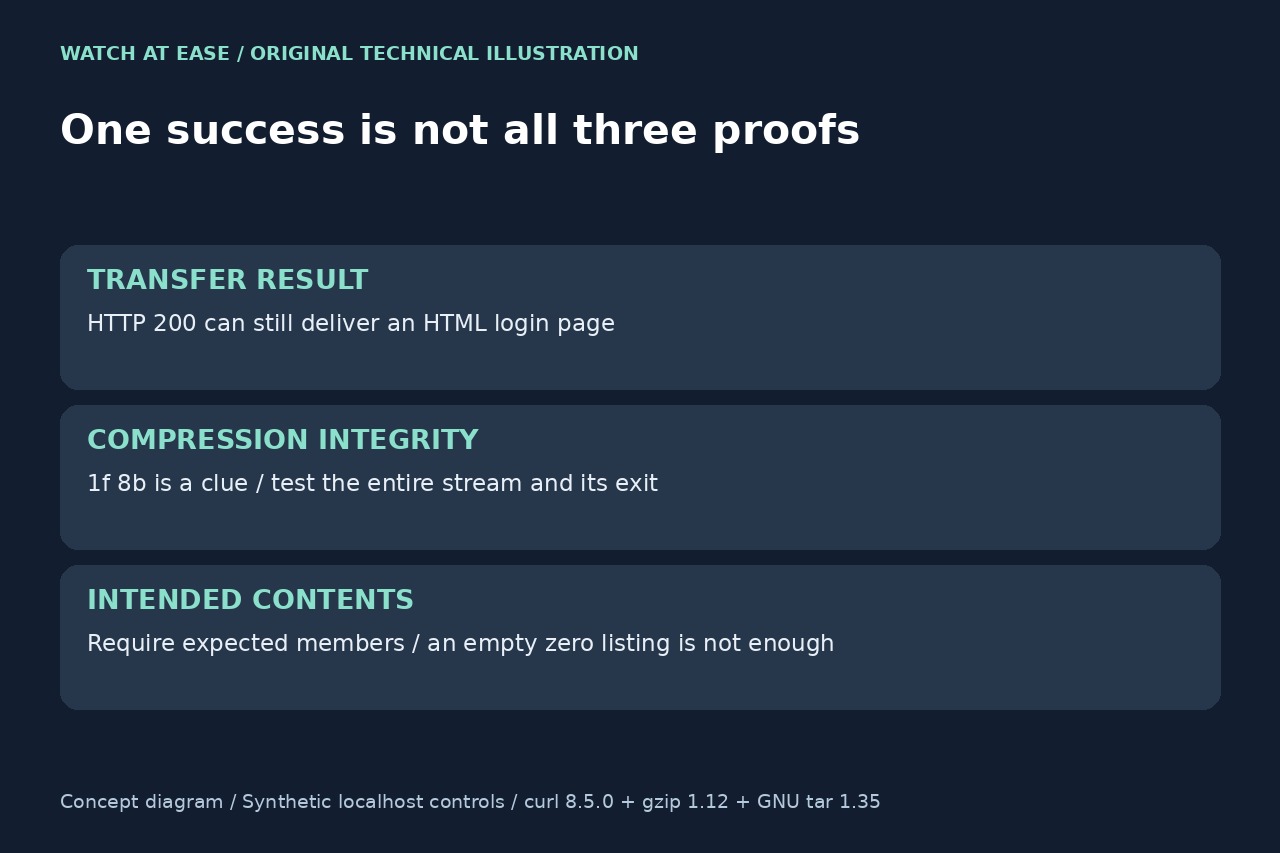
需要分别回答三个问题:请求是否完成、保存的压缩流是否完整、必需文件是否存在。HTTP状态、Content-Encoding、熟悉的文件头以及解包工具看似成功,都只能回答其中一部分。
1. 先保存一次响应,再尝试其他解包器
记录准确URL、curl版本和原始选项,尤其是--compressed、-i、跳转和管道。对照测试请在自己拥有的新建空目录中执行,先替换示例URL,响应头另存,并等待curl最终状态。首位-q会忽略默认curl配置文件;本次对照故意不加--compressed。以下是Linux shell命令,并非PowerShell语法。 ```sh url='https://publisher.example/exact-asset' curl -q -fLsS -D headers.txt -o download.bin \ -w 'http=%{http_code}\nurl=%{url_effective}\n' "$url" curl_status=$? printf 'curl_exit=%s\n' "$curl_status" file download.bin od -An -tx1 -N16 download.bin ```
查看跳转链的最终响应,不只看第一段响应头。-f有助于拦截HTTP失败,但登录页或错误页也可能返回200。Content-Type同样只是线索。不要用-i把头部混进正文,不要覆盖原样本、公开粘贴私密响应头,或把格式未明的字节直接输送给安装程序。
2. 判断还剩哪一层gzip
curl的--compressed处理的是HTTP内容编码。.gz文件本身可能又是载荷,所以解码后可能得到普通tar,也可能仍有一层gzip,取决于服务器实际发送的内容。关键是:-D保存的响应头在解码后保持原样。因此看到Content-Encoding: gzip,不能证明本地文件还需要gunzip。
将file识别结果与文件前几个字节对照。RFC 1952规定gzip成员以1f 8b开头,但这个前缀不能验证整条压缩流。可信样本识别为gzip后,运行gzip -t download.bin并查看最终结果。HTML需要修正获授权的下载路径;已验证的普通tar需要tar读取器。改名、强制参数或把-o换成-O,都不能把错误字节变成预期文件。
3. 用对照样本解释检查结果
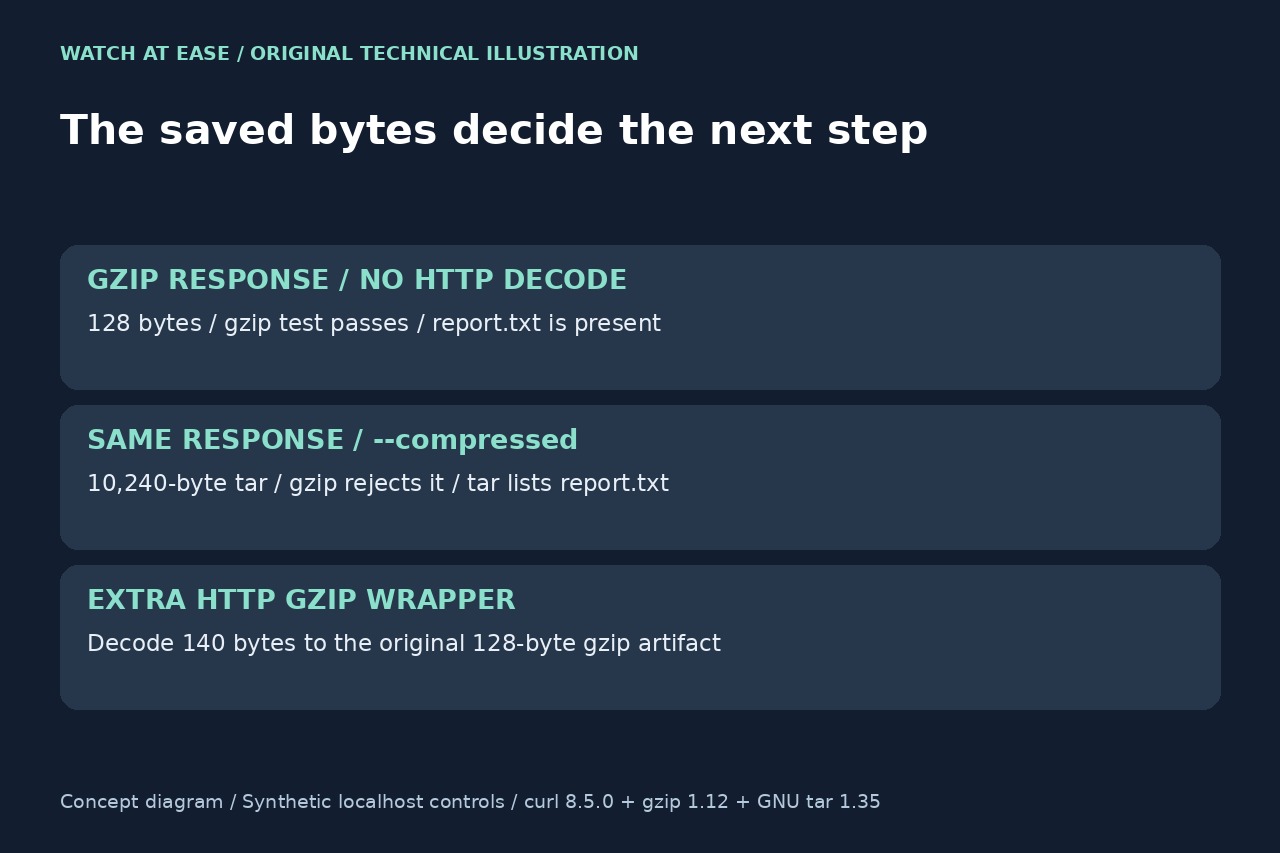
我们在Linux上用curl 8.5.0、gzip 1.12和GNU tar 1.35,对七种本地HTTP响应进行了九组响应与选项组合测试。所有请求均为HTTP 200且curl退出0。包含report.txt的128字节gzip通过压缩检查;同样字节带Content-Encoding: gzip并使用--compressed时,保存成10,240字节普通tar:gzip拒绝,tar却列出report.txt。额外套一层HTTP gzip后,解码得到原128字节文件,SHA-256一致。
反例同样重要。HTML即使HTTP 200仍无法通过gzip。改坏CRC或删除尾部的样本仍保留gzip前缀,却未通过完整性检查;tar在最终失败前曾打印report.txt。普通文本的有效gzip能通过gzip,却无法通过tar。未解码的140字节双层包装,在这一安装版本中甚至返回tar退出0、列表为空。因此零退出不能独自证明内容正确;这一观察不代表所有tar版本的行为。
4. 验证预期文件,再选择修复方式
有发布者提供的校验和或签名时,要针对它所描述的准确文件及字节层核验。普通tar与其gzip包装即使表示相同文件,也有不同哈希。自己计算的哈希只能记录字节身份,不能证明发布者可信。若不知道预期校验和对应哪一层,应保留响应和选项,而不是重新压缩直到看似匹配。
对于可信候选,检查tar -tf download.bin的输出,等到最终退出,再与必需文件名、目标版本和架构对照。预期有文件却列表为空不能接受;打印部分名称后报错也不能接受。HTML或损坏数据应重新获取获授权的完整副本;已验证的tar或gzip层则选择相应读取方式。之后才解包到新目录并测试必需文件。新目录能保护原输出,但不是不可信压缩包的安全沙箱。