テクノロジー · 実用ガイド
systemd status=219/CGROUP?委譲を変える前に失敗した cgroup 操作を読む
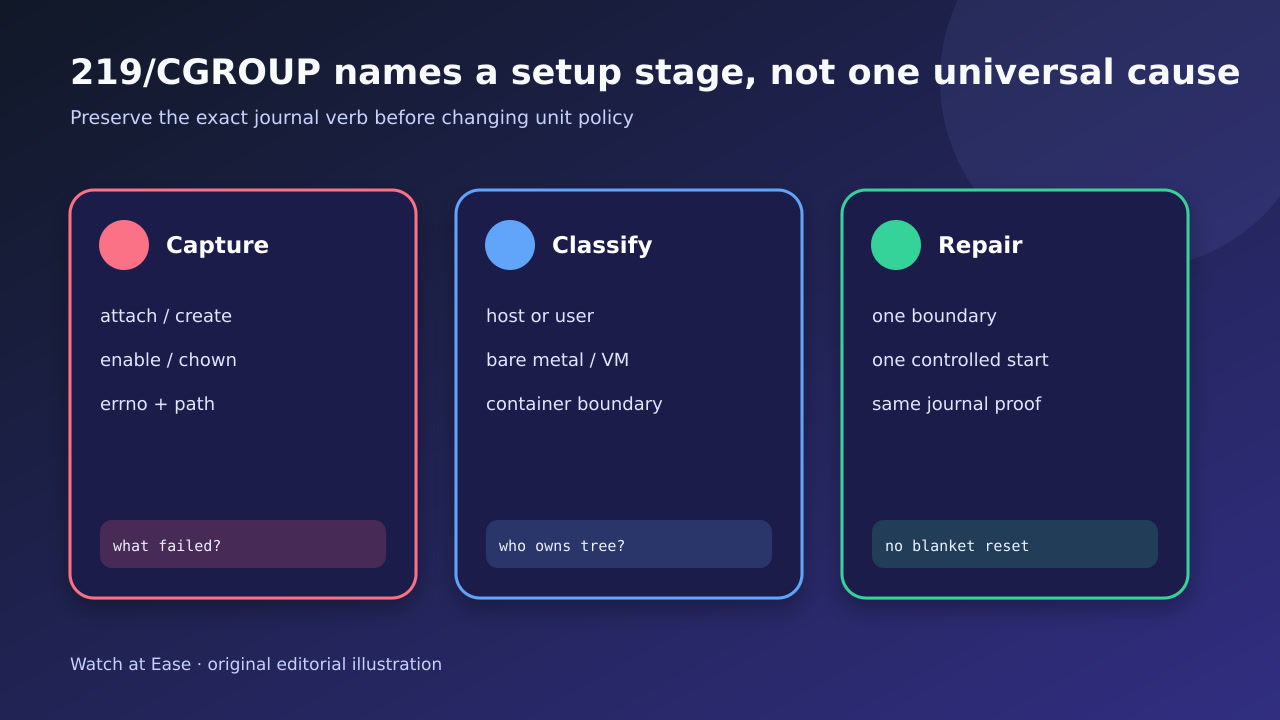
このコードは設定段階を示すだけで、解決策は一つではありません。journal の動詞、errno、パスを保存し、manager と階層を対応付け、一つの所有境界だけを直して一回の正常起動を証明します。
このコードは設定段階を示すだけで、解決策は一つではありません。journal の動詞、errno、パスを保存し、manager と階層を対応付け、一つの所有境界だけを直して一回の正常起動を証明します。
status 219 は systemd がサービス cgroup の設定中に失敗したことを示し、原因は一つではありません。
1. 最初の CGROUP 行を保存
reset-failed、再起動、reboot、権限変更の前に systemctl status と最初の失敗周辺の journal を保存します。create、attach、enable、migrate、所有権変更は別の分岐です。
errno と完全な cgroup パスを記録します。最後の status=219/CGROUP は段階だけを示し、直前の manager メッセージが修復対象の操作と物を示します。
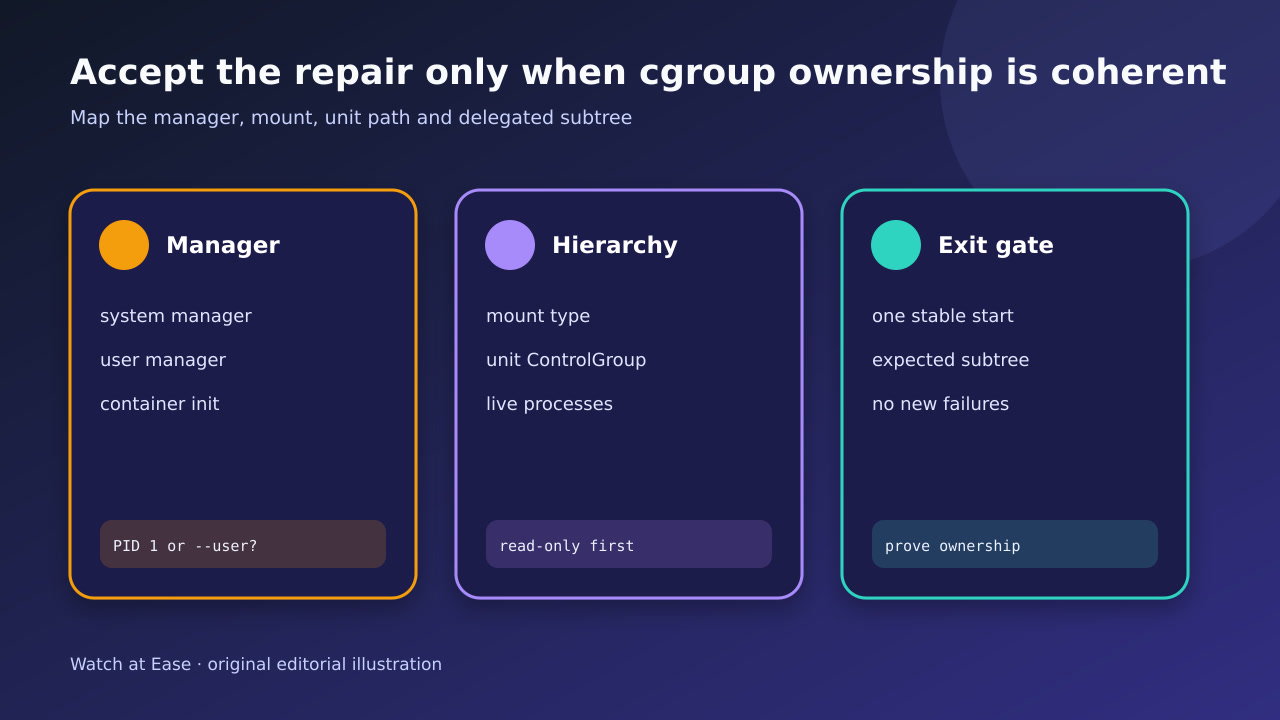
2. 担当 manager を特定
失敗 unit が PID 1、systemctl --user、container init、入れ子 manager のどれに属するか確認します。manager 版、kernel、仮想化、同じ UID/unit が境界外で動くかを記録します。
service process が原因とは限らず、まだ実行されていない場合があります。unit の ControlGroup と create/attach を試した manager を対応付けます。
3. 階層を読み取り専用で確認
/sys/fs/cgroup の mountinfo または findmnt、型、controller、systemctl show、systemd-cgls を読み取り専用で確認します。対象 unit または親以下の process を移動・終了せず一覧にします。
所有台帳を作ります。host manager は委譲 unit より上を所有し、delegatee は下だけを所有します。cgroup v2 の inner-node と controller 規則では残存 process や手動変更が次の start を妨げます。
4. 修復分岐を分類
証拠で分岐します。ENOENT は hierarchy/mount 不足、EROFS は read-only 境界、EACCES/EPERM は所有・委譲不一致、EBUSY は残存 process または不整合な subtree の可能性があります。編集前に vendor/container 制約を確認します。
一つの境界だけを変更します。再帰 chmod/chown、全面 Delegate=yes、resource control の無効化、cgroup directory の削除を避けます。unit が subgroup を持つなら controller や restart 方針の変更前に全 process を確認します。
5. 一回の制御起動を証明
観察しながら一回だけ start し、status、journal、ControlGroup、systemd-cgls を再確認します。期待する path/ownership/controller、health check、新しい 219 がないことを確認します。
reboot、container host、vendor update が必要なら明記し、前後証拠を残します。元の失敗操作を説明できない一時的な再試行成功を恒久修復としません。