기술 · 실용 가이드
systemd의 “start request repeated too quickly”: 초기 실패부터 확인하세요
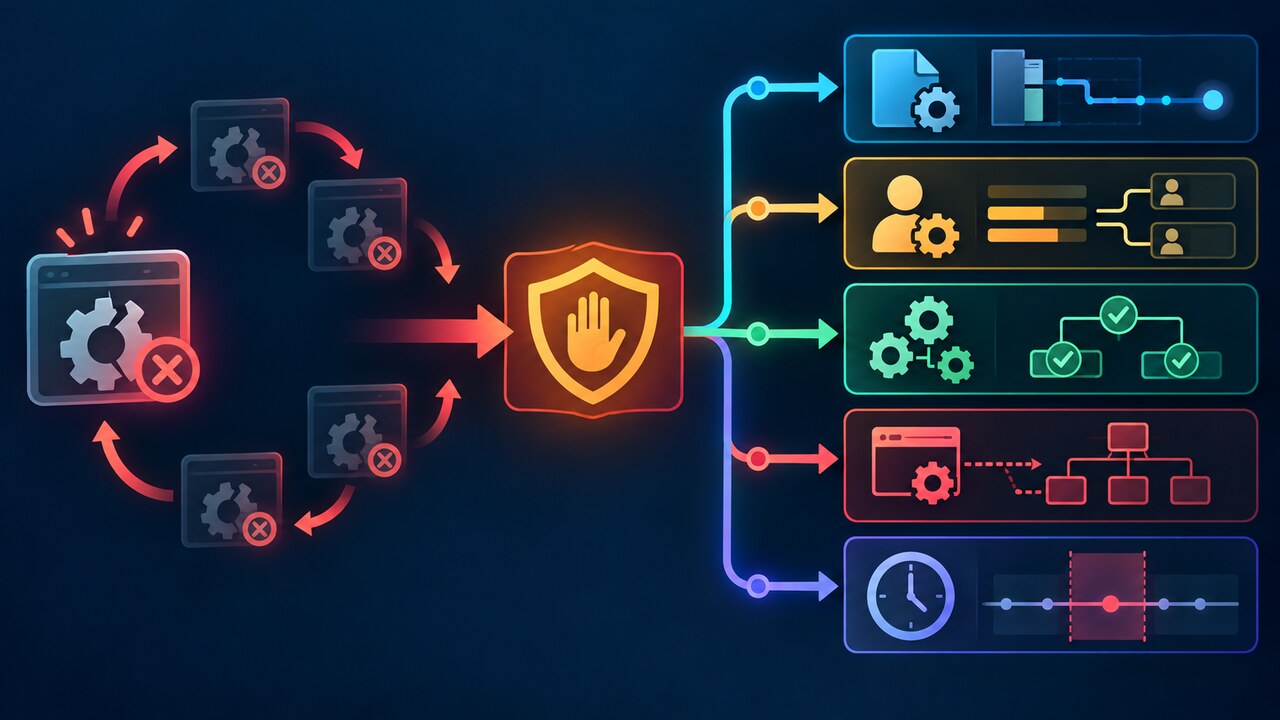
마지막 시작 제한 메시지는 대개 원인이 아니라 보호 장치입니다. 유효한 유닛과 최초 실패를 보존하고, 증거에 맞는 원인을 고친 뒤 카운터를 지우세요.
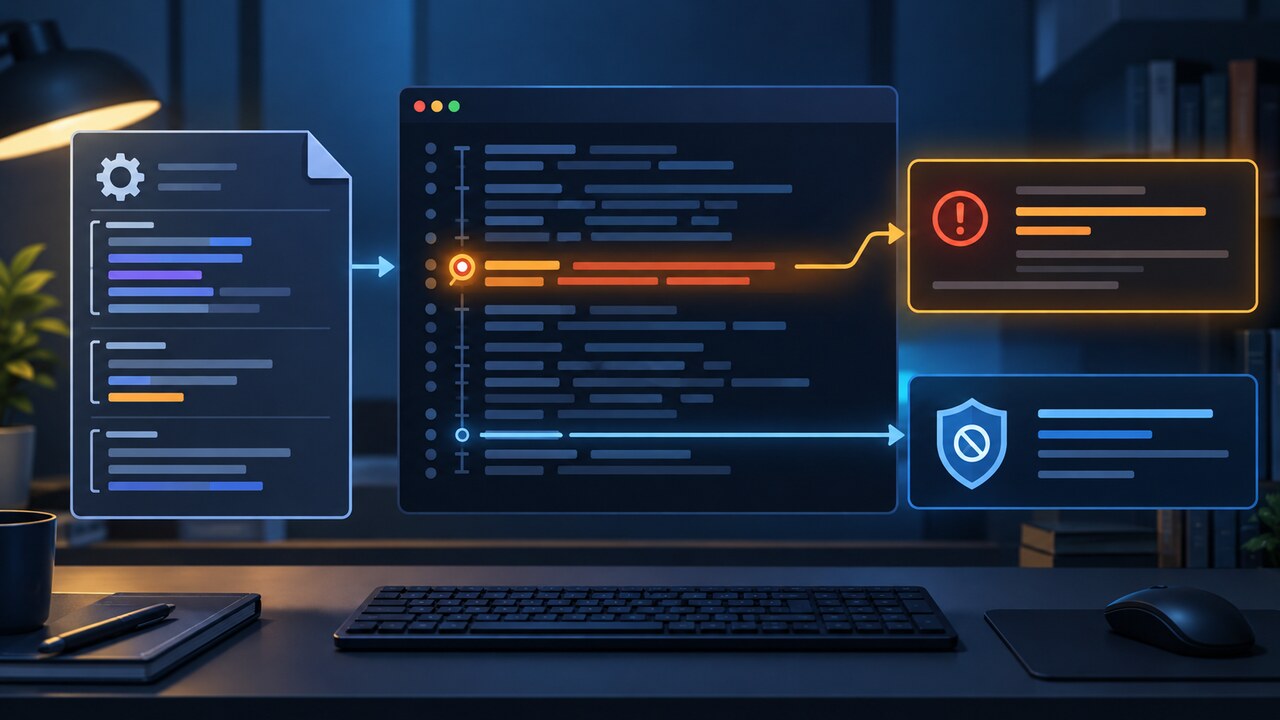
“start request repeated too quickly”는 설정된 시간 안에 시작 횟수가 한도를 넘어 systemd가 다음 시작을 거부했다는 뜻이다. 제한기는 여러 번의 시도 뒤에 작동하므로 프로세스가 처음 실패한 이유를 직접 말해 주지 않는다.
카운터를 초기화하거나 한도를 늘리거나 서비스를 다시 시작하기 전에 유효한 유닛과 최초 실패 journal을 보존한다. 제한 상태와 실행 파일, 계정, 경로, 의존성, 유닛 모델 증거를 분리해 진단해야 한다.
1. 거부 메시지를 원인이 아닌 보호 장치로 읽기
systemd는 유닛 활성화의 시작 속도를 제한한다. StartLimitIntervalSec 안에서 StartLimitBurst를 넘으면 다음 활성화가 거부되고 Result=start-limit-hit가 될 수 있다. 자동 재시작도 같은 경계를 따르므로 Restart=always가 결정적 실패를 안전하게 만들지 않는다.
처음부터 StartLimitBurst를 늘리거나 StartLimitIntervalSec=0으로 두지 않는다. 제한된 실패가 빠른 충돌 루프로 바뀔 수 있다. reset-failed도 수리가 아니라 원인을 고친 뒤 한 번 통제된 재시도를 하기 위해 실패 상태와 카운터를 지우는 명령이다.
2. 다시 시작하기 전에 증거 원장을 고정하기
시스템 유닛인지 사용자 유닛인지 기록하고 systemctl status, systemctl cat, systemctl show에서 FragmentPath, DropInPaths, User, Group, Type, ExecStart, WorkingDirectory, EnvironmentFiles, Restart, RestartUSec, StartLimitIntervalUSec, StartLimitBurst, NRestarts, Result를 저장한다. 사용자 유닛은 해당 로그인 환경에서 --user를 사용한다.
최신 거부 줄뿐 아니라 최초 실패 주변의 journal을 보존한다. journalctl -u UNIT로 시간을 좁히고 시간 해석이 문제라면 단조 시간도 남긴다. daemon-reload, 패키지 복구, drop-in 편집 전에 사본을 저장한다.
3. 재시작 루프 뒤의 최초 실패 찾기
“Scheduled restart job”과 “Start request repeated too quickly” 이전으로 읽어 최초의 구체적 오류에서 멈춘다. 종료 상태, 신호, 실행 파일 오류, 누락 경로, 권한 거부, 알 수 없는 사용자, 의존성 실패, 준비 시간 초과, watchdog 중 하나가 다음 분기를 결정한다.
프로세스가 즉시 종료되면 실제 ExecStart와 프로그램이 기대하는 포그라운드 동작을 비교한다. 안전한 진단만 설정 사용자, 작업 디렉터리, 필요한 환경에서 수행한다. 관리자 대화형 shell에서 성공한 것은 서비스 환경 성공의 증거가 아니다.
4. 실행 파일·계정·경로·의존성 증거로 분기하기
실행 실패는 절대 경로, 실행 비트, 인터프리터나 로더, 소유권, 마운트 정책을 확인한다. 계정 실패는 root로 바꾸지 말고 의도한 사용자나 그룹과 디렉터리 접근을 복원한다. 설정·환경 파일은 systemctl show와 WorkingDirectory의 유효 경로를 기준으로 본다.
의존성 실패는 종속 유닛을 반복 시작하지 말고 이름이 나온 선행 조건과 순서를 조사한다. network target이 정상이어도 원격 서비스, 마운트, socket, 자격 증명이 준비됐다는 뜻은 아니다. 의존 유닛의 status와 journal도 보존한다.
5. 유닛 유형·준비 상태·시간 창 확인하기
Type=을 프로세스 모델과 맞춘다. 포그라운드로 계속 실행되는 프로그램은 보통 Type=simple 또는 Type=exec, fork하는 프로그램은 올바른 모델과 필요할 때 신뢰 가능한 PIDFile, Type=notify는 준비 알림이 필요하다. 불일치는 자식 프로세스가 잠시 살아도 실패로 보이게 한다.
벽시계로 본 시작 수가 burst보다 적다면 유효 속성과 모든 drop-in을 먼저 확인하고 단조 시간이 포함된 journal을 비교한다. systemd 상류 사례는 suspend가 단조 시간 창을 더 길게 보이게 할 수 있음을 보여 준다. 이는 좁은 분기이지 보편적 설명이 아니다.
6. 한 번 고치고 한 번 초기화해 원래 경로 검증하기
최초 실패가 뒷받침하는 최소 수정만 한다. 유닛 파일이나 drop-in이 바뀐 경우에만 daemon-reload를 실행한다. systemctl reset-failed UNIT을 한 번, 통제된 시작을 한 번 수행하고 새 status와 journal을 본다. NRestarts가 늘지 않고 실제 준비 조건에 도달하는지 확인한다.
서비스가 안정된 뒤에만 측정된 일시 장애를 위해 RestartSec, StartLimitIntervalSec, StartLimitBurst를 조정한다. 유한한 한도와 이유를 남기고 OnFailure로 증거 수집이나 경고를 검토한다. 재시도 실패 시 새 최초 오류를 보존해 그 분기에서 계속한다.