テクノロジー · 実用ガイド
systemdの「start request repeated too quickly」:リセット前に最初の失敗を探す
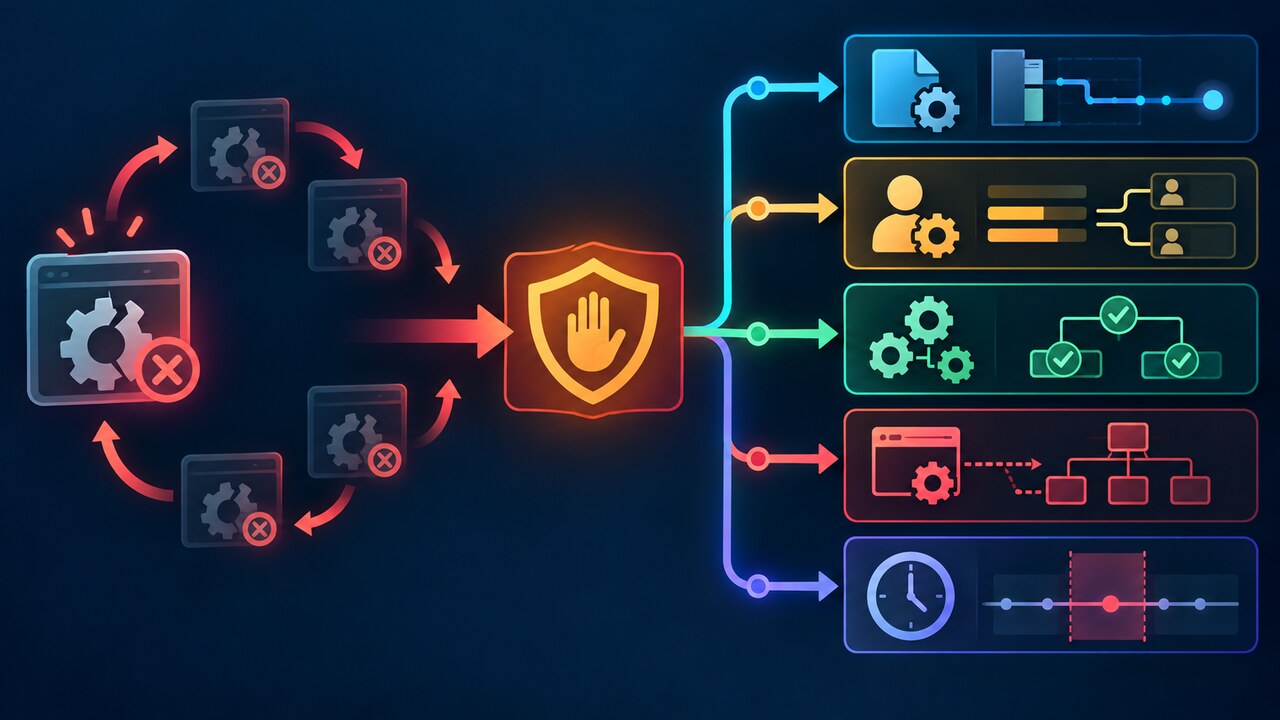
最後の起動制限メッセージは、多くの場合、原因ではなく安全装置です。有効なユニットと最初の失敗を保存し、証拠に沿って修正してからカウンターを消去します。
「start request repeated too quickly」は、設定された時間内の起動回数が上限を超え、systemdが次の起動を拒否したことを示す。制限は複数回の試行後に働くため、プロセスが最初に失敗した理由とは限らない。
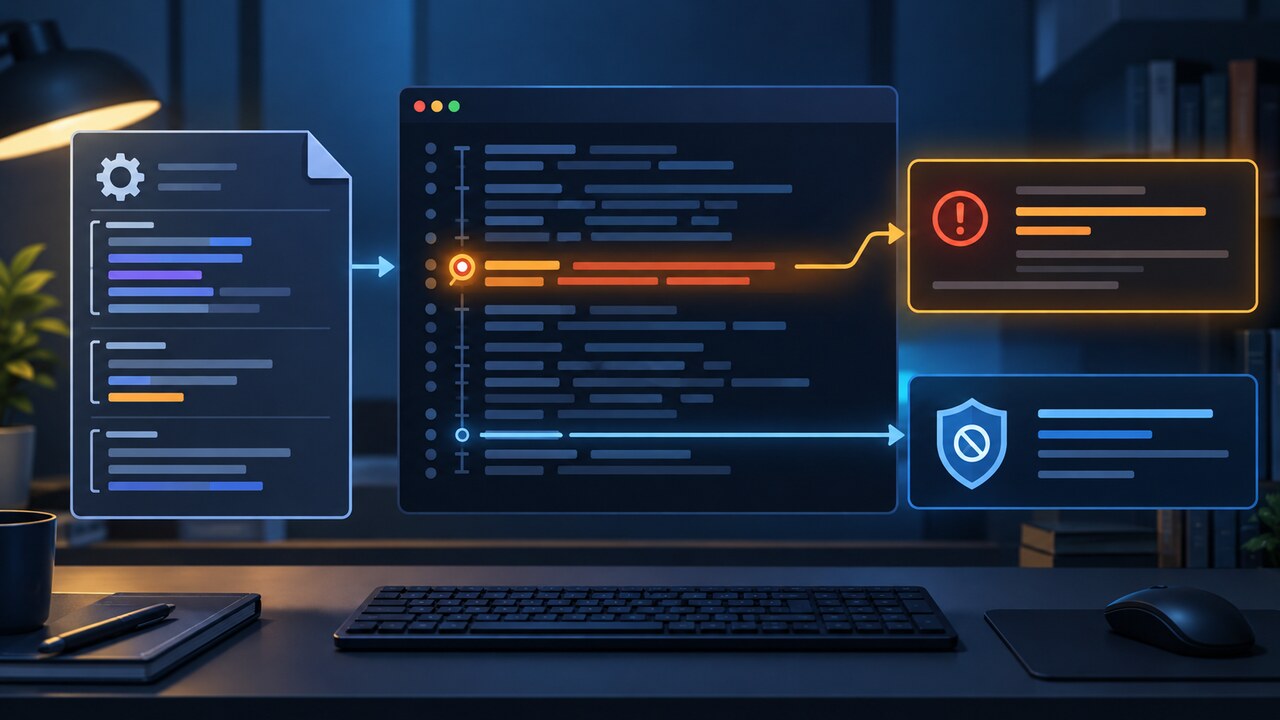
カウンターのリセット、上限緩和、再起動の前に、有効なユニットと最初の失敗ログを保存する。制限状態と、実行ファイル、実行ユーザー、パス、依存関係、ユニットモデルの証拠を分けて調べたい。
1. 拒否を原因ではなく安全装置として読む
systemdはユニットの起動回数を制限する。StartLimitIntervalSec内にStartLimitBurstを超えると次の起動が拒否され、Result=start-limit-hitになることがある。自動再起動も同じ境界に従うため、Restart=alwaysでも決定的障害は安全にならない。
最初にStartLimitBurstを増やしたりStartLimitIntervalSec=0にしたりしない。制御された失敗が高速なクラッシュループになり得る。reset-failedも修理ではなく、原因修正後に一度だけ試すため状態とカウンターを消す操作だ。
2. 次の起動前に証拠台帳を固定する
システムユニットかユーザーユニットかを記録し、systemctl status、systemctl cat、systemctl showからFragmentPath、DropInPaths、User、Group、Type、ExecStart、WorkingDirectory、EnvironmentFiles、Restart、RestartUSec、StartLimitIntervalUSec、StartLimitBurst、NRestarts、Resultを保存する。ユーザーユニットは該当ログイン環境で--userを付ける。
最新の拒否だけでなく最初の失敗付近のjournalを保存する。journalctl -u UNITで時間を絞り、時刻に疑問があれば単調時刻も残す。daemon-reloadやパッケージ修復、drop-in編集の前にコピーを取る。
3. 再起動ループの最初の失敗を見つける
「Scheduled restart job」「Start request repeated too quickly」より前へ読み、終了ステータス、シグナル、実行ファイル、パス欠落、権限拒否、不明ユーザー、依存失敗、ready timeout、watchdogの最初の具体的エラーで止める。その行が次の分岐を決める。
即時終了なら実際のExecStartとプログラムの前景動作を比較する。安全な診断だけを設定ユーザー、作業ディレクトリ、必要な環境で行う。管理者の対話shellで成功してもサービス環境で動く証明にはならない。
4. 実行ファイル、ID、パス、依存関係で分岐する
実行失敗では絶対パス、実行権、インタープリターやローダー、所有者、マウント方針を確認する。ID失敗はrootへ変えず、意図したユーザーやグループとディレクトリアクセスを復元する。設定や環境ファイルはsystemctl showとWorkingDirectoryの有効なパスを基準にする。
依存失敗では従属ユニットを連打せず、名前の出た前提と順序を調べる。network targetが正常でも、リモート先、マウント、socket、資格情報の準備は保証されない。依存側のstatusとjournalも保存する。
5. ユニット型、ready、時間窓を確認する
Type=をプロセスモデルに合わせる。前景で動き続けるものは通常Type=simpleまたはType=exec、forkするものは正しいモデルと必要なら信頼できるPIDFile、Type=notifyはready通知が必要だ。ずれがあると子プロセスが短時間生きても起動失敗と判断される。
壁時計で見た回数がburstより少ない場合、まず有効なプロパティと全drop-inを確認し、次に単調時刻付きjournalを比較する。上流事例ではサスペンドが単調時間の窓を壁時計より長く見せる。限定的な分岐であり万能な説明ではない。
6. 一度修正し、一度リセットして元の経路を証明する
最初の失敗が裏付ける最小の修正だけを行う。ユニットやdrop-inを変えた時だけdaemon-reloadを実行する。systemctl reset-failed UNITを一度、制御された起動を一度行い、新しいstatusとjournalを見る。NRestartsが増えず、本当のready条件に達することを確認する。
安定後に限り、実測済みの一時障害向けにRestartSec、StartLimitIntervalSec、StartLimitBurstを調整する。有界制限と理由を残し、OnFailureで証拠収集や通知も検討する。再失敗なら新しい最初のエラーを保存して続ける。