Tecnología · GUÍA PRÁCTICA
systemd dice “start request repeated too quickly”: busque el primer fallo antes de reiniciar
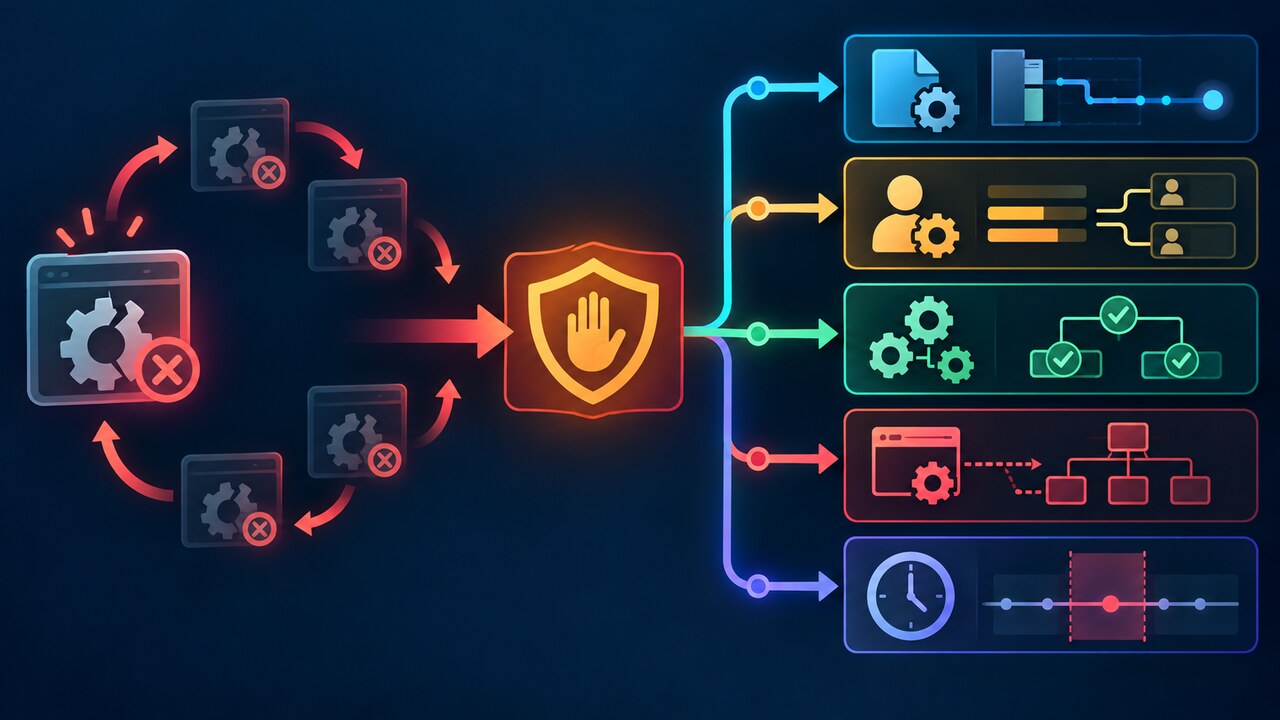
El último mensaje de límite suele ser la protección, no el defecto. Conserve la unidad efectiva y el primer intento fallido; repare la rama respaldada por pruebas antes de borrar contadores.
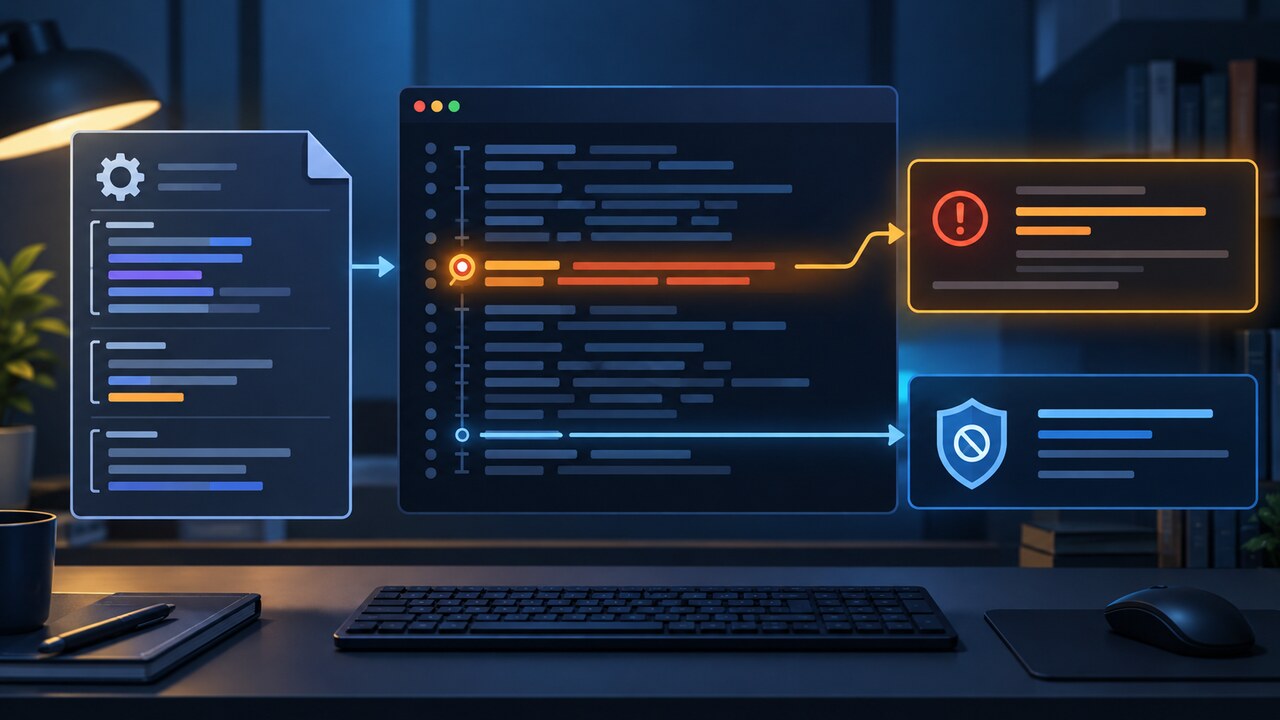
“start request repeated too quickly” significa que systemd rechazó otro inicio porque la unidad superó el límite configurado dentro de su ventana. El limitador actúa después de varios intentos y normalmente no identifica el defecto que hizo fallar primero al proceso.
Antes de reiniciar contadores, ampliar límites o seguir iniciando, conserve la unidad efectiva y la primera entrada fallida del journal. Separe el estado del límite de las pruebas sobre proceso, identidad, rutas, dependencias y modelo de unidad.
1. Leer el rechazo como protección, no como causa
systemd limita la tasa de activaciones. Si los inicios superan StartLimitBurst dentro de StartLimitIntervalSec, rechaza otra activación y puede mostrar Result=start-limit-hit. Los reinicios automáticos obedecen el mismo límite: Restart=always no vuelve seguro un fallo determinista.
No empiece aumentando StartLimitBurst ni poniendo StartLimitIntervalSec=0; un fallo acotado puede convertirse en un bucle rápido. reset-failed tampoco repara: borra el estado y el contador para permitir un intento controlado después de corregir la causa.
2. Congelar un registro de pruebas antes de otro inicio
Anote si la unidad pertenece al gestor del sistema o del usuario. Guarde systemctl status, systemctl cat y systemctl show con FragmentPath, DropInPaths, User, Group, Type, ExecStart, WorkingDirectory, EnvironmentFiles, Restart, RestartUSec, StartLimitIntervalUSec, StartLimitBurst, NRestarts y Result. Para una unidad de usuario use --user en la sesión afectada.
Capture el journal alrededor del primer intento fallido, no solo el rechazo más reciente. Limite journalctl -u UNIT por tiempo y conserve marcas monotónicas si se discute el reloj. Haga una copia antes de daemon-reload, reparar paquetes o editar drop-ins.
3. Encontrar el primer fallo detrás del bucle
Lea hacia atrás más allá de “Scheduled restart job” y “Start request repeated too quickly”. Deténgase en el primer fallo concreto: estado de salida, señal, error de ejecutable, ruta ausente, permiso, usuario desconocido, dependencia, espera de preparación o watchdog. Esa línea determina la siguiente rama.
Si el proceso termina de inmediato, compare ExecStart con el modo en primer plano previsto. Ejecute solo diagnósticos seguros como el usuario configurado, con el directorio y entorno requeridos. Que funcione en el shell interactivo de un administrador no demuestra que funcione como servicio.
4. Separar ejecutable, identidad, rutas y dependencias
En fallos de ejecución, verifique ruta absoluta, bit de ejecución, intérprete o cargador, propiedad y política de montaje. En fallos de identidad restaure el usuario o grupo previsto y su acceso, no cambie a root. Para archivos de configuración o entorno use las rutas efectivas de systemctl show y WorkingDirectory.
En fallos de dependencia inspeccione el requisito nombrado y el orden, no reinicie repetidamente la unidad dependiente. Un target de red activo no garantiza que un destino, montaje, socket o credencial esté listo. Conserve el estado y journal de la dependencia.
5. Comprobar tipo, preparación y ventana temporal
Haga coincidir Type= con el modelo del proceso. Un programa en primer plano suele encajar con Type=simple o Type=exec; uno que hace fork requiere el modelo correcto y, si procede, un PIDFile fiable; Type=notify necesita una notificación de preparación. Una discordancia puede parecer fallo aunque un hijo sobreviva brevemente.
Si el reloj de pared muestra menos inicios que el burst, revise primero las propiedades efectivas y todos los drop-ins. Después compare el journal con tiempo monotónico. Un caso upstream muestra que la suspensión puede alargar una ventana monotónica frente al razonamiento de reloj; es una rama limitada, no una explicación universal.
6. Reparar una vez, reiniciar una vez y verificar la ruta original
Haga la corrección mínima respaldada por el primer fallo. Ejecute daemon-reload solo si cambió unidades o drop-ins. Luego use systemctl reset-failed UNIT una vez, realice un inicio controlado y observe el estado y el nuevo journal. Verifique que NRestarts no suba y que el servicio alcance su condición real de preparación.
Solo cuando sea estable ajuste RestartSec, StartLimitIntervalSec o StartLimitBurst para fallos transitorios medidos. Mantenga límites acotados, documente la razón y considere OnFailure para recopilar pruebas. Si vuelve a fallar, conserve el nuevo primer error y siga esa rama.