テクノロジー · 実用ガイド
Shotcut の保存済みプレイリストを、同じクリップをまとめず CSV にする
繰り返しのサブクリップ、保存された表示名、元のトリム値を一つの表に保持します。タイムラインの依存ファイル一覧や削除リストとは区別してください。
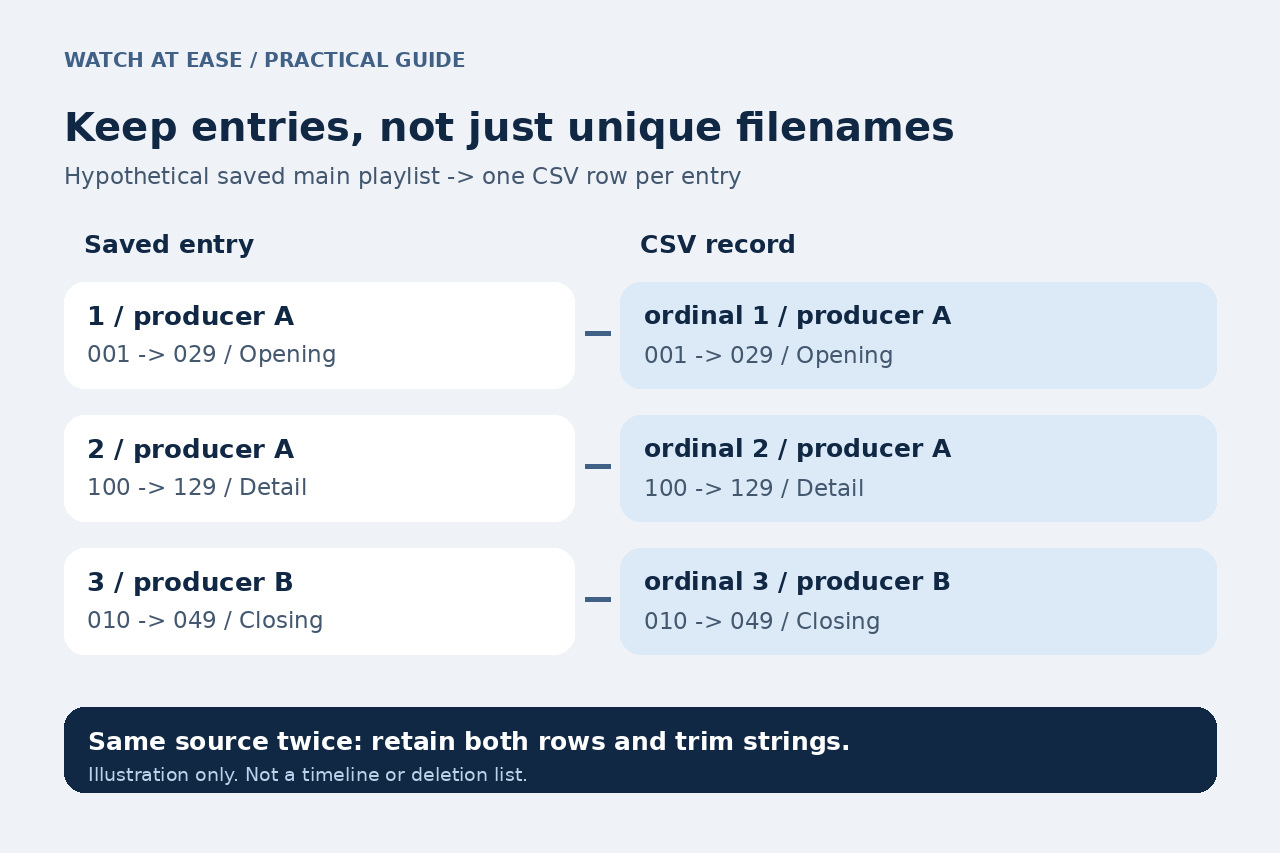
Shotcut のプレイリストから欲しい情報は、重複のないファイル名一覧では残らないことがあります。同じファイルを使う二つの項目でも、トリム位置は異なります。保存済みの一覧を表にするときは、各項目の順序と保存された表示名を残し、同じリソースにまとめないことが大切です。
Shotcut にはプレイリストのビンから動画を書き出す機能があり、現在の一括命名設定では元の名前も使えます。ここで追加するのは、自分の保存済みメインプレイリストを限定した形式でオフライン CSV にする方法です。対応する MLT のコピーを読み、プロジェクトを変更したりメディアを開いたりしません。動画の書き出しや削除可能ファイルの判定は行いません。
プロジェクトを保存し、一覧の種類を確認する
現在のプロジェクトを保存して閉じ、この表用に project.mlt という別のコピーを保管してください。自分の UTF-8 の通常の XML が対象です。最上位の main_bin プレイリスト、または旧表記 main bin が一つだけあり、直接の entry が最上位の producer または chain を参照する形に限ります。名前空間、入れ子や複合項目、空白項目、宣言付き XML は範囲外で、出力を作る前に停止します。
保存済みメインプレイリストの全項目を読みます。実行中の画面で選んだビン、検索フィルター、表示順は取得しません。現在のソースでは shotcut:bins が保存済みビンの文字列、shotcut:caption が表示名です。属性がなければ空セルになります。ファイル名による自動表示名、スマートビンへの所属、画面上の代替表示は再現しません。
動画ファイルが必要なら、Shotcut の Current Playlist Bin または Each Playlist Bin Item の標準書き出しを使ってください。重複のないリソース一覧なら既存の MLT Analyzer がダウンロードを提供しています。本稿は保存済み項目の順序と重複を残す別の出力です。移動したプロジェクトの修復やパスの変更はしません。
対応範囲内で CSV に変換する
Python 3 のある Linux Bash 端末で project.mlt のコピーがあるフォルダーに移動します。次のコマンドを一行としてコピーし、半角の引用符と逆スラッシュを保ってください。新しい出力名を選びます。既存の playlist.csv は上書きせず拒否します。この正確なコマンドを実行したのは Linux Bash だけで、Windows と macOS では検証していません。
XML パーサーはメインプレイリストの参照を producer または chain に解決し、その直下の選択した属性だけを読みます。フィルター自身の resource をクリップのリソースとは扱いません。最上位 ID の重複、参照先の欠落、対象属性の重複、非対応の entry 形状は CSV 作成前に停止します。
python3 -c 'exec('"'"'import csv, sys, xml.etree.ElementTree as E\nfrom pathlib import Path\nsrc, dst = map(Path, sys.argv[1:])\nraw = src.read_bytes()\ntext = raw.decode("utf-8-sig")\nif "<!DOCTYPE" in text.upper() or "<!ENTITY" in text.upper():\n raise ValueError("Own plain XML only; declarations unsupported")\nroot = E.fromstring(text)\nif root.tag != "mlt":\n raise ValueError("Expected unnamespaced mlt root")\nbins = [x for x in root if x.tag == "playlist" and x.get("id") in ("main_bin", "main bin")]\nif len(bins) != 1:\n raise ValueError("Need exactly one saved main playlist")\nobjects = {}\nfor x in root:\n if x.get("id"):\n if x.get("id") in objects:\n raise ValueError("Duplicate top-level ID")\n objects[x.get("id")] = x\nkeys = ["shotcut:caption", "shotcut:bins", "mlt_service", "resource", "shotcut:resource", "warp_resource", "shotcut:comment"]\nrows = []\nfor entry in bins[0]:\n if entry.tag == "property":\n continue\n if entry.tag != "entry" or len(entry):\n raise ValueError("Only direct referenced entries supported")\n pid = entry.get("producer", "")\n obj = objects.get(pid)\n if obj is None or obj.tag not in ("producer", "chain"):\n raise ValueError("Missing or composite producer reference")\n values = {}\n for prop in obj.findall("property"):\n name = prop.get("name")\n if name in keys:\n if name in values or len(prop):\n raise ValueError("Duplicate or nested selected property")\n values[name] = prop.get("value", prop.text or "")\n rows.append([str(len(rows)+1), pid, values.get(keys[0], ""), values.get(keys[1], ""), entry.get("in", ""), entry.get("out", "")] + [values.get(k, "") for k in keys[2:]])\nheader = ["ordinal", "producer_id", "caption", "bin_raw", "in_raw", "out_raw", "service", "resource_raw", "proxy_original_raw", "warp_resource_raw", "comment"]\nwith dst.open("x", encoding="utf-8-sig", newline="") as f:\n w = csv.writer(f)\n w.writerow(header)\n w.writerows(rows)\nwith dst.open(encoding="utf-8-sig", newline="") as f:\n if list(csv.reader(f)) != [header] + rows:\n raise ValueError("Readback mismatch; discard partial CSV")\nprint(str(len(rows)) + " saved playlist entries checked; not a timeline or deletion list")\n'"'"')' "project.mlt" "playlist.csv"
十一列を文字列として読む
列は ordinal、producer_id、caption、bin_raw、in_raw、out_raw、service、resource_raw、proxy_original_raw、warp_resource_raw、comment です。ordinal は保存順で 1 から始まります。表示名、ビン、コメントは保存された属性であり、ファイル名から推測した情報ではありません。空セルはこの手順で値が記録されなかったという意味で、未使用や破損を証明しません。
in_raw と out_raw は先頭のゼロを含む解析済み属性文字列をそのまま残し、欠けた境界は空欄にします。長さの計算、暗黙の境界の解決、再生範囲の検証はしません。MLT の値は表現形式とプロジェクトの状況に依存するため、秒として単純に引き算しないでください。XML のエスケープは解析時に復号されます。XML の綴りをバイト単位で再現する表ではありません。
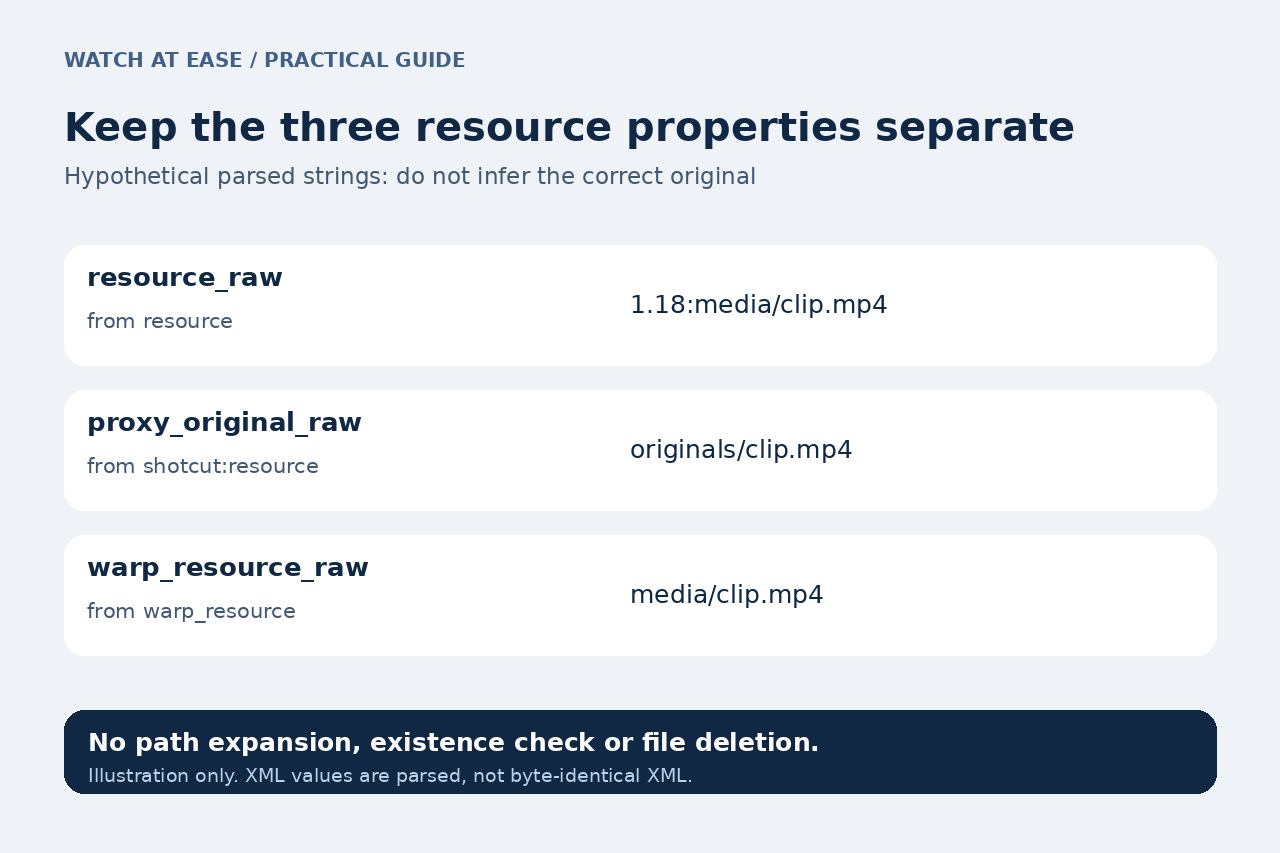
三つのリソース欄は分離したままです。resource_raw は resource、proxy_original_raw は shotcut:resource、warp_resource_raw は warp_resource を記録します。timewarp の resource には速度の接頭辞があり、プロキシ関連属性も異なることがあります。パスの展開、絶対パス化、存在確認、正しい原本の選択はしません。入れ子のプロジェクト、フィルター、マスク、LUT、画像連番の依存関係は巡回しません。
利用する前に各行を照合する
成功を表示する前に CSV を読み直し、ヘッダーと全フィールドを解析済み行と比較します。項目数を保存済みメインプレイリストと照合し、同じ素材の異なるトリム二つと、既知の独自表示名を確認してください。元の MLT と CSV 原本を保管し、絞り込みや引き継ぎメモは作業用コピーで行います。クレジット用の作者と利用許諾は別に確認してください。ファイル名や表示名では分かりません。
LibreOffice Calc では UTF-8、区切りはカンマ、文字列区切りは半角の二重引用符で取り込みます。十一列すべてをテキストにし、区切り文字の結合、空白の除去、数式の評価を無効にしてください。画面が出ない場合はフィルター設定の編集を有効にします。これにより確認用コピーで時刻文字列が日付に、コメントが数式として扱われるのを防ぎます。Calc の画面は実行していません。
この正確なコマンドで合成データの 21 ケースを実行しました。正常な六ケースには重複と順序、Unicode と XML エスケープ、速度・プロキシの生の属性、旧 ID、欠けた境界、空のビン、タイムラインやフィルターのリソースとの区別が含まれます。異常な十五ケースは出力作成前に停止しました。さらに正常出力の上書き六回を拒否し、入力と既存出力のバイトは不変でした。実際の Shotcut プロジェクト、再生、GUI、Windows、macOS は検証していません。書き込みや再読込に失敗したら部分 CSV を破棄して新しい名前でやり直し、この表をメディア削除の許可として使わないでください。