Tecnología · GUÍA PRÁCTICA
Exporta la lista Content de qBittorrent a CSV sin cambiar las descargas
Guarda la respuesta de archivos de un torrent y conserva índices, elementos excluidos y fracciones de progreso en una tabla comprobada.
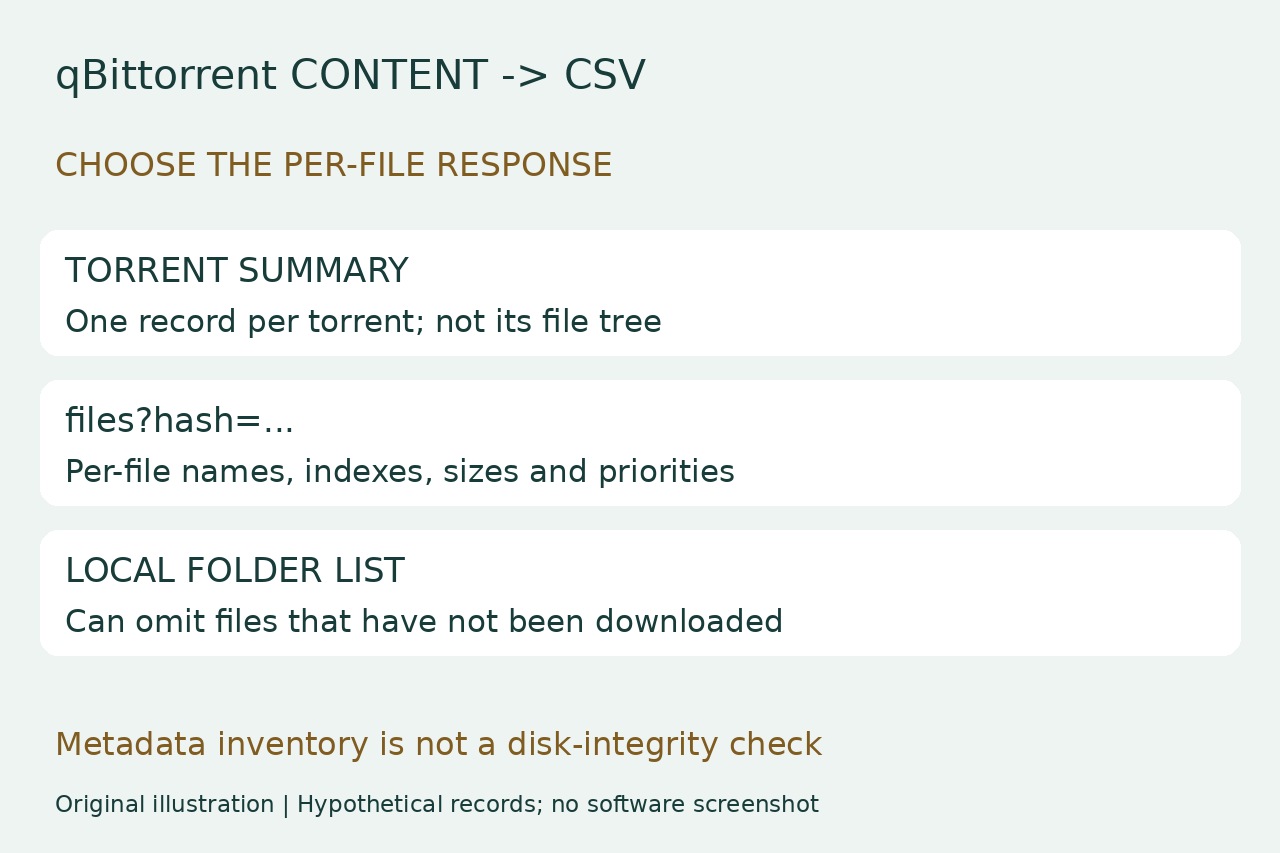
Una lista de nombres de torrents no enumera los archivos de un torrent. Para buscar un árbol Content grande en una hoja de cálculo, incluidos elementos marcados No descargar, usa la respuesta por archivo: un listado de carpetas puede omitir archivos aún no descargados.
Esta vía lee un torrent existente mediante una WebUI local ya configurada y autenticada, y convierte una copia JSON guardada sin conexión. No añade torrents, cambia prioridades, descarga contenido ni verifica archivos en disco.
Guarda la respuesta correcta de un torrent
Úsalo solo con tu propia instancia de qBittorrent 5 y una WebUI local donde ya puedas iniciar sesión normalmente. Mantén la autenticación y las protecciones. Si en el mismo ordenador está en http://127.0.0.1:8080, entra allí normalmente y sustituye el puerto por el real. Si no está configurada, detén este método; no expongas el servicio públicamente ni desactives la autenticación.
En el mismo navegador autenticado abre http://127.0.0.1:8080/api/v2/torrents/info, encuentra el nombre previsto y copia su campo hash. Comprueba el registro si hay nombres iguales. Después abre http://127.0.0.1:8080/api/v2/torrents/files?hash=YOUR_HASH reemplazando YOUR_HASH por ese valor exacto. Usa el mismo host y puerto del inicio de sesión y omite indexes para no limitar la respuesta a un subconjunto.
Guarda la respuesta JSON completa como files.json local, o copia toda la respuesta original a un archivo de texto UTF-8. Debe ser un array de objetos de archivo, no una página de acceso, marcado HTML del visor ni un array de resúmenes de torrents. Anota aparte la identidad y hora de captura. Un array vacío puede significar que faltan metadatos; un torrent inexistente o un fallo de autenticación no es un inventario vacío válido.
Convierte los registros guardados
Con Python 3 instalado, abre una terminal en esa carpeta; en Windows usa py -3 en vez de python3. Copia el comando en una línea con comillas rectas y elige un CSV nuevo. No uses la opción -O de Python. La validación termina antes de abrir la salida y la creación exclusiva rechaza un destino existente.
python3 -c "import csv,json,math,sys; r=json.load(open(sys.argv[1],encoding='utf-8-sig')); ok=lambda b:isinstance(b,dict) and type(b.get('index')) is int and b['index']>=0 and isinstance(b.get('name'),str) and type(b.get('size')) is int and b['size']>=0 and type(b.get('progress')) in (int,float) and math.isfinite(b['progress']) and 0<=b['progress']<=1 and type(b.get('priority')) is int and b['priority'] in (0,1,6,7); assert isinstance(r,list) and r and all(ok(b) for b in r) and len({b['index'] for b in r})==len(r), 'Expected nonempty unfiltered files array with unique indexes'; f=open(sys.argv[2],'x',encoding='utf-8-sig',newline=''); w=csv.writer(f); w.writerow(['index','name','size_bytes','progress_fraction','priority']); w.writerows([[b[k] for k in ('index','name','size','progress','priority')] for b in r]); f.close(); print(len(r),'file records exported')" "files.json" "content-files.csv"
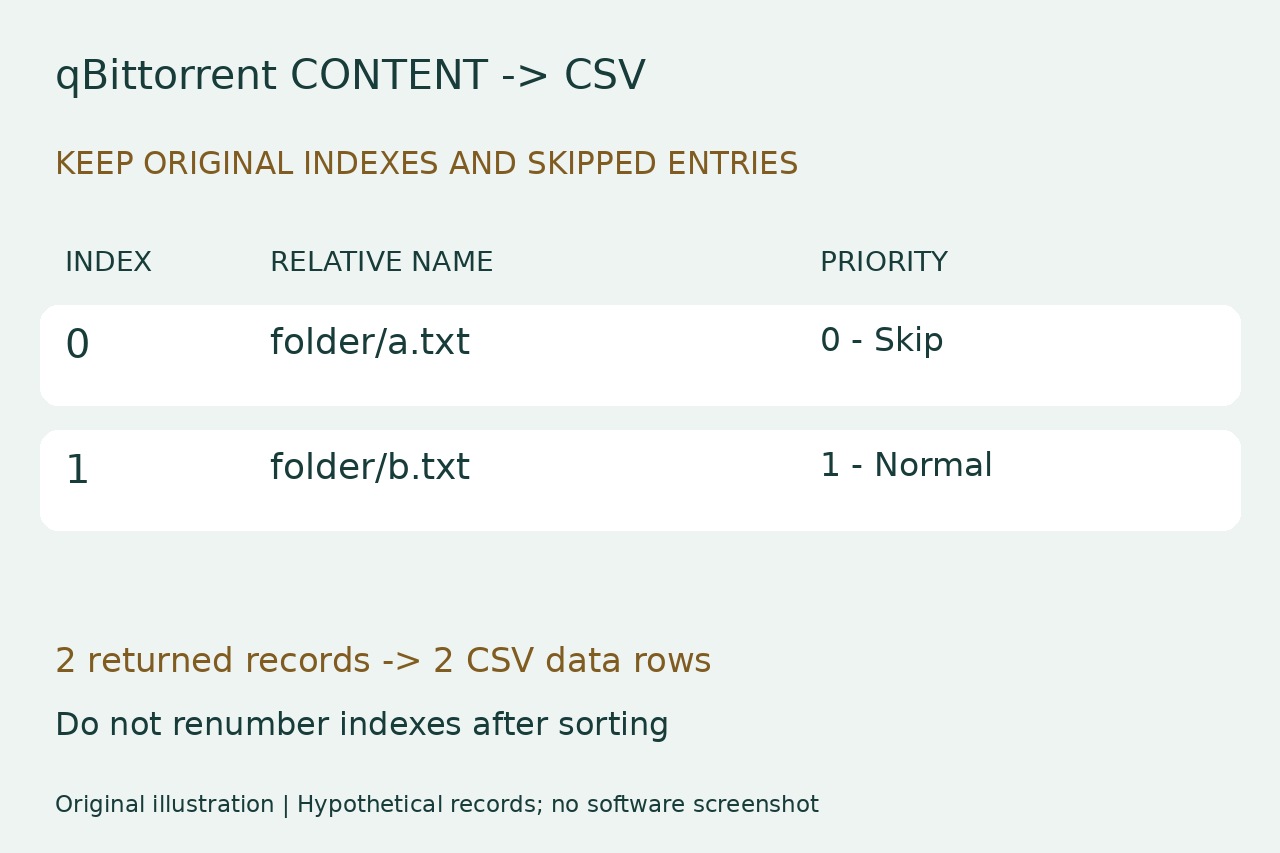
Las cinco columnas son index, name, size_bytes, progress_fraction y priority. index es el índice original, no un número de fila nuevo; no lo renumeres tras ordenar. name incluye la ruta relativa. Progreso 0.25 significa 25%, no 0.25%; prioridad 0 es No descargar, 1 normal, 6 alta y 7 máxima. Se conservan todos los registros devueltos, incluidos archivos excluidos, de cero bytes y nombres base repetidos.
Importa como texto y compara registros
En LibreOffice Calc elige Archivo > Abrir y Texto CSV. Selecciona UTF-8, coma y comillas dobles rectas como delimitador de texto. Desactiva Combinar delimitadores, Recortar espacios y Evaluar fórmulas; configura las cinco columnas como Texto. Si no aparece el diálogo, activa Editar configuración de filtros al abrir. Así conservas nombres y valores literales, sin convertir un nombre que empiece por = en fórmula.
Compara el recuento impreso con las filas de datos del CSV, sin cabecera. Un nombre entrecomillado puede contener saltos de línea, por lo que las líneas físicas no son el número de registros. Compara varias rutas relativas completas e índices originales con Content sin filtros, incluido un elemento excluido. Los índices 0 y 1 del dibujo son ficticios; el índice 0 identifica el primer archivo, no la cabecera del CSV ni un número nuevo de fila. Conserva un CSV maestro intacto antes de ordenar o filtrar una copia.
Entiende los errores y el alcance
Un error de validación indica una entrada vacía, malformada, índices duplicados o nombres, tamaños, progreso y prioridades ausentes o incompatibles. Comprueba la respuesta files exacta y los metadatos; no quites la validación para forzar un resultado. Si el destino existe, elige otro nombre. Un fallo de disco o escritura puede dejar un CSV parcial: no lo uses sin una nueva ejecución correcta y comprobaciones de filas interpretadas.
Es una lista de metadatos capturados del cliente, no prueba de existencia, integridad de bytes, disponibilidad de pares ni copia recuperable del estado de reanudación. Los elementos y el progreso pueden cambiar, y los nombres relativos no son rutas absolutas independientes. Ejecutamos 13 comprobaciones sintéticas del conversor con Unicode, comas, comillas, nombres multilínea, índices no consecutivos, duplicados, ceros, entradas inválidas y rechazo de sobrescritura. No ejecutamos qBittorrent real ni las interfaces del navegador o Calc. Conserva el JSON y las notas; comparte solo metadatos que quieras divulgar.