科技 · 實用指南
Python 出現 charmap UnicodeEncodeError?先稽核輸出接收端
在強制 UTF-8、改變全域模式或丟棄字元前,先證明哪個寫入器、目的地與消費端選了編碼。
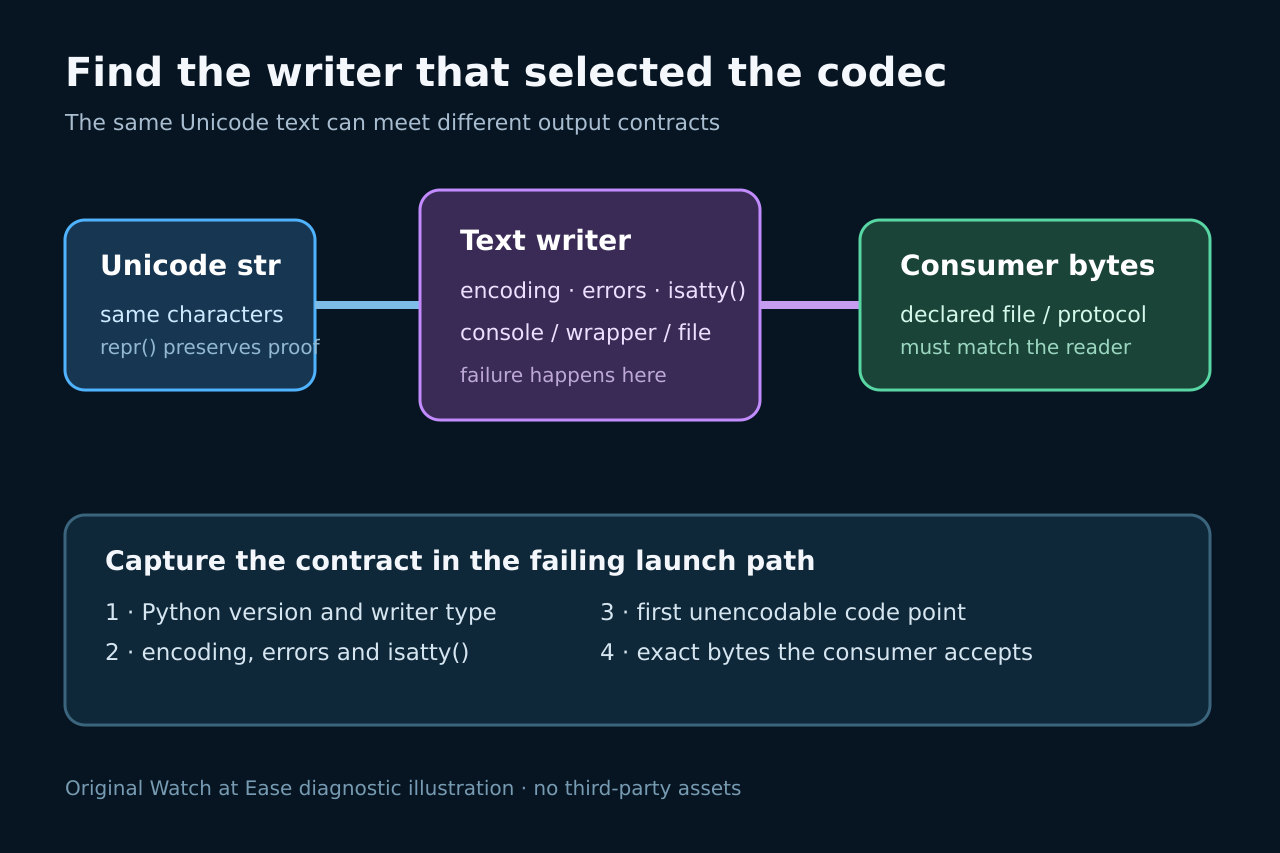
charmap UnicodeEncodeError 是輸出邊界故障:Python 的 Unicode 文字有效,但寫入器目前的編碼無法表示其中某個字元。
本稽核先找出真實接收端,區分主控台與重新導向,再把修正放到擁有格式的邊界並驗證消費端收到的位元組。
凍結故障接收端與執行期契約
保存完整命令、traceback、故障文字和 Python 版本。記錄 sys.stdout.encoding、sys.stdout.errors、sys.stdout.isatty();若檔案物件失敗,則記錄開啟方式與 encoding。例外中的 codec 說明該邊界實際使用的編碼器,不表示輸入已損壞。
以真實目的地重跑相同內容:互動主控台、Shell 重新導向、管線、IDE、排程工作或明確檔案。只在某一目的地失敗就是輸出契約改變的證據。用 repr() 或寫往 stderr 的跳脫診斷保存碼點,但不要改寫原資料。
分開文字、字元與編碼後位元組
Python str 是 Unicode 文字。UnicodeEncodeError 發生在文字寫入器把文字轉成位元組、而選定 codec 無法表示某字元時。print、寫文字檔與傳送 bytes 是不同邊界;應檢查型別、碼點及寫入器編碼,而非對已解碼文字再次 decode。
用完全相同的字元和目的地製作最小探針。檔案要用預期編碼明確開啟並讀回位元組;串流要寫入同一消費端並驗證其預期。必須證明邊界兩端:哪個編碼器產生位元組,以及哪個程式、格式或協定使用它們。
證明是 Windows 主控台、重新導向或包裝器改變編碼
Python 文件指出,標準串流編碼會隨主控台、檔案重新導向或替換包裝器而變。Windows 主控台裝置與非主控台檔案不一定走同一路徑;Microsoft 的主控台字碼頁只屬於主控台 I/O,並非所有檔案的通用編碼。
分別在主控台、重新導向以及故障 IDE 或服務執行同一命令,每次記錄三個執行期欄位。若 sys.stdout 被取代,檢查其型別與設定。不要只用 chcp 推論檔案編碼,也不要因終端成功就認定下游檔案是 UTF-8。
把修正交給擁有格式的邊界
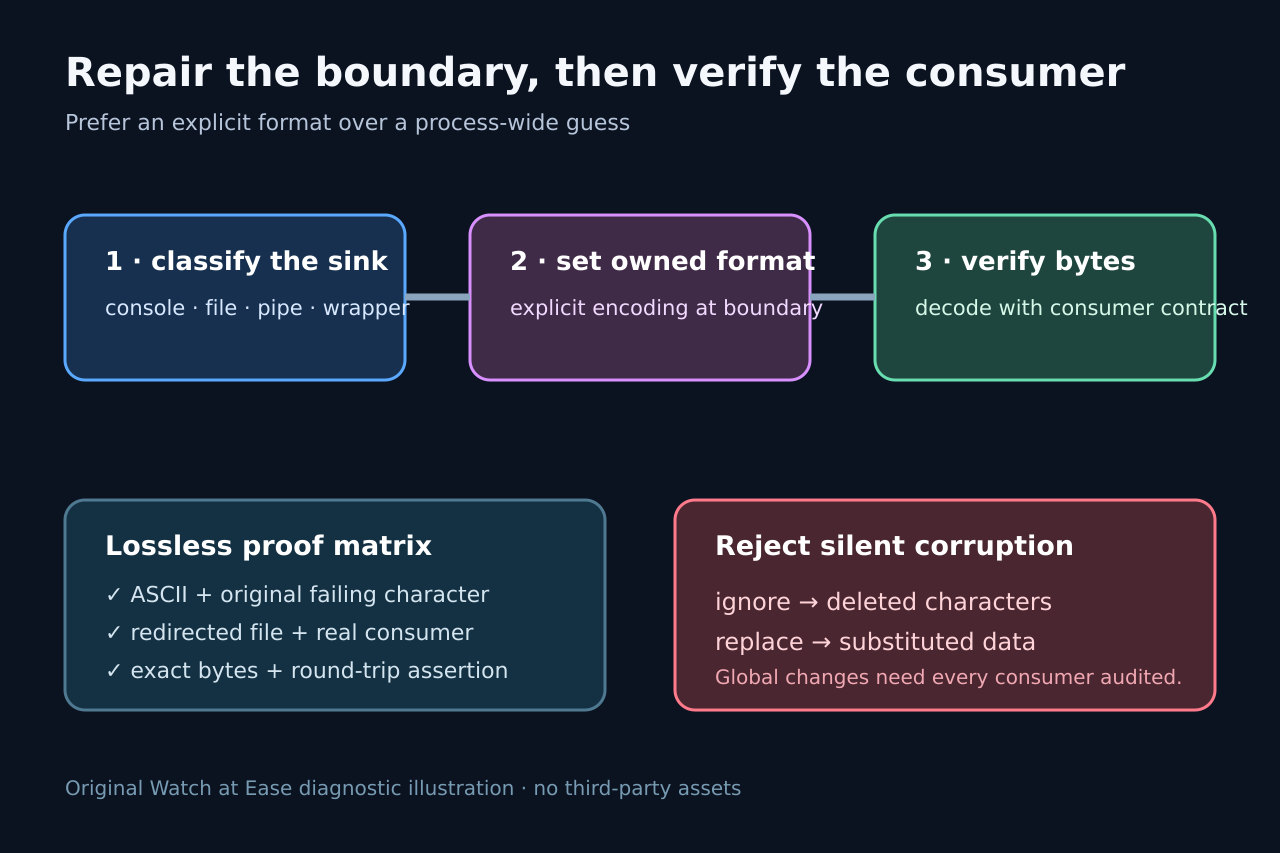
若程式建立 UTF-8 文字檔,請以 encoding=utf-8 明確開啟並記錄格式。若子程序預期 UTF-8,設定該邊界並驗證位元組。只有核對 stdout 與 stderr 的全部消費端後,擁有終端輸出的 CLI 才考慮 UTF-8 mode 或 PYTHONIOENCODING。
只有應用擁有標準串流且尚未輸出不相容緩衝資料時才用 sys.stdout.reconfigure()。函式庫不應暗中改寫宿主程式的全域策略;框架、Notebook 或測試器提供寫入器時,應設定該擁有者或寫到自己控制的邊界。
拒絕把有損抑制當成預設修正
errors='ignore' 會刪字元,errors='replace' 會替換資料;它們可能讓測試通過卻破壞姓名、路徑、識別碼或匯出記錄。只有輸出契約明確允許時才使用有損策略,並記錄會改變的字元。
不要先編成 UTF-8 再用無關舊編碼解碼,這只會把清楚的邊界錯誤變成亂碼或稍後失敗。改變系統 locale 或所有 Python 程序通常範圍過大;優先修正消費端契約已知、由目前元件擁有的最窄寫入器。
驗證位元組、消費端行為與回復
建立含 ASCII、原故障字元、本機字碼頁以外字元和混合語言行的矩陣,測試主控台、重新導向檔案與真實下游。記錄精確位元組或雜湊,以宣告格式解碼,並斷言消費端顯示或解析相同文字。
保留執行期欄位、故障樣本、所選邊界、編碼、錯誤策略和結果。回復只還原該寫入器,不影響其他串流。Python、Windows、IDE 或服務包裝器升級後重跑矩陣,因為預設值可能改變。