Tecnología · GUÍA PRÁCTICA
¿UnicodeEncodeError con charmap en Python? Audita primero el destino
Demuestra qué escritor, destino y consumidor eligieron el códec antes de forzar UTF-8, cambiar el modo global o descartar caracteres.
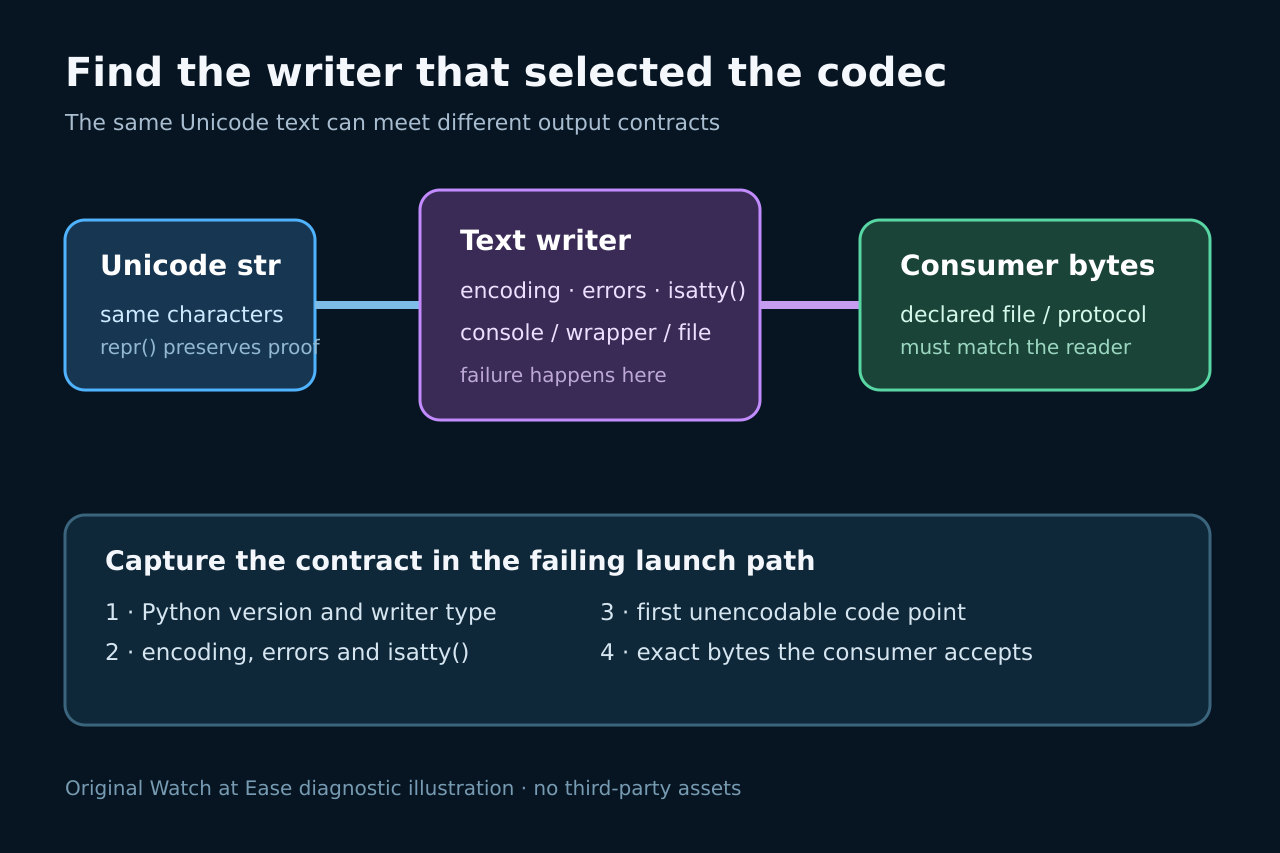
UnicodeEncodeError con charmap es un fallo de frontera de salida: el texto Unicode es válido, pero el códec activo del escritor no puede representar un carácter.
Esta auditoría identifica el destino real, separa consola y redirección, asigna la reparación al dueño del formato y verifica los bytes que recibe el consumidor.
Congela el destino y el contrato de ejecución
Guarda comando, traceback, texto y versión de Python. Registra sys.stdout.encoding, errors e isatty(); si falla un archivo, anota cómo se abrió y su encoding. El códec de la excepción identifica el encoder usado en esa frontera, no un daño en la entrada.
Repite la carga en el destino real: consola, redirección, tubería, IDE, tarea o archivo. Si solo falla uno, cambió el contrato. Conserva el primer code point con repr() o un diagnóstico escapado en stderr, sin sustituir los datos originales.
Separa texto, caracteres y bytes codificados
str es texto Unicode. UnicodeEncodeError surge cuando un escritor convierte texto a bytes y el códec no representa un carácter. print, escribir texto y enviar bytes son fronteras distintas. Inspecciona type(value), el code point y el encoding; no apliques decode() a texto ya decodificado.
Crea una prueba mínima con el mismo carácter y destino. Abre el archivo con el encoding previsto y vuelve a leer los bytes. Envía el stream al mismo consumidor y verifica su formato. Debes probar ambos lados: quién produce los bytes y qué programa, formato o protocolo los consume.
Demuestra la diferencia entre consola, redirección y wrapper en Windows
Python documenta que el encoding de los streams estándar depende de consola, redirección o wrapper. Los dispositivos de consola y archivos ordinarios de Windows no siempre siguen la misma ruta. Las páginas de código de Microsoft describen I/O de consola, no un encoding universal para todo archivo.
Compara el mismo comando en consola, redirección e IDE o servicio. Registra los tres campos. Si sys.stdout fue sustituido, inspecciona tipo y configuración. No deduzcas el encoding del archivo solo con chcp ni supongas UTF-8 porque la terminal funcionó.
Asigna la reparación al dueño del formato
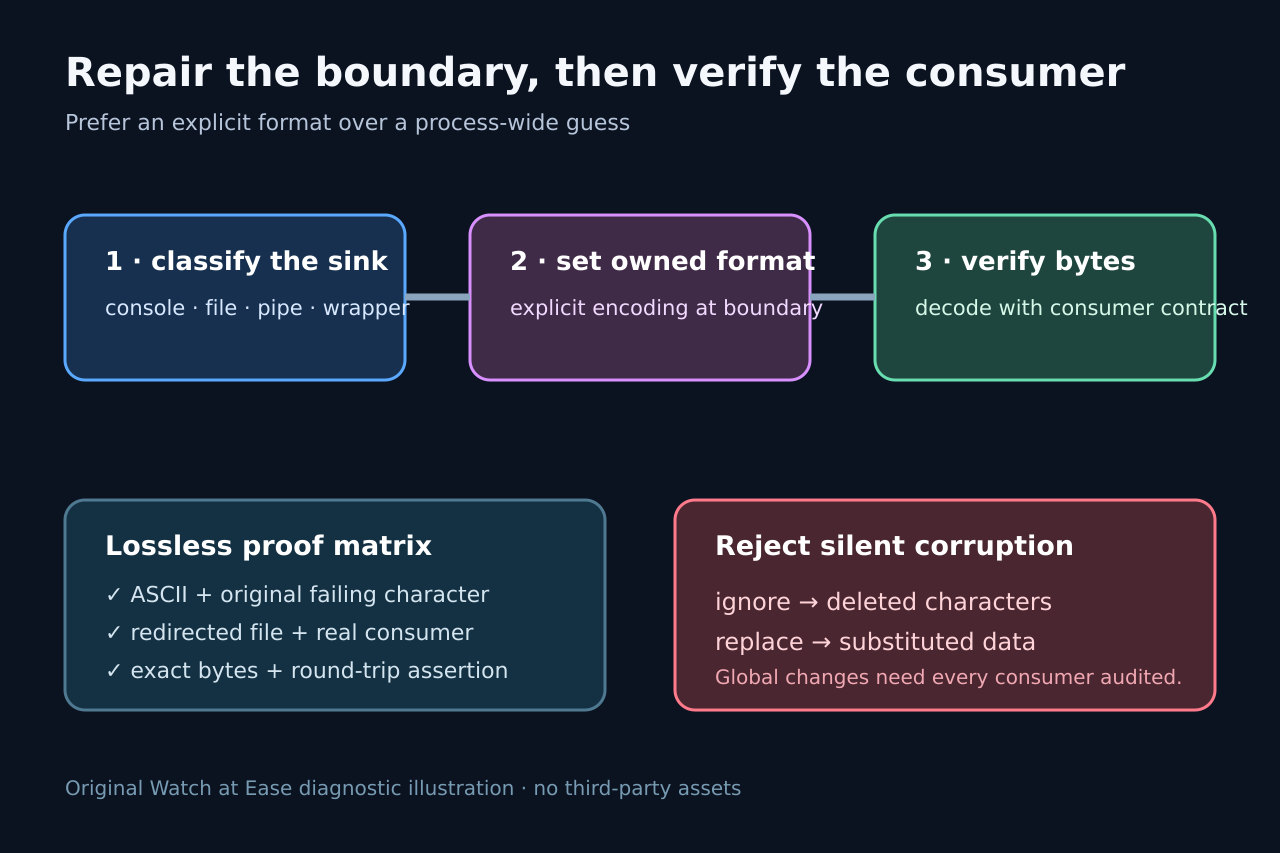
Si el programa crea un archivo UTF-8, ábrelo con encoding='utf-8' y documenta el formato. Si un subproceso espera UTF-8, configura esa frontera y verifica los bytes. Considera UTF-8 mode o PYTHONIOENCODING para un CLI solo tras revisar todos los consumidores de stdout y stderr.
Usa sys.stdout.reconfigure() solo si la aplicación posee el stream y aún no emitió datos bufferizados incompatibles. Una biblioteca no debe cambiar en secreto la política global del host. Si un framework, notebook o runner aporta el escritor, configura a ese dueño.
No conviertas la supresión con pérdida en arreglo predeterminado
errors='ignore' borra caracteres y errors='replace' sustituye datos. Pueden aprobar una prueba mientras corrompen nombres, rutas, identificadores o exportaciones. Úsalos solo si el contrato lo permite y registra qué caracteres cambian.
No codifiques en UTF-8 para decodificar de inmediato con un códec heredado distinto: convierte un error claro en mojibake. Cambiar locale o todos los procesos suele ser demasiado amplio. Prefiere el escritor más estrecho cuyo contrato de consumo conozcas.
Verifica bytes, consumidor y reversión
Construye una matriz con ASCII, el carácter original, otro fuera de la página local y una línea multilingüe. Prueba consola, archivo redirigido y consumidor real. Registra bytes o hash, decodifica con el formato declarado y confirma el mismo texto.
Conserva campos de runtime, muestra, frontera, encoding, política y resultado. Revierte solo la configuración del escritor, sin tocar otros streams. Repite la matriz tras actualizar Python, Windows, IDE o wrappers porque los valores predeterminados pueden cambiar.