Tecnología · GUÍA PRÁCTICA
¿UnicodeDecodeError: invalid start byte en Python? Conserva los bytes antes de elegir codificación
La excepción identifica el decodificador que falló, no la codificación que debes adivinar. Conserva la entrada, clasifica texto o binario y valida una decodificación estricta.
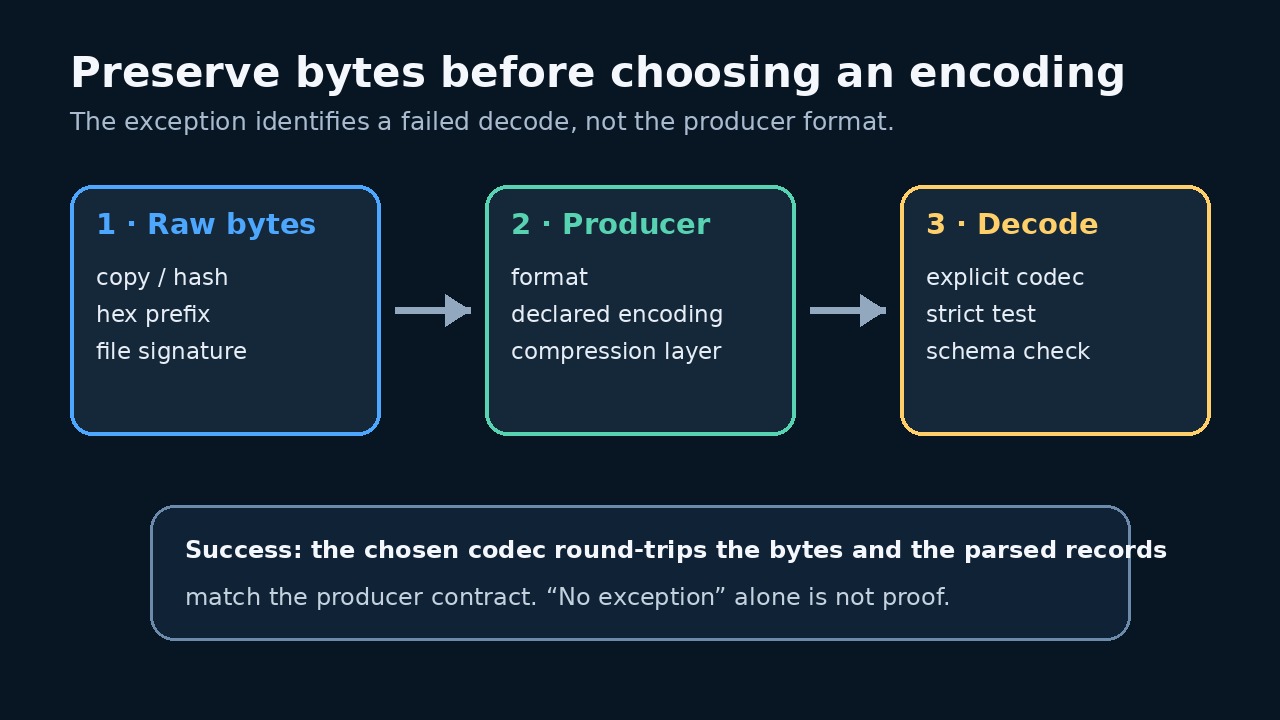
invalid start byte es un intento de decodificación fallido, no una orden para probar latin-1 o ignorar errores. Conserva los bytes y averigua el productor, contenedor y protocolo.
Congela los bytes exactos y el contexto
Copia o calcula el hash del original antes de abrirlo en un editor. Lee una muestra en modo binario y anota el comando de origen, tamaño, primeros bytes, desplazamiento del fallo, versión de Python y nombre exacto del códec. Un editor, importador o tubería puede haber cambiado saltos o bytes; diagnostica la copia más temprana sin modificar.
UnicodeDecodeError solo indica que el decodificador elegido rechazó una secuencia. No detecta la codificación. El mismo byte puede ser inválido en UTF-8, válido en otra codificación documentada, parte de una cabecera ZIP o de imagen, o señal de una transferencia truncada.
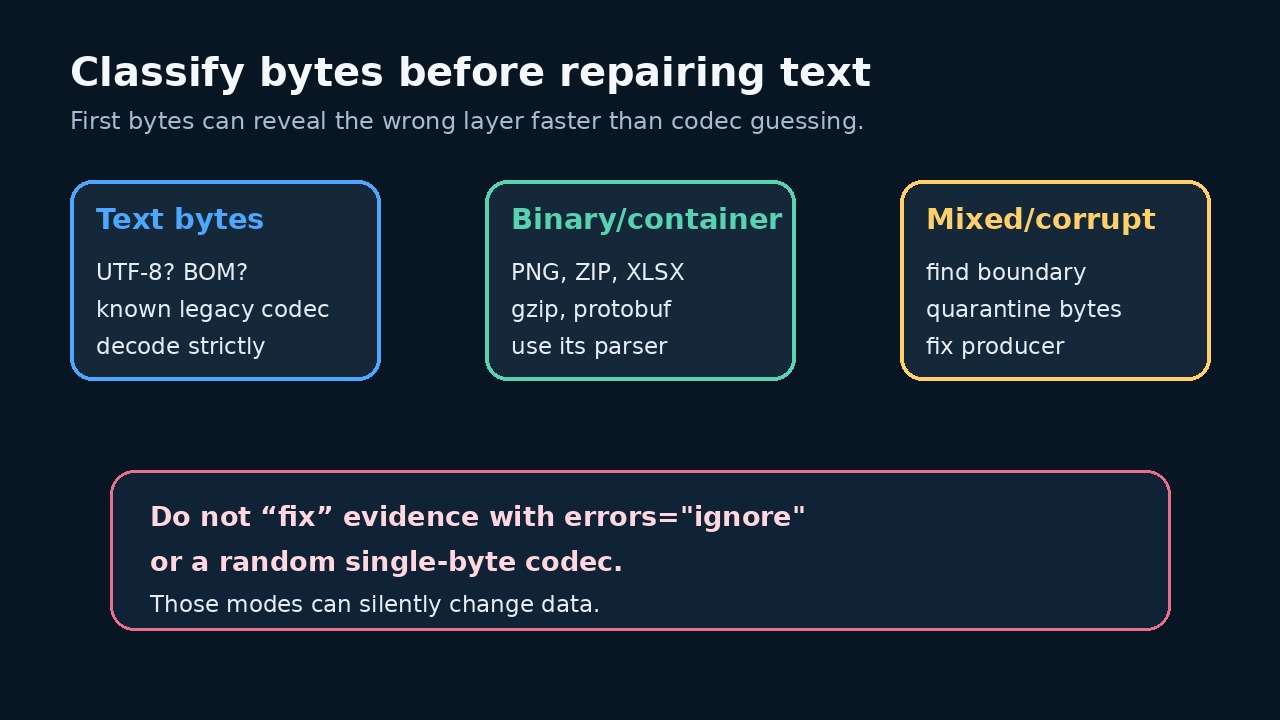
Decide si la carga es texto
Comprueba productor y contenedor antes de probar códecs. Bytes mágicos, archivos, salida comprimida, paquetes XLSX, imágenes o protocolos binarios necesitan primero su analizador. Cambiar la extensión o decodificar el contenedor como texto no revela los registros internos.
Si el productor promete texto, toma la codificación del protocolo, opción de exportación, cabecera HTTP, controlador de base de datos o documentación del comando. Un BOM puede apoyar algunas codificaciones Unicode, pero su ausencia no identifica ninguna; si existe, debe manejarlo el códec apropiado.
Prueba estrictamente un solo códec con evidencia
Decodifica una muestra conservada y luego el flujo completo con el único códec respaldado por el contrato del productor. Mantén errors=strict al establecer corrección. Decodificar sin error es necesario pero no suficiente: valida delimitadores, recuentos, campos y reglas, pues un códec permisivo puede mapear cada byte sin producir texto correcto.
Si falla la decodificación estricta, compara el desplazamiento con los bytes y límites anteriores. Vuelve a obtener o exportar si el archivo termina a mitad de secuencia, mezcla codificaciones, contiene un segmento binario o concatena productores. No recorras códecs hasta que alguno deje de fallar.
Usa controladores de error con un fin declarado
errors=ignore descarta datos y errors=replace inserta un carácter de sustitución; ambos cambian el contenido. Pueden crear una vista legible si la pérdida está permitida, pero no prueban una reparación. Conserva los bytes, cuenta cada tramo afectado y separa la salida con pérdida.
backslashreplace hace visibles los bytes problemáticos en un diagnóstico. surrogateescape sirve en recorridos limitados de ida y vuelta: representa bytes no decodificados en una cadena Python y los recupera con el mismo controlador. Ninguno identifica los caracteres previstos; documenta el límite y no envíes sustitutos a sistemas que exigen Unicode válido.
Cierra con una conversión verificable
Una reparación válida nombra productor, contenedor, codificación y analizador; decodifica estrictamente toda la entrada; valida los registros y escribe una salida nueva sin sobrescribir la evidencia. Guarda hashes, recuentos y rangos aislados para que otra persona reproduzca la decisión.
Detente y escala si se desconoce el contrato, el archivo mezcla codificaciones, no puede reconstruirse el límite binario o la sustitución alteraría identificadores, dinero, medidas o auditoría. Conservar la incertidumbre es más seguro que publicar caracteres plausibles pero inventados.